読み方 : クラスターぶんせき
クラスター分析【cluster analysis】データクラスタリング
別名 :data clustering/クラスタ解析
概要
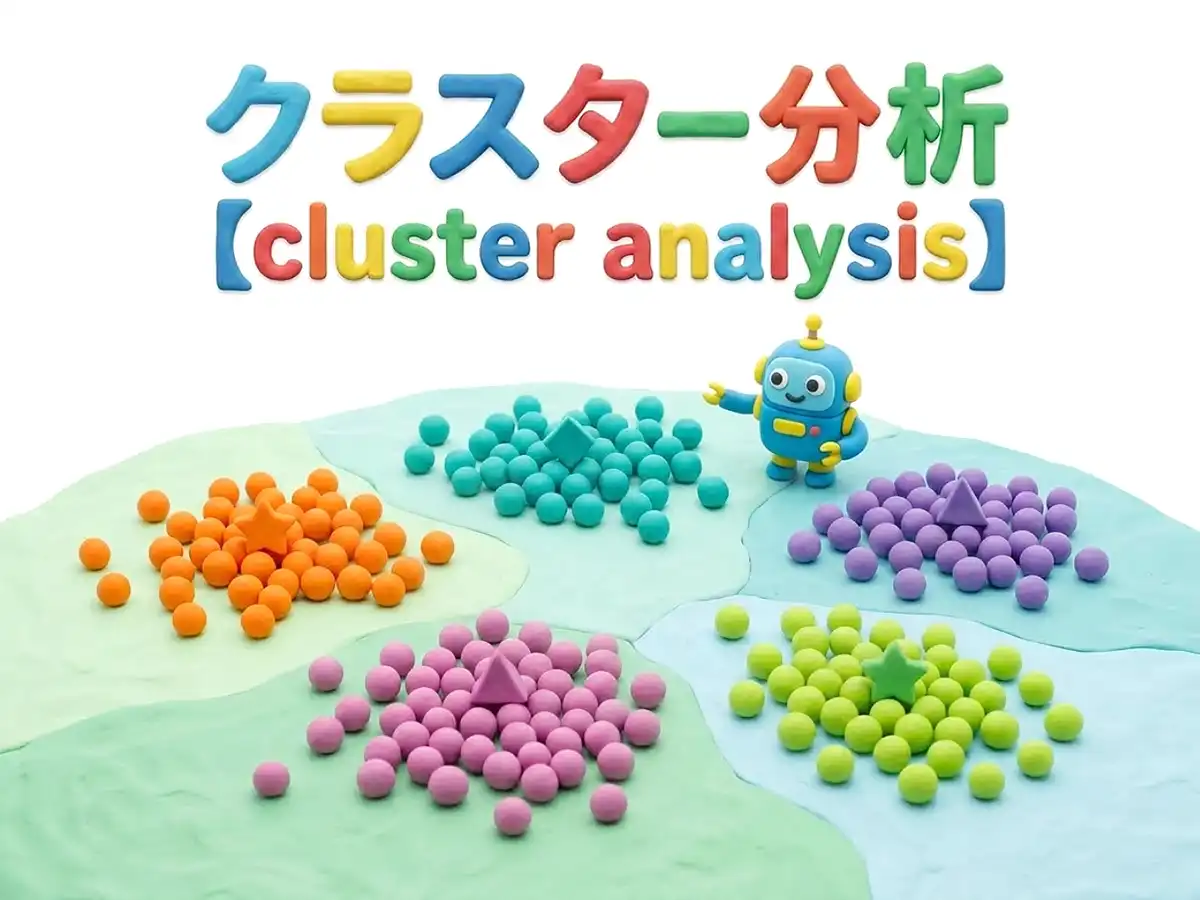
分類の基準となるのは、対象間に定義された「距離」である。数値データであれば、多次元空間上の直線的な近さを測る「ユークリッド距離」がよく用いられる。他にも「マンハッタン距離」(市街地距離)「マハラノビス距離」「コサイン類似度」など、データの種類や目的に応じた尺度が使い分けられる。
手法は大きく階層的手法と非階層的手法に分かれる。階層的手法は、距離の近いデータ同士を順次結合して樹形図(デンドログラム)を生成する方法で、「最短距離法」「最長距離法」「ウォード法」「群平均法」などがある。データ数が少ない場合に適しており、分類の過程を視覚的に確認しやすい。一方、非階層的手法はあらかじめクラスター数を指定して分類を行う方法で、「k平均法」(k-means法)が代表的である。計算効率がよく、大規模データにも適用しやすいため、マーケティングにおける顧客セグメンテーションなどで広く利用されている。
クラスター分析は様々な分野のデータ解析に応用される。購買履歴や行動データから類似する顧客層をまとめて販促戦略に活かしたり、遺伝子発現データを分類して疾患のサブタイプを探索したり、テキストマイニングで類似文書を整理したりする用途がある。正解データを必要としないため、未知のパターンや構造を発見する探索的な分析に向いている。
分析精度はデータの前処理に大きく左右される。変数のスケールが異なる場合には正規化や標準化が必要であり、外れ値がクラスター形成に影響を及ぼすこともある。また、クラスター数の設定に明確な正解が存在しないことも多く、結果の解釈には分析目的に応じた判断が求められる。
(2026.5.21更新)
関連用語


他の辞典等による「クラスター分析」の解説 (外部サイト)
- ウィキペディア「クラスター分析」

- ITmedia エンタープライズ 情報システム用語事典「クラスター分析」
- SynergyMarketing マーケティング用語集「クラスター分析」
- Techopedia (英語)「Cluster Analysis」
 共有ボタンをタップ