B+木インデックス【B+ tree index】
概要
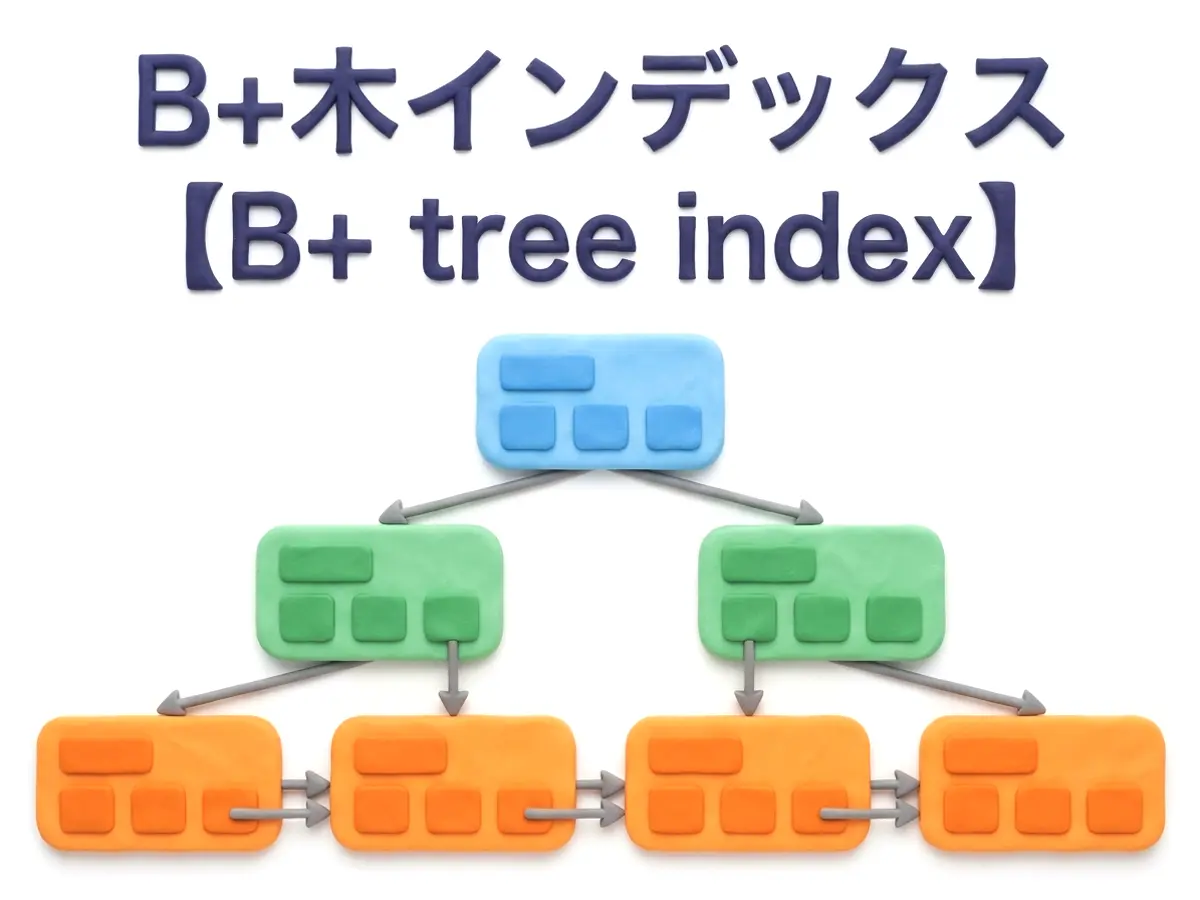
B+木は木構造(ツリー)の一種で、根ノード、中間ノード、葉ノードからなる階層構造になっている。B+木インデックスではデータそのものやデータへの参照は最下層の葉ノードのみに格納され、それ以外のノードには検索の道筋を示すキー情報のみが保持される。
検索を行う際は根ノードから出発し、各ノードのキーの大小関係を比較しながら下位のノードへと進み、最終的に目的のデータがある葉ノードに到達する。木の高さは常にほぼ一定に保たれるため、データ件数が増えても辿るノードの数は大きく変わらず、応答時間が安定する。
葉ノード同士は連結リストの形でつながっている。この構造により、ある範囲に含まれるデータをまとめて取り出す範囲検索では、開始位置の葉ノードを見つけた後、根ノードに戻らず連結リストを順に辿るだけで済む。完全一致検索だけでなく、範囲検索や前方一致検索、キー順での結果の読み出しなども効率的に処理できる。
データの追加や削除が行われると、ノード内のデータ量に偏りが生じることがある。その場合はノードの分割や隣接ノードとの統合によって木のバランスが自動的に調整され、データ件数が増減しても検索効率を保つ。一方で、この再調整には一定の処理負荷が伴うため、書き込みが頻繁な列に索引を設定する際には検索頻度との兼ね合いを考慮する必要がある。
MySQLのInnoDBやPostgreSQL、Oracle Databaseなど、多くのデータベース製品がテーブルの索引構造としてB+木を内部的に採用している。列に索引を作成する操作を行うと、その裏側ではB+木の構築と管理がデータベース管理システムによって自動的に行われる。ただし、データベース管理システムやストレージエンジンによって実際の構造やデータの格納方法の詳細は異なる場合がある。


 共有ボタンをタップ