読み方 : がくしゅうデータ
学習データ【training data】
概要
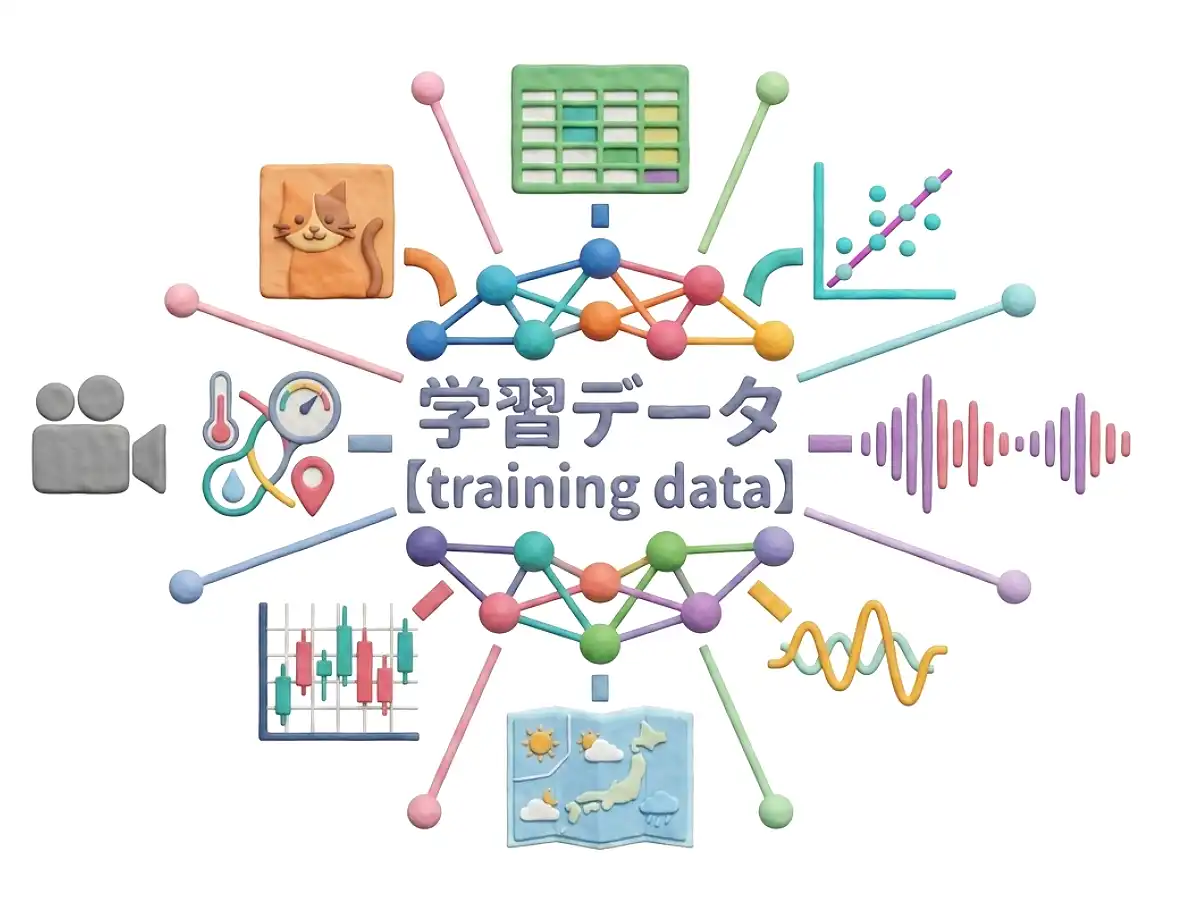
学習データのうち、モデルに与える入力データと、望ましい出力をセットにしたものを「教師データ」と呼び、このようなデータを用いる学習手法を「教師あり学習」という。モデルは入力データから望ましい出力が得られるように内部のパラメータを更新していく。
一方、正解を示すラベルなどを用意せず、ただ入力データのみを与え続ける学習手法もあり、「教師なし学習」という。データそのものの構造や類似性をモデルに分析させる手法で、ラベルを付与する手間が省ける。また、「強化学習」という手法では、試行錯誤を通じて得られる結果や評価をもとにモデルが行動を調整していくため、あらかじめ学習データを用意しない場合がある。
モデルの性能向上には十分な量の学習データが必要になるが、単に多ければよいわけではない。誤りや偏りを含むデータで学習させると、モデルはその偏りをそのまま反映してしまい、実際の運用場面で不正確な判断を下す原因になる。また、学習データに過剰に適合し、未知のデータへの対応力を失う「過学習」(overfitting)という現象を引き起こすこともある。収集したデータをそのまま用いるのではなく、重複や誤りを取り除く前処理を行った上で学習に使用するのが一般的である。
機械学習モデルの構築では、用意した一つのデータセットを学習データ、検証データ、テストデータなどに分割して用いることが多い。同一の種類・形式のデータを使って、学習データでモデルのパラメータを調整し、検証データで学習途中の性能を確認した後、テストデータで未知のデータに対する性能を評価する。これにより、学習に使ったデータだけでなく、学習時には見ていない未知データに対しても適切に予測できるかどうかを確かめることができる。
(2026.8.28更新)


 共有ボタンをタップ