読み方 : かかりうけかいせき
係り受け解析【dependency parsing】
概要
係り受け解析とは、自然言語処理の解析手法の一つで、文章を構成する単語や文節の間で、どの語がどの語にかかっているかという修飾関係を特定し、文の構造を明らかにするもの。文法的なつながりを機械的に解析することで、単語の並びにすぎなかった文章から意味を読み解くための土台を作り出す処理である。
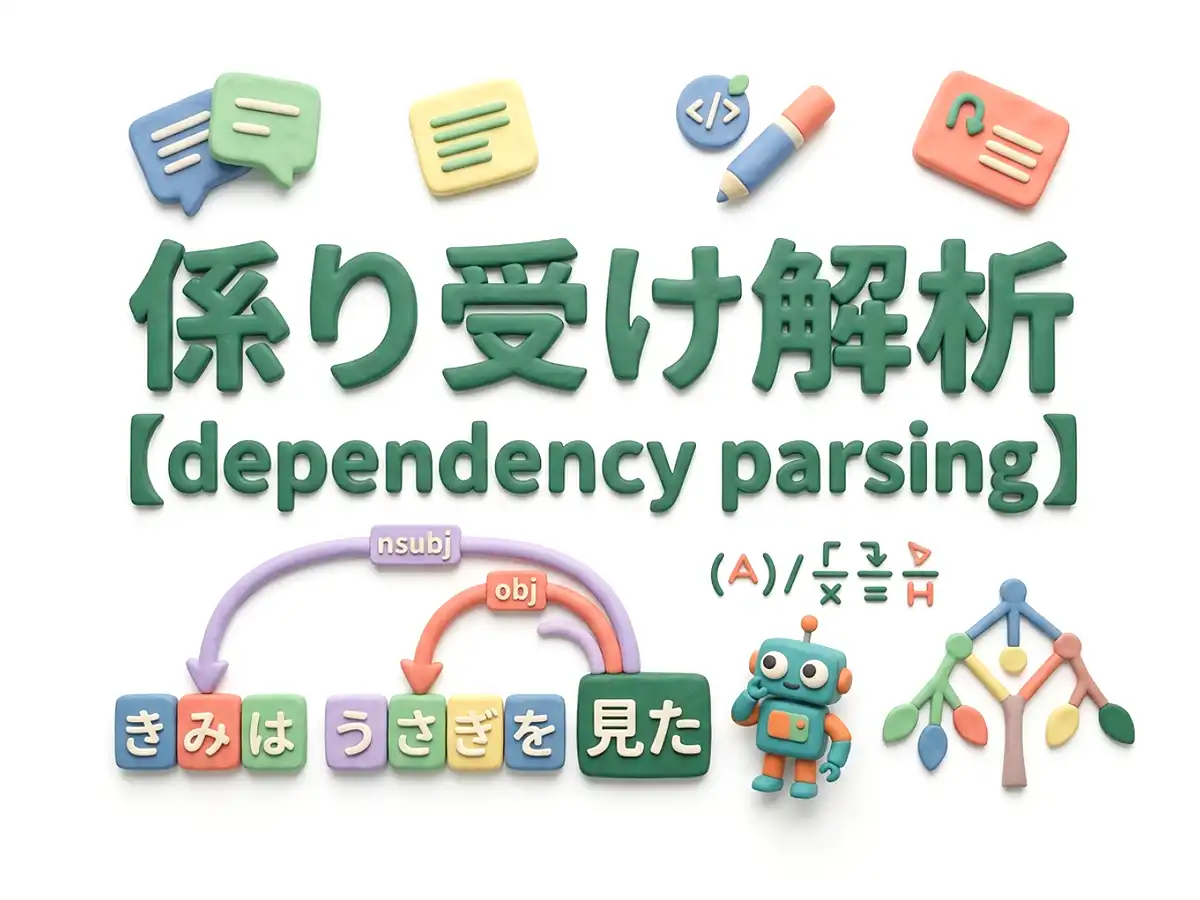
日本語の解析では、まず形態素解析によって文を単語に分解した上で文節に区切り、各文節がどの文節にかかっているかを判定する。例えば、「大きな黒い犬が走る」という文では、「大きな」と「黒い」が「犬が」を修飾し、「犬が」が「走る」にかかる。日本語は係る文節が係り先より前に置かれるため、後方にある文節を候補として解析が進められる。
解析においては、文節の品詞や助詞、活用形、文節間の距離といった情報が手掛かりとして用いられる。あらかじめ係り受け情報を付与した文章データを基に、各係り受けが成立する確率を学習し、文全体として最も妥当な構造を選択する統計的な手法も研究されてきた。こうした処理により、文中の係り関係を樹木状の階層構造として表現することが可能になる。
係り受け解析は、文章の意味そのものを判定する処理ではなく、あくまで文法的な構造を明らかにする処理である。そのため、文法上は成立していても意味として不自然な係り受けを完全に排除できるとは限らず、意味の解釈には別の処理が必要になる場合がある。
解析結果は、機械翻訳や文章の自動要約、質問応答システム、対話型AIの応答生成、検索エンジンにおける文意の把握など、文の構造を利用する様々な処理で活用されている。文章の曖昧さを取り除き、単語同士の正確なつながりを明確にすることで、より高度な意味解析や文脈解析を行うための基礎として機能している。日本語の係り受け解析を行うソフトウェアとしては「CaboCha」や「GiNZA」などが知られている。
(2026.8.29更新)


 共有ボタンをタップ