コンテキストエンジニアリング【context engineering】
概要
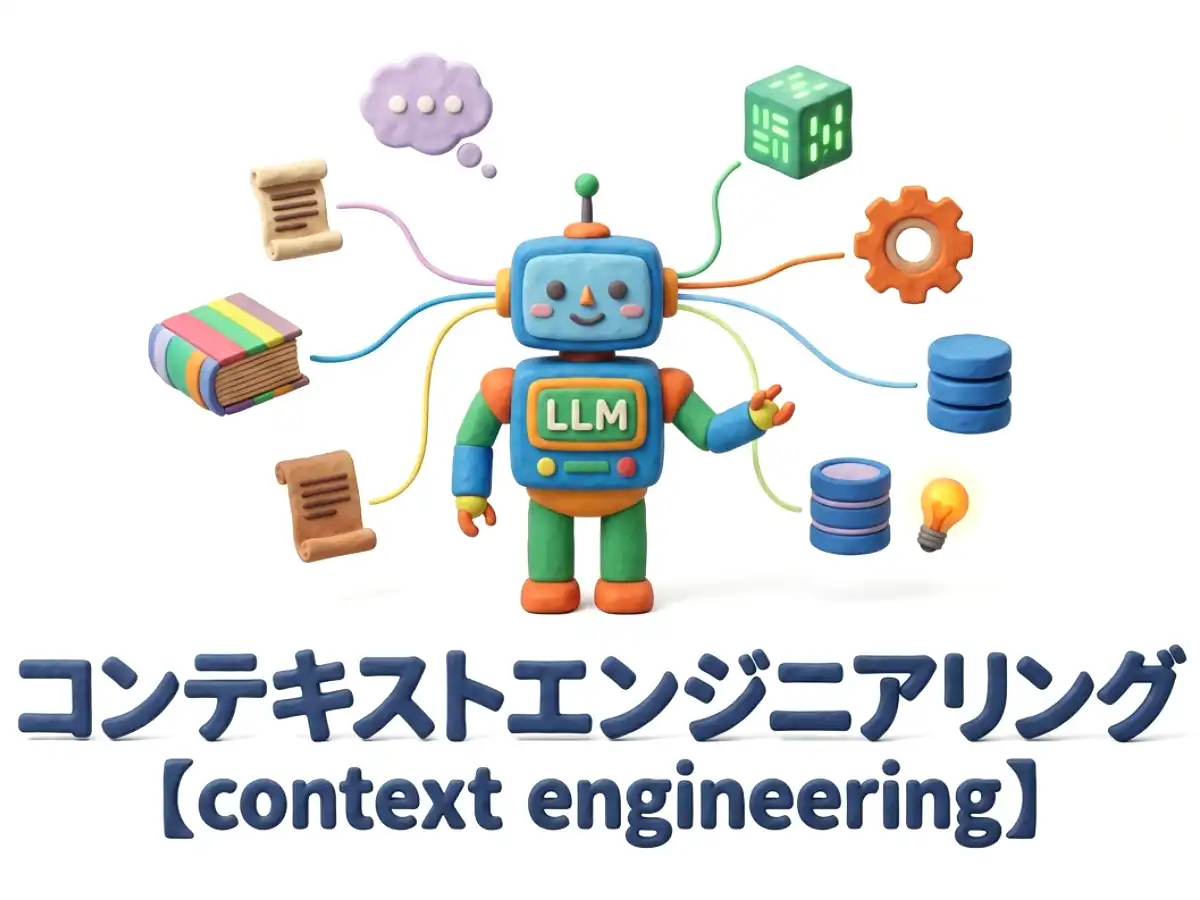
「コンテキスト」(context)とは、利用者の入力や過去の会話、検索で取得した文書、データベースの内容、外部ツールの実行結果、開発元による制限など、AIが回答を組み立てる際に参照する情報全般を指す。LLMはこの情報を基に判断や応答を生成する。
必要な情報が不足したり、無関係な情報が大量に含まれたりすると、的はずれな応答や、事実と異なる内容を出力する「ハルシネーション」(hallucination:幻覚)を起こしやすくなる。そのため、関連する文書を検索して取得するRAG(検索拡張生成)や、利用できるツールの選択、長くなった会話や作業履歴の要約など、応答に必要な情報を過不足無く与え続ける環境の整備が重要となる。
類似の概念に「プロンプトエンジニアリング」(prompt engineering)がある。これは指示文そのものの言葉遣いや表現を工夫し、望んだ回答を引き出す技術である。コンテキストエンジニアリングは、指示文自体とその背後にある情報環境全体を対象とする、より広い概念に当たる。従来のプロンプトエンジニアリングをその一部と位置付ける場合もある。
この用語が広く使われるようになったのは、生成AIの利用形態が、一度の質問に答える方式から、複数の手順を自律的に実行するAIエージェントへと広がったことによる。エージェントは大量のデータやツールにアクセスできる一方、一度に処理できる情報量には限りがある。そのため、状況に応じて必要な情報だけを選び出し、適切なタイミングで与える設計技術の重要性が高まっている。追加学習(ファインチューニング)には多くの計算資源が必要になるが、入力側で情報を適切に設計する手法であれば、既存のモデルのままコストを抑えて業務利用に対応させることができる。
(2026.9.1更新)


 共有ボタンをタップ