読み方 : クラスタかインデックス
クラスタ化インデックス【clustered index】
概要
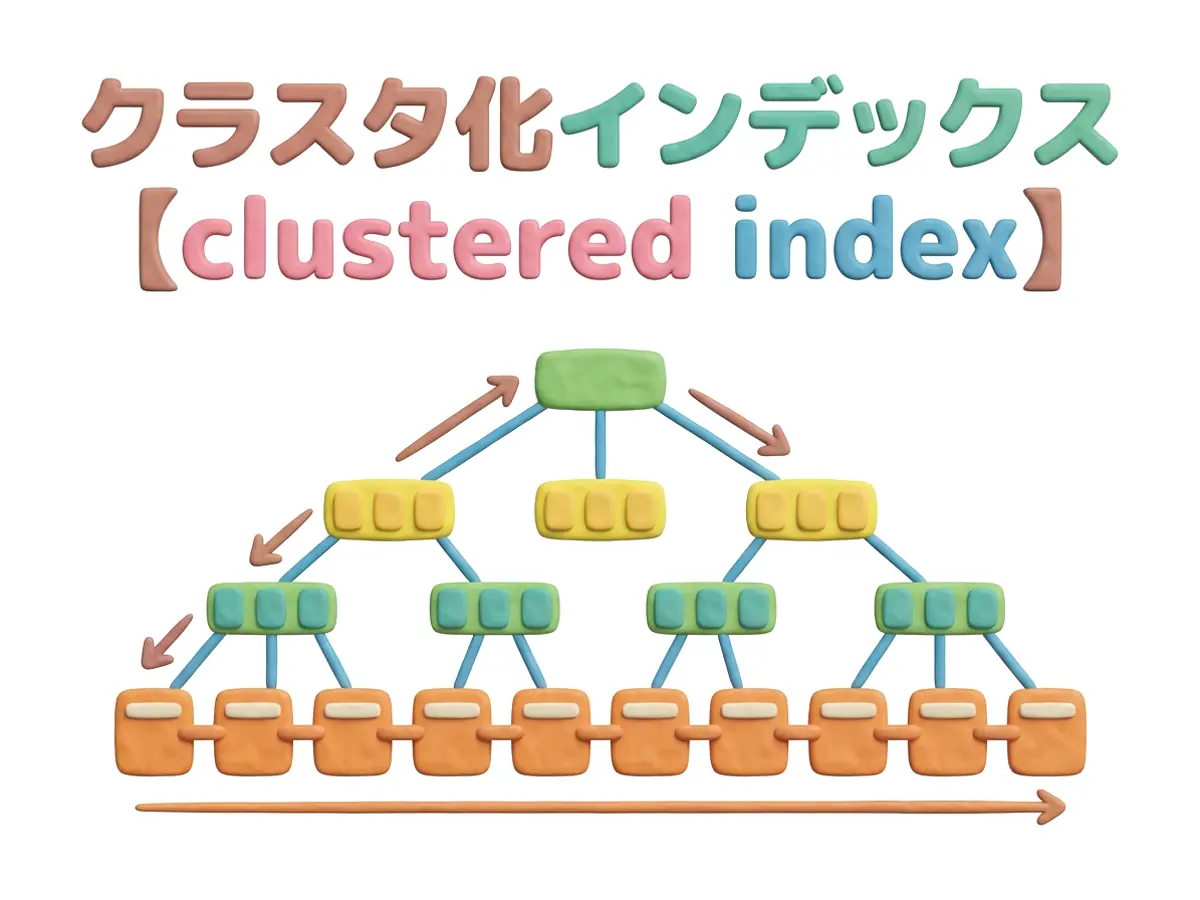
通常のインデックスは、キーとデータの格納位置を対応付けるだけで、データ行の並び順には手を加えない。これに対し、クラスタ化インデックスでは、指定した列の順序に合わせてデータ行自体をストレージ上で配置し直す操作を行う。
インデックスの木構造をたどってキー値にたどり着くと、その場所に実際のデータ行が存在するため、参照後に別の領域へデータを読みに行く処理が発生しない。日付や連番のように連続した値で範囲を指定する検索では、該当する行が隣り合って並ぶため、まとまった単位で読み込むだけで済み、読み出し速度が向上する。
データ行の格納順序そのものを決めるインデックスであるため、一つのテーブルに作成できるクラスタ化インデックスは基本的に一つに限られる。複数の列を組み合わせた複合キーを指定することは可能だが、テーブル全体としてデータを並べる基準は一つに定まる。一方、非クラスタ化インデックスは、データ行の実体とは別の構造として作成され、キー値と行の位置を対応付ける情報を保持するため、一つのテーブルに複数作成できる。
多くのデータベース管理システムでは、主キーを設定すると自動的にクラスタ化インデックスが作成される仕様になっている。主キーは行を一意に識別する列であり、検索や結合処理で頻繁に利用されることから、データを並べる基準として使われやすい。
なお、データの挿入や更新が発生すると、正しい並び順を維持するために周辺データを並べ替える処理が生じることがある。更新頻度が高い環境ではこの処理が書き込み性能に影響する場合があり、必要に応じてデータの再配置が行われる。クラスタ化の実装方法はデータベース製品によって異なり、常時並び順を維持する方式のほか、特定のコマンド実行時にのみ並べ替える製品もある。
(2026.9.17更新)


 共有ボタンをタップ