カバリングインデックス【covering index】
概要
カバリングインデックスとは、リレーショナルデータベースのテーブルに作成される索引(インデックス)の種類の一つで、問い合わせ(クエリ)が必要とする列をすべて含むように構成されたもの。検索条件に使う列だけでなく、取得したい列まであらかじめ含めておくことで、テーブル本体への追加アクセスを省き、検索処理を高速化できる。
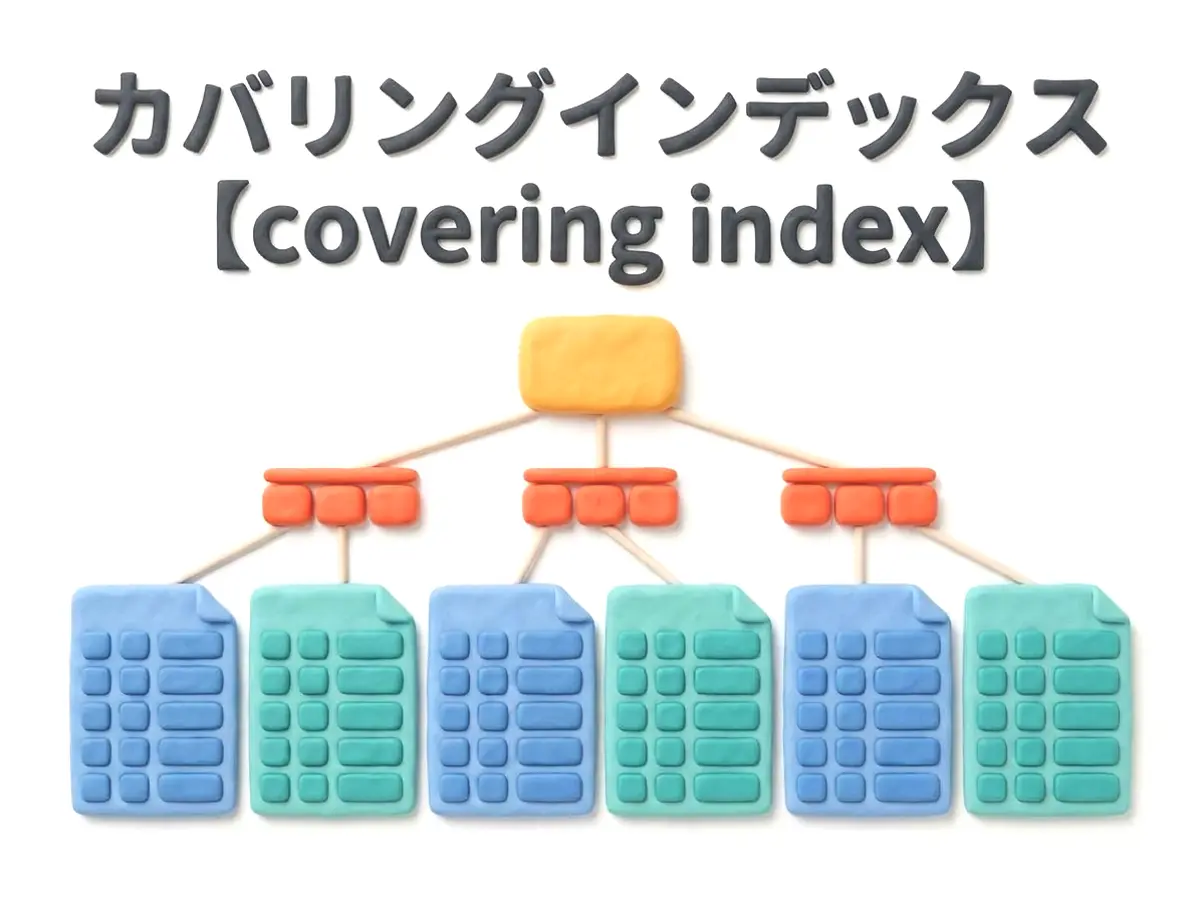
通常、データベースへの検索では、まずインデックスを参照して目的の行を特定し、その後、テーブル本体にアクセスして必要な列の値を取得するという2段階の処理を行う。一方、カバリングインデックスには、条件指定に使う列と表示対象の列の両方があらかじめ含まれており、インデックスの参照だけでクエリの処理が完結する。
大量の行を扱うテーブルや、参照が集中する環境では、テーブル本体への入出力が処理速度の障害になりやすい。カバリングインデックスを利用すると、この入出力を大幅に減らせるため、処理頻度が高いクエリほど効果が現れやすい。一方、インデックスに含める列を増やすほどインデックス自体のデータ量が増大し、記憶領域を圧迫する。
データの追加や更新、削除が発生するたびに、インデックス側でも更新処理が発生する。そのため、読み取り性能の向上と書き込み処理の負荷は常に相反する関係(トレードオフ)となり、利用頻度が高く効果の大きいクエリを見極めた上で適用することが一般的である。データベース管理システム(DBMS)は、クエリの内容やデータの状態を踏まえて、インデックスのみで処理を完結できるかどうかを判断する。
MySQLやPostgreSQL、Oracle Databaseなど、多くのリレーショナルデータベース管理システム(RDBMS)がこの仕組みに対応している。製品によっては、検索キーとは別に、結果の取得に必要な列だけをインデックスへ格納する機能を備えるものもあり、実行計画を確認する機能を使えば、あるクエリがテーブル本体へのアクセスを回避できているかどうかを調べることができる。
(2026.9.17更新)


 共有ボタンをタップ