基本情報技術者試験過去問 - 令和6年公開問題(科目B)
| 公開日 : | 2024年7月5日 | 受験者 : | 121,611人 |
| 問題数 : | 6問 | 合格者 : | 57,278人 |
| 合格率 : | 47% | ||
| 公式PDF : |
 問題
解答 |
問1
次のプログラム中のに入れる正しい答えを,解答群の中から選べ。
関数 maximum は,異なる三つの整数を引数で受け取り,そのうちの最大値を返す。
〔プログラム〕
関数 maximum は,異なる三つの整数を引数で受け取り,そのうちの最大値を返す。
〔プログラム〕
○整数型: maximum(整数型: x,整数型: y,整数型: z)
if ( [ ] )
return x
elseif (y > z)
return y
else
return z
endif
解答群
if ( [ ] )
return x
elseif (y > z)
return y
else
return z
endif
解答群
| ア | x > y |
|---|---|
| イ | x > y and x > z |
| ウ | x > y and y > z |
| エ | x > z |
| オ | x > z and z > y |
| カ | z > y |
答え : 設問1 イ
分野 : テクノロジ系 › 基礎理論 › アルゴリズムとプログラミング › プログラミング
解説 :
論理演算の真理値表を求める問題です。
まず,X AND (X□Y) の結果を見ると,X=1,Y=1のときだけ1になっています。ANDは両方が1のときだけ1になる演算なので,X=1のときのX□Yの値が1である必要があります。
次に,X OR (X□Y) はすべての行で1になっています。ORはどちらかが1であれば1になる演算なので,X=0の行(X=0,Y=0とX=0,Y=1)ではX□Yの値が1でなければ,結果を1にできません。
この二つの条件を満たすように各行のX□Yを埋めていくと,X=0,Y=0のとき1,X=0,Y=1のとき1,X=1,Y=0のとき0,X=1,Y=1のとき1という真理値表になり,正解は選択肢「ウ」です。
「ア」はX=0,Y=0のときが0になっており,この場合X OR (X□Y) が0になってしまうため条件を満たしません。
「イ」はX=1,Y=0のときが0であることは正しいのですが,X=0,Y=0のときも0になっており,やはりOR側の条件を満たしません。
「エ」はすべての行の値が他の選択肢と異なっており,AND側の条件(X=1,Y=1のとき1になる)を満たしていません。
分野 : テクノロジ系 › 基礎理論 › アルゴリズムとプログラミング › プログラミング
解説 :
論理演算の真理値表を求める問題です。
まず,X AND (X□Y) の結果を見ると,X=1,Y=1のときだけ1になっています。ANDは両方が1のときだけ1になる演算なので,X=1のときのX□Yの値が1である必要があります。
次に,X OR (X□Y) はすべての行で1になっています。ORはどちらかが1であれば1になる演算なので,X=0の行(X=0,Y=0とX=0,Y=1)ではX□Yの値が1でなければ,結果を1にできません。
この二つの条件を満たすように各行のX□Yを埋めていくと,X=0,Y=0のとき1,X=0,Y=1のとき1,X=1,Y=0のとき0,X=1,Y=1のとき1という真理値表になり,正解は選択肢「ウ」です。
「ア」はX=0,Y=0のときが0になっており,この場合X OR (X□Y) が0になってしまうため条件を満たしません。
「イ」はX=1,Y=0のときが0であることは正しいのですが,X=0,Y=0のときも0になっており,やはりOR側の条件を満たしません。
「エ」はすべての行の値が他の選択肢と異なっており,AND側の条件(X=1,Y=1のとき1になる)を満たしていません。
問2
次のプログラム中のに入れる正しい答えを,解答群の中から選べ。
関数 convDecimal は,引数として与えられた, “0” と “1” だけから成る,1文字以上の文字列を,符号なしの2進数と解釈したときの整数値を返す。例えば,引数として “10010” を与えると18が返る。
関数 convDecimal が利用する関数 int は,引数で与えられた文字が “0” なら整数値0を返し, “1” なら整数値1を返す。
〔プログラム〕
解答群
関数 convDecimal は,引数として与えられた, “0” と “1” だけから成る,1文字以上の文字列を,符号なしの2進数と解釈したときの整数値を返す。例えば,引数として “10010” を与えると18が返る。
関数 convDecimal が利用する関数 int は,引数で与えられた文字が “0” なら整数値0を返し, “1” なら整数値1を返す。
〔プログラム〕
解答群
| ア | result + int(binaryの (length - i + 1) 文字目の文字) |
|---|---|
| イ | result + int(binaryの i 文字目の文字) |
| ウ | result × 2 + int(binaryの (length - i + 1) 文字目の文字) |
| エ | result × 2 + int(binaryの i 文字目の文字) |
答え : 設問1 エ
分野 : テクノロジ系 › 基礎理論 › アルゴリズムとプログラミング › プログラミング
解説 :
ハッシュ関数を用いたハッシュ表への格納において,衝突が起こるキーの組み合わせを求める問題です。
ハッシュ関数はASCIIコードの10進表記の1の位を使うため,ASCIIコードの下1桁が同じアルファベット同士が衝突します。ASCIIコードはアルファベット順に連続して割り当てられているため,コードの差が10の倍数であるアルファベットの組み合わせが衝突することになります。
選択肢を確認すると,dとxはアルファベット順で20文字離れており,これはちょうど10の倍数であるため,ASCIIコードの下1桁が一致し衝突が発生します。従って,正解は選択肢「エ」です。
「ア」のaとiは8文字離れており10の倍数ではないため衝突しません。「イ」のbとrは16文字,「ウ」のcとlは9文字離れており,いずれも10の倍数ではないため衝突は起こりません。
ハッシュ関数による衝突を考える際は,「アルファベットの位置の差が使用するハッシュ表の大きさの倍数であるかどうか」に着目することがポイントです。
分野 : テクノロジ系 › 基礎理論 › アルゴリズムとプログラミング › プログラミング
解説 :
ハッシュ関数を用いたハッシュ表への格納において,衝突が起こるキーの組み合わせを求める問題です。
ハッシュ関数はASCIIコードの10進表記の1の位を使うため,ASCIIコードの下1桁が同じアルファベット同士が衝突します。ASCIIコードはアルファベット順に連続して割り当てられているため,コードの差が10の倍数であるアルファベットの組み合わせが衝突することになります。
選択肢を確認すると,dとxはアルファベット順で20文字離れており,これはちょうど10の倍数であるため,ASCIIコードの下1桁が一致し衝突が発生します。従って,正解は選択肢「エ」です。
「ア」のaとiは8文字離れており10の倍数ではないため衝突しません。「イ」のbとrは16文字,「ウ」のcとlは9文字離れており,いずれも10の倍数ではないため衝突は起こりません。
ハッシュ関数による衝突を考える際は,「アルファベットの位置の差が使用するハッシュ表の大きさの倍数であるかどうか」に着目することがポイントです。
問3
次のプログラム中のに入れる正しい答えを,解答群の中から選べ。ここで,配列の要素番号は1から始まる。
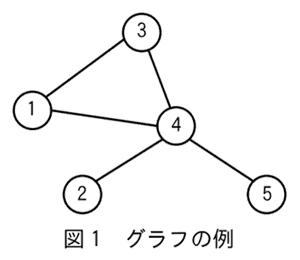
図1に示すグラフの頂点には1から順に整数で番号が付けられている。グラフは無向グラフであり,各頂点間には高々一つの辺がある。一つの辺は両端の頂点の番号を要素にもつ要素数2の整数型の配列で表現できる。例えば, {1,3} は頂点1と頂点3を端点とする辺を表す。グラフ全体は,グラフに含まれる辺を表す要素数2の配列を全て格納した配列(以下,辺の配列という)で表現できる。辺の配列の要素数はグラフの辺の個数と等しい。図1のグラフは整数型配列の配列 {{1,3},{1,4},{3,4},{2,4},{4,5}} と表現できる。
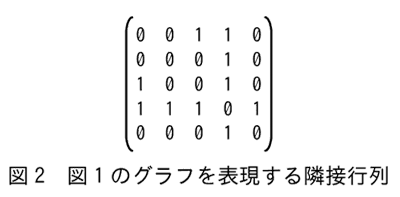
関数 edgesToMatrix は,辺の配列を隣接行列に変換する。隣接行列とは,グラフに含まれる頂点の個数と等しい行数及び列数の正方行列で,i行j列の成分は頂点iと頂点jを結ぶ辺があるときに1となり,それ以外は0となる。行列の対角成分は全て0で,無向グラフの場合は対称行列になる。図1のグラフを表現する隣接行列を図2に示す。
関数 edgesToMatrix は,引数 edgeList で辺の配列を,引数 nodeNum でグラフの頂点の個数をそれぞれ受け取り,隣接行列を表す整数型の二次元配列を返す。
〔プログラム〕
解答群
図1に示すグラフの頂点には1から順に整数で番号が付けられている。グラフは無向グラフであり,各頂点間には高々一つの辺がある。一つの辺は両端の頂点の番号を要素にもつ要素数2の整数型の配列で表現できる。例えば, {1,3} は頂点1と頂点3を端点とする辺を表す。グラフ全体は,グラフに含まれる辺を表す要素数2の配列を全て格納した配列(以下,辺の配列という)で表現できる。辺の配列の要素数はグラフの辺の個数と等しい。図1のグラフは整数型配列の配列 {{1,3},{1,4},{3,4},{2,4},{4,5}} と表現できる。
関数 edgesToMatrix は,辺の配列を隣接行列に変換する。隣接行列とは,グラフに含まれる頂点の個数と等しい行数及び列数の正方行列で,i行j列の成分は頂点iと頂点jを結ぶ辺があるときに1となり,それ以外は0となる。行列の対角成分は全て0で,無向グラフの場合は対称行列になる。図1のグラフを表現する隣接行列を図2に示す。
関数 edgesToMatrix は,引数 edgeList で辺の配列を,引数 nodeNum でグラフの頂点の個数をそれぞれ受け取り,隣接行列を表す整数型の二次元配列を返す。
〔プログラム〕
解答群
| ア | adjMatrix[u,u] ← 1 |
|---|---|
| イ | adjMatrix[u,u] ← 1 adjMatrix[v,v] ← 1 |
| ウ | adjMatrix[u,v] ← 1 |
| エ | adjMatrix[u,v] ← 1 adjMatrix[v,u] ← 1 |
| オ | adjMatrix[v,u] ← 1 |
| カ | adjMatrix[v,v] ← 1 |
答え : 設問1 エ
分野 : テクノロジ系 › 基礎理論 › アルゴリズムとプログラミング › プログラミング
解説 :
キャッシュメモリと主記憶のアクセス時間から,ヒット率を求める計算問題です。CPUの平均アクセス時間は,「ヒット率×キャッシュメモリのアクセス時間+(1-ヒット率)×主記憶のアクセス時間」で計算できます。
CPU Xとキャッシュメモリのアクセス時間は40ナノ秒,主記憶は400ナノ秒,CPU Yはキャッシュメモリが20ナノ秒,主記憶が580ナノ秒です。両者の処理時間が等しいという条件から,ヒット率をhとして方程式を立てると,40h+400(1-h)=20h+580(1-h)となります。
これを展開して整理すると,40h+400-400h=20h+580-580hとなり,さらに計算を進めると-360h+400=-560h+580となります。両辺を整理すると200h=180となり,これを解くとh=0.9となるため,正解は選択肢「イ」です。この種の問題は,平均アクセス時間の公式を正しく立式し,丁寧に計算を進めることが重要です。
分野 : テクノロジ系 › 基礎理論 › アルゴリズムとプログラミング › プログラミング
解説 :
キャッシュメモリと主記憶のアクセス時間から,ヒット率を求める計算問題です。CPUの平均アクセス時間は,「ヒット率×キャッシュメモリのアクセス時間+(1-ヒット率)×主記憶のアクセス時間」で計算できます。
CPU Xとキャッシュメモリのアクセス時間は40ナノ秒,主記憶は400ナノ秒,CPU Yはキャッシュメモリが20ナノ秒,主記憶が580ナノ秒です。両者の処理時間が等しいという条件から,ヒット率をhとして方程式を立てると,40h+400(1-h)=20h+580(1-h)となります。
これを展開して整理すると,40h+400-400h=20h+580-580hとなり,さらに計算を進めると-360h+400=-560h+580となります。両辺を整理すると200h=180となり,これを解くとh=0.9となるため,正解は選択肢「イ」です。この種の問題は,平均アクセス時間の公式を正しく立式し,丁寧に計算を進めることが重要です。
問4
次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。ここで,配列の要素番号は1から始まる。
関数 merge は,昇順に整列された整数型の配列 data1 及び data2 を受け取り,これらを併合してできる昇順に整列された整数型の配列を返す。
関数 merge を merge({2,3},{1,4}) として呼び出すと /*** α ***/ の行は [ ] 。
〔プログラム〕
解答群
関数 merge は,昇順に整列された整数型の配列 data1 及び data2 を受け取り,これらを併合してできる昇順に整列された整数型の配列を返す。
関数 merge を merge({2,3},{1,4}) として呼び出すと /*** α ***/ の行は [ ] 。
〔プログラム〕
○整数型の配列: merge(整数型の配列: data1,整数型の配列: data2)
整数型: n1 ← data1の要素数
整数型: n2 ← data2の要素数
整数型の配列: work ← {(n1 + n2)個の未定義の値}
整数型: i ← 1
整数型: j ← 1
整数型: k ← 1
while ((i ≦ n1) and (j ≦ n2))
if (data1[i] ≦ data2[j])
work[k] ← data1[i]
i ← i + 1
else
work[k] ← data2[j]
j ← j + 1
endif
k ← k + 1
endwhile
while (i ≦ n1)
work[k] ← data1[i]
i ← i + 1
k ← k + 1
endwhile
while (j ≤ n2)
work[k] ← data2[j] /*** α ***/
j ← j + 1
k ← k + 1
endwhile
return work
整数型: n1 ← data1の要素数
整数型: n2 ← data2の要素数
整数型の配列: work ← {(n1 + n2)個の未定義の値}
整数型: i ← 1
整数型: j ← 1
整数型: k ← 1
while ((i ≦ n1) and (j ≦ n2))
if (data1[i] ≦ data2[j])
work[k] ← data1[i]
i ← i + 1
else
work[k] ← data2[j]
j ← j + 1
endif
k ← k + 1
endwhile
while (i ≦ n1)
work[k] ← data1[i]
i ← i + 1
k ← k + 1
endwhile
while (j ≤ n2)
work[k] ← data2[j] /*** α ***/
j ← j + 1
k ← k + 1
endwhile
return work
解答群
| ア | 実行されない |
|---|---|
| イ | 1回実行される |
| ウ | 2回実行される |
| エ | 3回実行される |
答え : 設問1 イ
分野 : テクノロジ系 › 基礎理論 › アルゴリズムとプログラミング › プログラミング
解説 :
MTBFとMTTRの改善率から,翌年度の稼働率を求める計算問題です。稼働率は「MTBF÷(MTBF+MTTR)」で求められます。
今年度のMTBFは3,000時間,MTTRは1,000時間です。翌年度はMTBFが20%改善されるため,3,000×1.2=3,600時間になります。MTTRは10%改善(短縮)されるため,1,000×0.9=900時間になります。この値を稼働率の式に当てはめると,3,600÷(3,600+900)=3,600÷4,500=0.8となり,パーセントに直すと80%となります。正解は選択肢「エ」です。
MTBFの改善は数値が大きくなる方向,MTTRの改善は数値が小さくなる方向である点に注意して計算する必要があります。改善率を掛ける対象を取り違えないようにすることがこの問題を正しく解くポイントです。
分野 : テクノロジ系 › 基礎理論 › アルゴリズムとプログラミング › プログラミング
解説 :
MTBFとMTTRの改善率から,翌年度の稼働率を求める計算問題です。稼働率は「MTBF÷(MTBF+MTTR)」で求められます。
今年度のMTBFは3,000時間,MTTRは1,000時間です。翌年度はMTBFが20%改善されるため,3,000×1.2=3,600時間になります。MTTRは10%改善(短縮)されるため,1,000×0.9=900時間になります。この値を稼働率の式に当てはめると,3,600÷(3,600+900)=3,600÷4,500=0.8となり,パーセントに直すと80%となります。正解は選択肢「エ」です。
MTBFの改善は数値が大きくなる方向,MTTRの改善は数値が小さくなる方向である点に注意して計算する必要があります。改善率を掛ける対象を取り違えないようにすることがこの問題を正しく解くポイントです。
問5
次のプログラム中の [ a ] 〜 [ c ] に入れる正しい答えの組合せを,解答群の中から選べ。ここで,配列の要素番号は1から始まる。
一度の注文で購入された商品のリストを,注文ごとに記録した注文データがある。表に,注文データの例を示す。
注文データから,商品xと商品yとが同一の注文で購入されやすい傾向を示す関連度 Lxy を,次の式で計算する。
ここで, Mxy は商品xと商品yとが同一の注文で購入された注文数, Kx は商品xが購入された注文数, Ky は商品yが購入された注文数を表す。表の例では, MAB が2,全注文数が6,KA が4,KB が3であるので,商品Aと商品Bの関連度 LAB は,(2 × 6) / (4 × 3) = 1.0である。
手続 putRelatedItem は,大域変数 orders に格納された注文データを基に,引数で与えられた商品との関連度が最も大きい商品のうちの一つと,その関連度を出力する。プログラムでは,商品は文字列で表し,注文は購入された商品の配列,注文データは注文の配列で表している。注文データには2種類以上の商品が含まれるものとする。また,注文データにある商品以外の商品が,引数として与えられることはないものとする。
〔プログラム〕
解答群
一度の注文で購入された商品のリストを,注文ごとに記録した注文データがある。表に,注文データの例を示す。
| 注文番号 | 購入された商品のリスト |
| 1 | A,B,D |
| 2 | A,D |
| 3 | A |
| 4 | A,B,E |
| 5 | B |
| 6 | C,E |
注文データから,商品xと商品yとが同一の注文で購入されやすい傾向を示す関連度 Lxy を,次の式で計算する。
ここで, Mxy は商品xと商品yとが同一の注文で購入された注文数, Kx は商品xが購入された注文数, Ky は商品yが購入された注文数を表す。表の例では, MAB が2,全注文数が6,KA が4,KB が3であるので,商品Aと商品Bの関連度 LAB は,(2 × 6) / (4 × 3) = 1.0である。
手続 putRelatedItem は,大域変数 orders に格納された注文データを基に,引数で与えられた商品との関連度が最も大きい商品のうちの一つと,その関連度を出力する。プログラムでは,商品は文字列で表し,注文は購入された商品の配列,注文データは注文の配列で表している。注文データには2種類以上の商品が含まれるものとする。また,注文データにある商品以外の商品が,引数として与えられることはないものとする。
〔プログラム〕
// 注文データ (ここでは表の例を与えている)
大域: 文字列型配列の配列: orders ← {{"A","B","D"},{"A","D"},{"A"},
{"A","B","E"},{"B"},{"C","E"}}
○putRelatedItem(文字列型: item)
文字列型の配列: allItems ← ordersに含まれる文字列を
重複なく辞書順に格納した配列
// 表の例では{"A","B","C","D","E"}
文字列型の配列: otherItems ← allItemsの複製から値がitemである
要素を除いた配列
整数型: i,itemCount ← 0
整数型の配列: arrayK ← {otherItemsの要素数個の0}
整数型の配列: arrayM ← {otherItemsの要素数個の0}
実数型: valueL,maxL ← 0
文字列型の配列: order
文字列型: relatedItem
for (orderにordersの要素を順に代入する)
if (orderのいずれかの要素の値がitemの値と等しい)
itemCountの値を1増やす
endif
for (iを1からotherItemsの要素数まで1ずつ増やす)
if (orderのいずれかの要素の値がotherItems[i]の値と等しい)
if (orderのいずれかの要素の値がitemの値と等しい)
[ a ] の値を1増やす
endif
[ b ] の値を1増やす
endif
endfor
endfor
for (iを1からotherItemsの要素数まで1ずつ増やす)
valueL ← (arrayM[i] × [ c ]) ÷ (itemCount × arrayK[i])
/* 実数として計算する */
if (valueLがmaxLより大きい)
maxL ← valueL
relatedItem ← otherItems[i]
endif
endfor
relatedItemの値とmaxLの値をこの順にコンマ区切りで出力する
大域: 文字列型配列の配列: orders ← {{"A","B","D"},{"A","D"},{"A"},
{"A","B","E"},{"B"},{"C","E"}}
○putRelatedItem(文字列型: item)
文字列型の配列: allItems ← ordersに含まれる文字列を
重複なく辞書順に格納した配列
// 表の例では{"A","B","C","D","E"}
文字列型の配列: otherItems ← allItemsの複製から値がitemである
要素を除いた配列
整数型: i,itemCount ← 0
整数型の配列: arrayK ← {otherItemsの要素数個の0}
整数型の配列: arrayM ← {otherItemsの要素数個の0}
実数型: valueL,maxL ← 0
文字列型の配列: order
文字列型: relatedItem
for (orderにordersの要素を順に代入する)
if (orderのいずれかの要素の値がitemの値と等しい)
itemCountの値を1増やす
endif
for (iを1からotherItemsの要素数まで1ずつ増やす)
if (orderのいずれかの要素の値がotherItems[i]の値と等しい)
if (orderのいずれかの要素の値がitemの値と等しい)
[ a ] の値を1増やす
endif
[ b ] の値を1増やす
endif
endfor
endfor
for (iを1からotherItemsの要素数まで1ずつ増やす)
valueL ← (arrayM[i] × [ c ]) ÷ (itemCount × arrayK[i])
/* 実数として計算する */
if (valueLがmaxLより大きい)
maxL ← valueL
relatedItem ← otherItems[i]
endif
endfor
relatedItemの値とmaxLの値をこの順にコンマ区切りで出力する
解答群
| a | b | c | |
| ア | arrayK[i] | arrayM[i] | allItemsの要素数 |
| イ | arrayK[i] | arrayM[i] | ordersの要素数 |
| ウ | arrayK[i] | arrayM[i] | otherItemsの要素数 |
| エ | arrayM[i] | arrayK[i] | allItemsの要素数 |
| オ | arrayM[i] | arrayK[i] | ordersの要素数 |
| カ | arrayM[i] | arrayK[i] | otherItemsの要素数 |
答え : 設問1 オ
分野 : テクノロジ系 › 基礎理論 › アルゴリズムとプログラミング › プログラミング
解説 :
ロジックマッシュアップの例を選ぶ問題です。「マッシュアップ」とは,複数のWebサービスが提供する機能やデータを組み合わせて新たなサービスを作り出す技術のことで,その中でも入出力処理そのものを連結させる仕組みを「ロジックマッシュアップ」と呼びます。
選択肢「ウ」は,予算に応じた宿泊施設のリストを一つのWebサービスから取得し,さらにその施設の空室状況を別のWebサービスから取得するという,処理の入力と出力が連鎖的につながっている例であり,これが正解です。
「ア」は地図コンテンツを単に表示画面に埋め込んでいるだけであり,これは「プレゼンテーションマッシュアップ」と呼ばれる,見た目の合成に留まる例です。
「イ」は複数のサービスからデータを取得してグラフに加工するという処理ですが,処理結果を次のサービスの入力として連鎖させているわけではなく,単純なデータ統合の域に留まります。
「エ」は地図の一部を再読み込みしてスクロール表示する技術の説明であり,これは非同期通信の技術であるAjaxに関する内容であり,マッシュアップとは異なる概念です。
分野 : テクノロジ系 › 基礎理論 › アルゴリズムとプログラミング › プログラミング
解説 :
ロジックマッシュアップの例を選ぶ問題です。「マッシュアップ」とは,複数のWebサービスが提供する機能やデータを組み合わせて新たなサービスを作り出す技術のことで,その中でも入出力処理そのものを連結させる仕組みを「ロジックマッシュアップ」と呼びます。
選択肢「ウ」は,予算に応じた宿泊施設のリストを一つのWebサービスから取得し,さらにその施設の空室状況を別のWebサービスから取得するという,処理の入力と出力が連鎖的につながっている例であり,これが正解です。
「ア」は地図コンテンツを単に表示画面に埋め込んでいるだけであり,これは「プレゼンテーションマッシュアップ」と呼ばれる,見た目の合成に留まる例です。
「イ」は複数のサービスからデータを取得してグラフに加工するという処理ですが,処理結果を次のサービスの入力として連鎖させているわけではなく,単純なデータ統合の域に留まります。
「エ」は地図の一部を再読み込みしてスクロール表示する技術の説明であり,これは非同期通信の技術であるAjaxに関する内容であり,マッシュアップとは異なる概念です。
問6
A社は従業員450名の商社であり,昨年から働き方改革の一環として,在宅でのテレワークを推進している。A社のシステム環境を図1に示す。
テレワークの定着が進むにつれて,社内PCからインターネットへの接続が極端に遅くなり,業務に支障をきたしているので改善できないかと,従業員から問合せがあった。A社の社内ネットワークとインターネットとの間の通信量を調査したところ,テレワーク導入前に比べ,業務時間帯で顕著に増加していることが判明した。そのため,情報システム部では,テレワークでA社利用クラウドサービスに接続する場合には,A社の社内ネットワークも社内PCも介さずに直接接続することを可能にするネットワークの設定変更を実施することにした。
設定変更に当たり,情報セキュリティ上の問題がないかをA社の情報セキュリティリーダーであるBさんが検討したところ,幾つか問題があることが分かった。その一つは,A社利用クラウドサービスへの不正アクセスのリスクが増加することである。そこでBさんは,リスクを低減するために,情報システム部に対策を依頼することにした。
設問 次の対策のうち,情報システム部に依頼することにしたものはどれか。解答群のうち,最も適切なものを選べ。
解答群
・従業員には,一人に1台デスクトップPC(以下,社内PCという)を貸与している。
・従業員が利用するシステムには,自社で開発しA社に設置している業務システムのほかに,次の二つの SaaS (以下,二つの SaaS をA社利用クラウドサービスという)がある。
1. メール機能,チャット機能及びクラウドストレージ機能をもつグループウェア(以下,A社利用グループウェアという)
2. オンライン会議サービス
・テレワークでは,従業員の個人所有PC(以下,私有PCという)の業務利用(BYOD)を許可している。
・テレワークでは,社内PC及び私有PCのそれぞれに専用のアプリケーションソフトウェア(以下,専用アプリという)を導入し,社内PCのデスクトップから私有PCに画面転送を行うリモートデスクトップ方式を採用している。
・専用アプリには,リモートデスクトップからPCへのファイルのダウンロード及びファイル,文字列,画像などのコピー&ペーストを禁止する機能(以下,保存禁止機能という)があり,A社では私有PCに対して当該機能を有効にしている。
・業務システムには,社内PCのデスクトップから利用者ID及びパスワードを入力してログインしている。
・A社利用クラウドサービスへのログインは,A社利用クラウドサービス側の設定によってA社の社内ネットワークからだけ可能になるように制限している。ログインには利用者ID及びパスワードを用いている。
・従業員が利用するシステムには,自社で開発しA社に設置している業務システムのほかに,次の二つの SaaS (以下,二つの SaaS をA社利用クラウドサービスという)がある。
1. メール機能,チャット機能及びクラウドストレージ機能をもつグループウェア(以下,A社利用グループウェアという)
2. オンライン会議サービス
・テレワークでは,従業員の個人所有PC(以下,私有PCという)の業務利用(BYOD)を許可している。
・テレワークでは,社内PC及び私有PCのそれぞれに専用のアプリケーションソフトウェア(以下,専用アプリという)を導入し,社内PCのデスクトップから私有PCに画面転送を行うリモートデスクトップ方式を採用している。
・専用アプリには,リモートデスクトップからPCへのファイルのダウンロード及びファイル,文字列,画像などのコピー&ペーストを禁止する機能(以下,保存禁止機能という)があり,A社では私有PCに対して当該機能を有効にしている。
・業務システムには,社内PCのデスクトップから利用者ID及びパスワードを入力してログインしている。
・A社利用クラウドサービスへのログインは,A社利用クラウドサービス側の設定によってA社の社内ネットワークからだけ可能になるように制限している。ログインには利用者ID及びパスワードを用いている。
図1 A社のシステム環境(抜粋)
テレワークの定着が進むにつれて,社内PCからインターネットへの接続が極端に遅くなり,業務に支障をきたしているので改善できないかと,従業員から問合せがあった。A社の社内ネットワークとインターネットとの間の通信量を調査したところ,テレワーク導入前に比べ,業務時間帯で顕著に増加していることが判明した。そのため,情報システム部では,テレワークでA社利用クラウドサービスに接続する場合には,A社の社内ネットワークも社内PCも介さずに直接接続することを可能にするネットワークの設定変更を実施することにした。
設定変更に当たり,情報セキュリティ上の問題がないかをA社の情報セキュリティリーダーであるBさんが検討したところ,幾つか問題があることが分かった。その一つは,A社利用クラウドサービスへの不正アクセスのリスクが増加することである。そこでBさんは,リスクを低減するために,情報システム部に対策を依頼することにした。
設問 次の対策のうち,情報システム部に依頼することにしたものはどれか。解答群のうち,最も適切なものを選べ。
解答群
| ア | A社の社内ネットワークからA社利用クラウドサービスへの通信を監視する。 |
|---|---|
| イ | A社の社内ネットワークとA社利用クラウドサービスとの間の通信速度を制限する。 |
| ウ | A社利用クラウドサービスにA社外から接続する際の認証に2要素認証を導入する。 |
| エ | A社利用クラウドサービスのうち,A社利用グループウェアだけを直接接続の対象とする。 |
| オ | 専用アプリの保存禁止機能を無効にする。 |
答え : 設問1 ウ
分野 : テクノロジ系 › 技術要素 › セキュリティ › 情報セキュリティ管理
解説 :
ディスプレイ表示において,斜めの線のギザギザを目立たなくする技術を選ぶ問題です。この技術は「アンチエイリアシング」と呼ばれ,境界線付近の画素の色を周囲の色と中間的な色にすることで,輪郭を滑らかに見せる手法です。正解は選択肢「ア」です。
「イ」の「シェーディング」は,3DCGの描画で光源からの光の当たり方に応じて物体表面に陰影をつける技術であり,輪郭の滑らかさとは異なる目的の技術です。
「ウ」の「テクスチャマッピング」は,3次元モデルの表面に模様や質感を表す画像を貼り付ける技術であり,これも輪郭のギザギザとは無関係です。
「エ」のバンプマッピングは,表面の凹凸を疑似的に表現する技術であり,実際に形状を変えずに陰影の変化だけで立体感を演出する手法です。
分野 : テクノロジ系 › 技術要素 › セキュリティ › 情報セキュリティ管理
解説 :
ディスプレイ表示において,斜めの線のギザギザを目立たなくする技術を選ぶ問題です。この技術は「アンチエイリアシング」と呼ばれ,境界線付近の画素の色を周囲の色と中間的な色にすることで,輪郭を滑らかに見せる手法です。正解は選択肢「ア」です。
「イ」の「シェーディング」は,3DCGの描画で光源からの光の当たり方に応じて物体表面に陰影をつける技術であり,輪郭の滑らかさとは異なる目的の技術です。
「ウ」の「テクスチャマッピング」は,3次元モデルの表面に模様や質感を表す画像を貼り付ける技術であり,これも輪郭のギザギザとは無関係です。
「エ」のバンプマッピングは,表面の凹凸を疑似的に表現する技術であり,実際に形状を変えずに陰影の変化だけで立体感を演出する手法です。
 共有ボタンをタップ