基本情報技術者試験過去問 - 令和1年秋期試験(科目B)
| 実施日 : | 2019年10月20日 | 受験者 : | 66,870人 |
| 問題数 : | 8問 | 合格者 : | 19,069人 |
| 合格率 : | 28.5% | ||
| 公式PDF : |
 問題
解答 |
問1
テレワークの導入に関する次の記述を読んで,設問1~3に答えよ。
ソフトウェア開発会社であるA社では,従業員が働き方を柔軟に選択できるように,場所や時間の制約を受けずに働く勤務形態であるテレワークを導入することにした。
A社には,事務業務だけが行えるPC(以下,事務PCという)と,事務業務及びソフトウェア開発業務が行えるPC(以下,開発PCという)がある。開発部の従業員は開発PCを使用し,開発部以外の従業員は事務PCを使用している。
A社には事務室,開発室及びサーバ室があり,各部屋のネットワークはファイアウォール(以下,A社FWという)を介して接続されている。A社のネットワーク構成を,図1に示す。
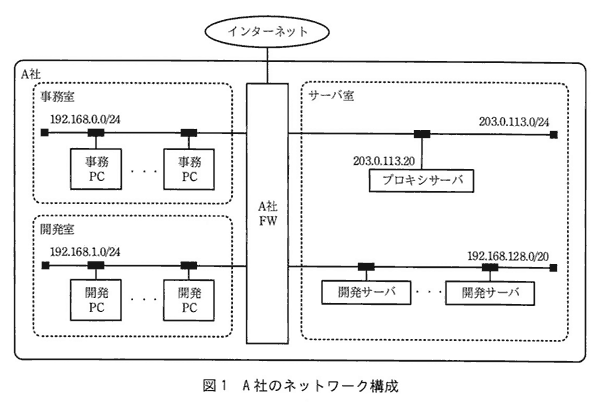
事務室には,事務PCだけが設置されている。開発室には開発PCだけが設置されており,開発部の従業員だけが入退室できる。サーバ室には,プロキシサーバ1台と,ソフトウェア開発業務に必要なソースコード管理,バグ管理,テストなどに利用するサーバ(以下,開発サーバという)が複数台設置されている。
A社FWでは,開発室のネットワークだけから開発サーバにHTTP over TLS(以下,HTTPSという)又はSSHでアクセスできるように通信を制限している。また,A社ネットワークからのインターネットのWebサイト閲覧は,事務PC及び開発PCだけからプロキシサーバを経由してできるように通信を制限している。
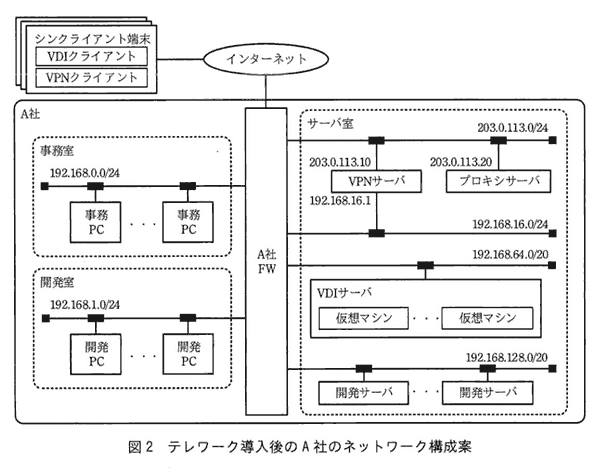
テレワークで働く従業員は,データを保存できないシンクライアント端末をA社から支給され,遠隔からインターネットを経由してA社のネットワークに接続し,業務を行う。そのために,安全にA社のネットワークに接続するVPN,及び仮想マシンの画面を転送して遠隔から操作できるようにする画面転送型の仮想デスクトップ環境(以下,VDIという)の導入を検討した。テレワーク導入後のA社のネットワーク構成案を,図2に示す。
〔A社が検討したテレワークによる業務の開始までの流れ〕
(1) 利用者は,シンクライアント端末のVPNクライアントを起動して,VPNサーバに接続する。
(2) VPNサーバは,VPNクライアントが提示するクライアント証明書を検証する。検証に成功した場合,処理を継続する。
(3) VPNサーバは,利用者を認証する。認証が成功した場合,VPNクライアントに対して,192.168.16.0/24の範囲で使用されていないIPアドレスを一つ選択して割り当てる。
(4) VPNクライアントは,(3)で割り当てられたIPアドレスを使用して,VPNサーバ経由でA社のネットワークに接続する。
(5) 利用者は,シンクライアント端末のVDIクライアントを起動して,VDIサーバに接続する。
(6) VDIサーバは,VPNサーバで認証された利用者が開発部以外の従業員であれば事務業務だけが行える仮想マシン(以下,事務VMという)を,開発部の従業員であれば事務業務及びソフトウェア開発業務が行える仮想マシン(以下,開発VMという)を割り当てる。また,VDIサーバは,事務VMには192.168.64.0/24,開発VMには192.168.65.0/24の範囲で使用されていないIPアドレスを一つ選択して割り当てる。
(7) 利用者は,仮想マシンにログインして業務を開始する。VDIクライアントと仮想マシンとの間では,画面データ,並びにキーボード及びマウスの操作データだけが送受信される。
テレワーク導入後のA社FWに設定するパケットフィルタリングのルール案を,表1に示す。
注記1 ルール番号の小さいものから順に,最初に一致したルールが適用される。
注記2 許可された通信に対する戻りのパケットは,無条件に許可される。
ところが,表1のルール案ではルール番号7の条件に誤りがあり, [ a ] ことが分かった。そこで,開発サーバに対するアクセスを正しく制限するために,ルール番号7の条件について,送信元を [ b ] に変更した。
設問1 本文中の [ ] に入れる適切な答えを,解答群の中から選べ。
aに関する解答群
bに関する解答群
設問2 シンクライアント端末から開発サーバにアクセスするときの接続経路として適切な答えを,解答群の中から選べ。
解答群
設問3 A社がテレワークの検討を進める過程で, “常に同一の業務環境を使用できるように,テレワークで働くときだけでなく,事務PC及び開発PCからも仮想マシンを使用したい” との要望が挙がった。検討した結果,この要望に応えてもセキュリティ上のリスクは変わらないと判断した。また,A社のネットワーク内からアクセスするのでVPNで接続する必要はなく,利用者認証をVPNサーバではなくVDIサーバで行えばよいことを確認した。
この要望に応えるとき,表1のルール案に必要な変更として適切な答えを,解答群の中から選べ。ここで,表1のルール番号7の送信元には,設問1で選択した適切な答えが設定されているものとする。
解答群
ソフトウェア開発会社であるA社では,従業員が働き方を柔軟に選択できるように,場所や時間の制約を受けずに働く勤務形態であるテレワークを導入することにした。
A社には,事務業務だけが行えるPC(以下,事務PCという)と,事務業務及びソフトウェア開発業務が行えるPC(以下,開発PCという)がある。開発部の従業員は開発PCを使用し,開発部以外の従業員は事務PCを使用している。
A社には事務室,開発室及びサーバ室があり,各部屋のネットワークはファイアウォール(以下,A社FWという)を介して接続されている。A社のネットワーク構成を,図1に示す。
事務室には,事務PCだけが設置されている。開発室には開発PCだけが設置されており,開発部の従業員だけが入退室できる。サーバ室には,プロキシサーバ1台と,ソフトウェア開発業務に必要なソースコード管理,バグ管理,テストなどに利用するサーバ(以下,開発サーバという)が複数台設置されている。
A社FWでは,開発室のネットワークだけから開発サーバにHTTP over TLS(以下,HTTPSという)又はSSHでアクセスできるように通信を制限している。また,A社ネットワークからのインターネットのWebサイト閲覧は,事務PC及び開発PCだけからプロキシサーバを経由してできるように通信を制限している。
テレワークで働く従業員は,データを保存できないシンクライアント端末をA社から支給され,遠隔からインターネットを経由してA社のネットワークに接続し,業務を行う。そのために,安全にA社のネットワークに接続するVPN,及び仮想マシンの画面を転送して遠隔から操作できるようにする画面転送型の仮想デスクトップ環境(以下,VDIという)の導入を検討した。テレワーク導入後のA社のネットワーク構成案を,図2に示す。
〔A社が検討したテレワークによる業務の開始までの流れ〕
(1) 利用者は,シンクライアント端末のVPNクライアントを起動して,VPNサーバに接続する。
(2) VPNサーバは,VPNクライアントが提示するクライアント証明書を検証する。検証に成功した場合,処理を継続する。
(3) VPNサーバは,利用者を認証する。認証が成功した場合,VPNクライアントに対して,192.168.16.0/24の範囲で使用されていないIPアドレスを一つ選択して割り当てる。
(4) VPNクライアントは,(3)で割り当てられたIPアドレスを使用して,VPNサーバ経由でA社のネットワークに接続する。
(5) 利用者は,シンクライアント端末のVDIクライアントを起動して,VDIサーバに接続する。
(6) VDIサーバは,VPNサーバで認証された利用者が開発部以外の従業員であれば事務業務だけが行える仮想マシン(以下,事務VMという)を,開発部の従業員であれば事務業務及びソフトウェア開発業務が行える仮想マシン(以下,開発VMという)を割り当てる。また,VDIサーバは,事務VMには192.168.64.0/24,開発VMには192.168.65.0/24の範囲で使用されていないIPアドレスを一つ選択して割り当てる。
(7) 利用者は,仮想マシンにログインして業務を開始する。VDIクライアントと仮想マシンとの間では,画面データ,並びにキーボード及びマウスの操作データだけが送受信される。
テレワーク導入後のA社FWに設定するパケットフィルタリングのルール案を,表1に示す。
| ルール番号 | 送信元 | 宛先 | サービス | 動作 |
| 1 | インターネット | 203.0.113.10 | VPN | 許可 |
| 2 | 203.0.113.20 | インターネット | HTTP,HTTPS,DNS | 許可 |
| 3 | 192.168.16.0/24 | 192.168.64.0/20 | VDI | 許可 |
| 4 | 192.168.0.0/23 | 203.0.113.20 | プロキシ | 許可 |
| 5 | 192.168.64.0/23 | 203.0.113.20 | プロキシ | 許可 |
| 6 | 192.168.1.0/24 | 192.168.128.0/20 | HTTPS,SSH | 許可 |
| 7 | 192.168.64.0/23 | 192.168.128.0/20 | HTTPS,SSH | 許可 |
| 8 | 全て | 全て | 全て | 拒否 |
注記2 許可された通信に対する戻りのパケットは,無条件に許可される。
ところが,表1のルール案ではルール番号7の条件に誤りがあり, [ a ] ことが分かった。そこで,開発サーバに対するアクセスを正しく制限するために,ルール番号7の条件について,送信元を [ b ] に変更した。
設問1 本文中の [ ] に入れる適切な答えを,解答群の中から選べ。
aに関する解答群
| ア | 開発PCから開発サーバにアクセスできない |
|---|---|
| イ | 開発VMから開発サーバにアクセスできない |
| ウ | 事務PCから開発サーバにアクセスできる |
| エ | 事務VMから開発サーバにアクセスできる |
bに関する解答群
| ア | 192.168.0.0/24 |
|---|---|
| イ | 192.168.1.0/24 |
| ウ | 192.168.16.0/24 |
| エ | 192.168.64.0/24 |
| オ | 192.168.65.0/24 |
| カ | 192.168.128.0/20 |
| キ | 192.168.128.0/24 |
| ク | 203.0.113.0/24 |
| ケ | インターネット |
設問2 シンクライアント端末から開発サーバにアクセスするときの接続経路として適切な答えを,解答群の中から選べ。
解答群
| ア | シンクライアント端末 → VDIサーバ → VPNサーバ → 開発PC → 開発サーバ |
|---|---|
| イ | シンクライアント端末 → VDIサーバ → VPNサーバ → 開発VM → 開発サーバ |
| ウ | シンクライアント端末 → VDIサーバ → 開発VM → 開発PC → 開発サーバ |
| エ | シンクライアント端末 → VPNサーバ → VDIサーバ → 開発PC → 開発サーバ |
| オ | シンクライアント端末 → VPNサーバ → VDIサーバ → 開発VM → 開発サーバ |
| カ | シンクライアント端末 → VPNサーバ → 開発PC → 開発VM → 開発サーバ |
設問3 A社がテレワークの検討を進める過程で, “常に同一の業務環境を使用できるように,テレワークで働くときだけでなく,事務PC及び開発PCからも仮想マシンを使用したい” との要望が挙がった。検討した結果,この要望に応えてもセキュリティ上のリスクは変わらないと判断した。また,A社のネットワーク内からアクセスするのでVPNで接続する必要はなく,利用者認証をVPNサーバではなくVDIサーバで行えばよいことを確認した。
この要望に応えるとき,表1のルール案に必要な変更として適切な答えを,解答群の中から選べ。ここで,表1のルール番号7の送信元には,設問1で選択した適切な答えが設定されているものとする。
解答群
| ア | 変更する必要はない。 |
|---|---|
| イ | ルール番号3と4の間に,送信元を192.168.0.0/23,宛先を192.168.64.0/20,サービスをVDI,及び動作を許可とするルールを新たに挿入する必要がある。 |
| ウ | ルール番号3と4の間に,送信元を192.168.64.0/23,宛先を192.168.0.0/23,サービスをVDI,及び動作を許可とするルールを新たに挿入する必要がある。 |
| エ | ルール番号3と4の間に,送信元をインターネット,宛先を192.168.64.0/20,サービスをVDI,及び動作を許可とするルールを新たに挿入する必要がある。 |
答え : 設問1 (a)エ (b)オ 設問2 オ 設問3 イ
分野 : テクノロジ系 › 技術要素 › セキュリティ › 情報セキュリティ管理
分野 : テクノロジ系 › 技術要素 › セキュリティ › 情報セキュリティ管理
問2
スレッドを使用した並列実行に関する次の記述を読んで,設問1~3に答えよ。
プログラム中の並列実行が可能な部分を取り出し,その部分を分割して複数のスレッドで並列に実行する方法(以下,スレッド並列法という)がある。マルチプロセッサシステムでは,スレッド並列法を適用することによって,プログラムの実行時間を短縮できることがある。
プログラムにおいて,スレッド並列法を適用しないで実行したときの実行時間を,スレッド並列法を適用したときの実行時間で割った値を,プログラム実行時間の高速化率という。
プログラムをスレッド並列法を適用しないで実行したときの,プログラム全体の実行時間に対する,並列実行可能な部分の実行時間の割合をr(0≦r≦1)とする。スレッドの個数をn(n≧1)にして,プログラムにスレッド並列法を適用すると,マルチプロセッサシステムでは,プログラム実行時間の高速化率Eは,次の式で求められる。ここで,各スレッドはそれぞれ異なるプロセッサに割り当てられるものとし,プログラムの実行に使用する全てのプロセッサの性能は同じとする。
この式は,並列実行可能な部分のプログラム実行時間がスレッド並列法の適用によって になり,その他の部分のプログラム実行時間は変化しないときの高速化率を計算するものである。
プログラム中に並列実行が可能な部分をもつプログラムAに対してスレッドの個数を2にしてスレッド並列法を適用すると,高速化率は になった。この場合,rは [ a ] である。
rが であるプログラムBの場合,スレッドの個数を増やしても,高速化率の上限は [ b ] である。
設問1 本文中の [ ] に入れる正しい答えを,解答群の中から選べ。
aに関する解答群
bに関する解答群
設問2 次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
配列の操作を行う繰返しの処理において,図1,図2のように繰返しの範囲を分割して,スレッド並列法を適用することを考える。
このとき,操作の内容によって,正しい結果が得られる場合と得られない場合があるので,十分に検討することが必要である。
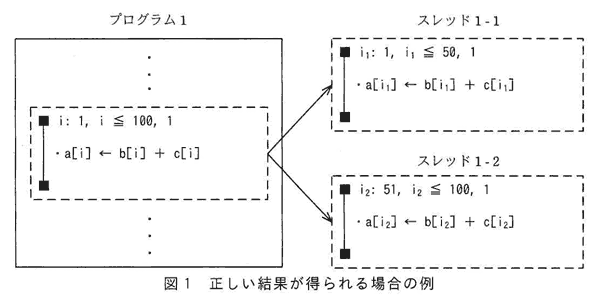
正しい結果が得られる場合の例を,図1に示す。
図1に示すプログラム1は,制御変数iの取る範囲を分けることによって繰返し範囲を分割した繰返しの処理を,それぞれ異なるスレッドで実行できる。
なお,図1,図2において,実線の四角はプログラム,破線の四角は繰返しの処理,破線の四角から出る二つの矢印は分割を示す。
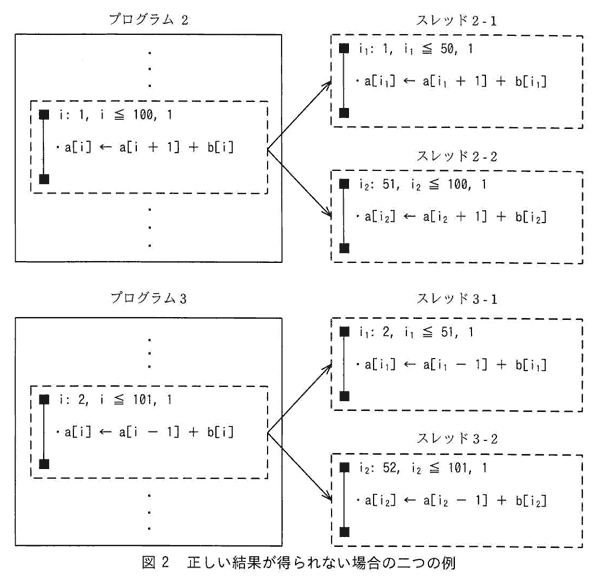
正しい結果が得られない場合の二つの例を,図2に示す。
プログラム2の繰返しの処理を,スレッド2-1とスレッド2-2の二つに分割すると, [ c ] ことがあるので,スレッド並列法を適用しない場合の実行結果と等しくなることを保証できない。したがって,プログラム2に対しては,繰返しの範囲の分割によるスレッド並列法を適用できない。
また,プログラム3の繰返しの処理を,スレッド3-1とスレッド3-2の二つに分割すると, [ d ] ことがあるので,スレッド並列法を適用しない場合の実行結果と等しくなることを保証できない。したがって,プログラム3に対しても,繰返しの範囲の分割によるスレッド並列法を適用できない。
cに関する解答群
dに関する解答群
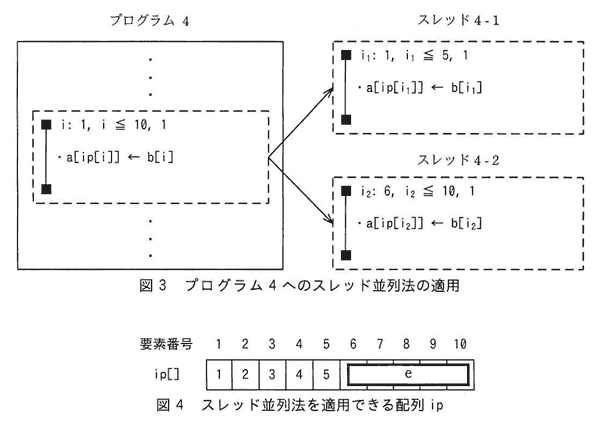
設問3 図3に示すプログラム4では,配列aにおける更新対象の位置を配列ipの要素の値で指しているる。このプログラムでは,配列ipの要素の値によって,スレッド並列法を適用できる場合とできない場合がある。
図4に示す配列ipであれば,スレッド並列法を適用できる。図4中の [ ] に入れる正しい答えを,解答群の中から選べ。
なお,図3において,実線の四角はプログラム,破線の四角は繰返しの処理,破線の四角から出る二つの矢印は分割を示す。
eに関する解答群
プログラム中の並列実行が可能な部分を取り出し,その部分を分割して複数のスレッドで並列に実行する方法(以下,スレッド並列法という)がある。マルチプロセッサシステムでは,スレッド並列法を適用することによって,プログラムの実行時間を短縮できることがある。
プログラムにおいて,スレッド並列法を適用しないで実行したときの実行時間を,スレッド並列法を適用したときの実行時間で割った値を,プログラム実行時間の高速化率という。
プログラムをスレッド並列法を適用しないで実行したときの,プログラム全体の実行時間に対する,並列実行可能な部分の実行時間の割合をr(0≦r≦1)とする。スレッドの個数をn(n≧1)にして,プログラムにスレッド並列法を適用すると,マルチプロセッサシステムでは,プログラム実行時間の高速化率Eは,次の式で求められる。ここで,各スレッドはそれぞれ異なるプロセッサに割り当てられるものとし,プログラムの実行に使用する全てのプロセッサの性能は同じとする。
この式は,並列実行可能な部分のプログラム実行時間がスレッド並列法の適用によって になり,その他の部分のプログラム実行時間は変化しないときの高速化率を計算するものである。
プログラム中に並列実行が可能な部分をもつプログラムAに対してスレッドの個数を2にしてスレッド並列法を適用すると,高速化率は になった。この場合,rは [ a ] である。
rが であるプログラムBの場合,スレッドの個数を増やしても,高速化率の上限は [ b ] である。
設問1 本文中の [ ] に入れる正しい答えを,解答群の中から選べ。
aに関する解答群
| ア | |
|---|---|
| イ | |
| ウ | |
| エ | |
| オ |
bに関する解答群
| ア | 2 |
|---|---|
| イ | 3 |
| ウ | 4 |
| エ | 6 |
| オ | 8 |
設問2 次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
配列の操作を行う繰返しの処理において,図1,図2のように繰返しの範囲を分割して,スレッド並列法を適用することを考える。
このとき,操作の内容によって,正しい結果が得られる場合と得られない場合があるので,十分に検討することが必要である。
正しい結果が得られる場合の例を,図1に示す。
図1に示すプログラム1は,制御変数iの取る範囲を分けることによって繰返し範囲を分割した繰返しの処理を,それぞれ異なるスレッドで実行できる。
なお,図1,図2において,実線の四角はプログラム,破線の四角は繰返しの処理,破線の四角から出る二つの矢印は分割を示す。
正しい結果が得られない場合の二つの例を,図2に示す。
プログラム2の繰返しの処理を,スレッド2-1とスレッド2-2の二つに分割すると, [ c ] ことがあるので,スレッド並列法を適用しない場合の実行結果と等しくなることを保証できない。したがって,プログラム2に対しては,繰返しの範囲の分割によるスレッド並列法を適用できない。
また,プログラム3の繰返しの処理を,スレッド3-1とスレッド3-2の二つに分割すると, [ d ] ことがあるので,スレッド並列法を適用しない場合の実行結果と等しくなることを保証できない。したがって,プログラム3に対しても,繰返しの範囲の分割によるスレッド並列法を適用できない。
cに関する解答群
| ア | a[51]の値をスレッド2-1で更新するより先にスレッド2-2で更新する |
|---|---|
| イ | a[51]の値をスレッド2-1で更新するより先にスレッド2-2で参照する |
| ウ | a[51]の値をスレッド2-1で参照するより先にスレッド2-2で更新する |
| エ | a[51]の値をスレッド2-1で参照するより先にスレッド2-2で参照する |
dに関する解答群
| ア | a[51]の値をスレッド3-1で更新するより先にスレッド3-2で更新する |
|---|---|
| イ | a[51]の値をスレッド3-1で更新するより先にスレッド3-2で参照する |
| ウ | a[51]の値をスレッド3-1で参照するより先にスレッド3-2で更新する |
| エ | a[51]の値をスレッド3-1で参照するより先にスレッド3-2で参照する |
設問3 図3に示すプログラム4では,配列aにおける更新対象の位置を配列ipの要素の値で指しているる。このプログラムでは,配列ipの要素の値によって,スレッド並列法を適用できる場合とできない場合がある。
図4に示す配列ipであれば,スレッド並列法を適用できる。図4中の [ ] に入れる正しい答えを,解答群の中から選べ。
なお,図3において,実線の四角はプログラム,破線の四角は繰返しの処理,破線の四角から出る二つの矢印は分割を示す。
eに関する解答群
| ア |
| |||||
|---|---|---|---|---|---|---|
| イ |
| |||||
| ウ |
| |||||
| エ |
|
答え : 設問1 (a)オ (b)ウ 設問2 (c)ウ (d)イ 設問3 (e)エ
分野 : テクノロジ系 › コンピュータシステム › ソフトウェア › オペレーティングシステム
分野 : テクノロジ系 › コンピュータシステム › ソフトウェア › オペレーティングシステム
問3
書籍及び貸出情報を管理する関係データベースの設計及び運用に関する次の記述を読んで,設問1~3に答えよ。
D社の部署である資料室は,業務に関連する書籍を所蔵しており,従業員への貸出しを2015年4月から実施している。
所蔵する書籍を管理するデータベースは,書籍の情報を管理する書籍情報表と貸出状況を管理する貸出表とで構成されている。データベース構成を,図1に示す。下線付きの項目は主キーを表し,下破線付きの項目は外部キーを表す。各書籍は1冊しか所蔵していない。
〔貸出表に関する説明〕
(1) 従業員に書籍を貸し出す際は,一意の貸出番号,貸し出す書籍のISBNコード,従業員番号,貸出日及び返却予定日を設定し,返却日にはNULLを設定したレコードを追加する。
(2) 書籍が返却されたら,対象のレコードの返却日に返却された日付を設定する。
設問1 次のSQL文は,ISBNコードが ISBN978-4-905318-63-7 の書籍の貸出し状態を表示するSQL文である。ISBNコードで貸出表を検索し,最も新しい貸出日のレコードの返却日に NULL が設定されている場合は,"貸出中"が表示される。また,最も新しい貸出日のレコードの返却日に日付が設定されている場合,及び貸出実績のない書籍の場合は, “貸出可” が表示される。 [ ] に入れる正しい答えを,解答群の中から選べ。ここで,検索に使用するISBNコードの書籍は必ず所蔵されているものとする。また,返却された書籍はその日のうちに再び貸し出されることはない。
SELECT 貸出表.ISBNコード,
CASE WHEN [ a ]
END AS 書籍状態
FROM 貸出表
WHERE 貸出表.ISBNコード = 'ISBN978-4-905318-63-7'
AND 貸出表.貸出日 = (SELECT [ b ] FROM 貸出表
WHERE 貸出表.ISBNコード = 'ISBN978-4-905318-63-7')
UNION ALL
SELECT DISTINCT 書籍情報表.ISBNコード,'貸出可' AS 書籍状態
FROM 書籍情報表
WHERE 書籍情報表.ISBNコード = 'ISBN978-4-905318-63-7'
AND NOT EXISTS (SELECT 貸出表.ISBNコード FROM 貸出表
WHERE 貸出表.ISBNコード = 'ISBN978-4-905318-63-7' )
aに関する解答群
bに関する解答群
設問2 2018年4月1日から2019年3月31日までの間に4回以上貸し出した書籍の一覧を取得することにした。次のSQL文の [ ] に入れる正しい答えを,解答群の中から選べ。
SELECT 書籍情報表.ISBNコード,書籍情報表.書籍名,COUNT(*) AS 貸出回数
FROM 書籍情報表,貸出表
WHERE 書籍情報表.ISBNコード = 貸出表.ISBNコード
[ c ]
cに関する解答群
設問3 従業員と資料室担当者の利便性を向上させる目的で,所蔵する書籍を管理するデータベースを再構築することにした。
データベースの再構築に当たり,従業員と資料室担当者から要望が出された。次の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。
〔従業員と資料室担当者からの要望〕
要望1 ISBNコードが同じ書籍を複数冊所蔵できるようにしたい。
要望2 書籍の購入日を管理できるようにしたい。
要望3 ISBNコードごとに所蔵する書籍数及び貸出し中の書籍数(以下,貸出中件数という)が分かるようにしたい。
要望4 ISBNコードが同じ書籍は同じラックに保管して,書籍が収納されているラックが分かるようにしたい。
従業員と資料室担当者からの要望を反映したデータベース構成案を,図2に示す。下線付きの項目は主キーを表し,下破線付きの項目は外部キーを表す。
〔要望に対するデータベース修正内容〕
修正1 要望1に対応するために書籍表を追加して,資料室で所蔵している各書籍に一意の書籍番号を割り振って,それを主キーとした。また,貸出表のISBNコードを書籍番号に変更した。
修正2 要望2に対応するために書籍表に購入日を設けた。
修正3 要望3に対応するために書籍管理ビューを追加した。
修正4 要望4に対応するためにラック表を追加して,書籍情報表に外部キーとしてラック番号を追加した。
要望を反映したデータベース構成案では,既に所蔵している書籍とISBNコードが同じ書籍を追加購入した場合に,レコードを追加する必要のある表は [ d ] である。
また,需要がなくなった書籍を廃棄する場合は,ISBNコードが同じ書籍を全て廃棄する。データベースに対して行う操作は,次の①~④を, [ e ] の順序で行う必要がある。
① 書籍情報表の主キーが対象ISBNコードのレコードを削除する。
② 書籍表から対象ISBNコードに対応する書籍番号を抽出する。
③ 書籍表の対象ISBNコードに対応するレコードを削除する。
④ 貸出表の対象書籍番号に対応するレコードを削除する。
dに関する解答群
eに関する解答群
D社の部署である資料室は,業務に関連する書籍を所蔵しており,従業員への貸出しを2015年4月から実施している。
所蔵する書籍を管理するデータベースは,書籍の情報を管理する書籍情報表と貸出状況を管理する貸出表とで構成されている。データベース構成を,図1に示す。下線付きの項目は主キーを表し,下破線付きの項目は外部キーを表す。各書籍は1冊しか所蔵していない。
図1 データベース構成
〔貸出表に関する説明〕
(1) 従業員に書籍を貸し出す際は,一意の貸出番号,貸し出す書籍のISBNコード,従業員番号,貸出日及び返却予定日を設定し,返却日にはNULLを設定したレコードを追加する。
(2) 書籍が返却されたら,対象のレコードの返却日に返却された日付を設定する。
設問1 次のSQL文は,ISBNコードが ISBN978-4-905318-63-7 の書籍の貸出し状態を表示するSQL文である。ISBNコードで貸出表を検索し,最も新しい貸出日のレコードの返却日に NULL が設定されている場合は,"貸出中"が表示される。また,最も新しい貸出日のレコードの返却日に日付が設定されている場合,及び貸出実績のない書籍の場合は, “貸出可” が表示される。 [ ] に入れる正しい答えを,解答群の中から選べ。ここで,検索に使用するISBNコードの書籍は必ず所蔵されているものとする。また,返却された書籍はその日のうちに再び貸し出されることはない。
SELECT 貸出表.ISBNコード,
CASE WHEN [ a ]
END AS 書籍状態
FROM 貸出表
WHERE 貸出表.ISBNコード = 'ISBN978-4-905318-63-7'
AND 貸出表.貸出日 = (SELECT [ b ] FROM 貸出表
WHERE 貸出表.ISBNコード = 'ISBN978-4-905318-63-7')
UNION ALL
SELECT DISTINCT 書籍情報表.ISBNコード,'貸出可' AS 書籍状態
FROM 書籍情報表
WHERE 書籍情報表.ISBNコード = 'ISBN978-4-905318-63-7'
AND NOT EXISTS (SELECT 貸出表.ISBNコード FROM 貸出表
WHERE 貸出表.ISBNコード = 'ISBN978-4-905318-63-7' )
aに関する解答群
| ア | 貸出表.返却日 IS NOT NULL THEN '貸出中' ELSE '貸出可' |
|---|---|
| イ | 貸出表.返却日 IS NOT NULL THEN '貸出中' WHEN 貸出表.返却日 IS NULL THEN '貸出可' |
| ウ | 貸出表.返却日 IS NULL THEN '貸出可' ELSE '貸出中' |
| エ | 貸出表.返却日 IS NULL THEN '貸出中' WHEN 貸出表.返却日 IS NOT NULL THEN '貸出可' |
bに関する解答群
| ア | DISTINCT 貸出表.貸出日 |
|---|---|
| イ | MAX(貸出表.貸出日) |
| ウ | MIN(貸出表.貸出日) |
| エ | 貸出表.貸出日 |
設問2 2018年4月1日から2019年3月31日までの間に4回以上貸し出した書籍の一覧を取得することにした。次のSQL文の [ ] に入れる正しい答えを,解答群の中から選べ。
SELECT 書籍情報表.ISBNコード,書籍情報表.書籍名,COUNT(*) AS 貸出回数
FROM 書籍情報表,貸出表
WHERE 書籍情報表.ISBNコード = 貸出表.ISBNコード
[ c ]
cに関する解答群
| ア | AND (貸出表.貸出日 >= '2018-04-01' OR 貸出表.貸出日 <= '2019-03-31') GROUP BY 書籍情報表.ISBNコード,書籍情報表.書籍名 HAVING COUNT(*) >= 4 |
|---|---|
| イ | AND 貸出表.貸出日 BETWEEN '2018-04-01' AND '2019-03-31' GROUP BY 書籍情報表.ISBNコード,書籍情報表.書籍名 HAVING COUNT(*) >= 4 |
| ウ | AND 貸出表.貸出日 >= '2018-04-01' AND 貸出表.貸出日 <= '2019-03-31' AND COUNT(*) >= 4 |
| エ | GROUP BY 書籍情報表.ISBNコード,書籍情報表.書籍名,貸出表.貸出日 HAVING 貸出表.貸出日 >= '2018-04-01' AND 貸出表.貸出日 <= '2019-03-31' AND COUNT(*) >= 4 |
設問3 従業員と資料室担当者の利便性を向上させる目的で,所蔵する書籍を管理するデータベースを再構築することにした。
データベースの再構築に当たり,従業員と資料室担当者から要望が出された。次の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。
〔従業員と資料室担当者からの要望〕
要望1 ISBNコードが同じ書籍を複数冊所蔵できるようにしたい。
要望2 書籍の購入日を管理できるようにしたい。
要望3 ISBNコードごとに所蔵する書籍数及び貸出し中の書籍数(以下,貸出中件数という)が分かるようにしたい。
要望4 ISBNコードが同じ書籍は同じラックに保管して,書籍が収納されているラックが分かるようにしたい。
従業員と資料室担当者からの要望を反映したデータベース構成案を,図2に示す。下線付きの項目は主キーを表し,下破線付きの項目は外部キーを表す。
書籍情報表(ISBNコード,書籍名,著者名,出版社名,出版年,ラック番号)
貸出表(貸出番号,書籍番号,従業員番号,貸出日,返却予定日,返却日)
書籍表(書籍番号,ISBNコード,購入日)
書籍管理ビュー(ISBNコード,所蔵書籍数,貸出中件数)
ラック表(ラック番号,ラック名)
貸出表(貸出番号,書籍番号,従業員番号,貸出日,返却予定日,返却日)
書籍表(書籍番号,ISBNコード,購入日)
書籍管理ビュー(ISBNコード,所蔵書籍数,貸出中件数)
ラック表(ラック番号,ラック名)
図2 要望を反映したデータベース構成案
〔要望に対するデータベース修正内容〕
修正1 要望1に対応するために書籍表を追加して,資料室で所蔵している各書籍に一意の書籍番号を割り振って,それを主キーとした。また,貸出表のISBNコードを書籍番号に変更した。
修正2 要望2に対応するために書籍表に購入日を設けた。
修正3 要望3に対応するために書籍管理ビューを追加した。
修正4 要望4に対応するためにラック表を追加して,書籍情報表に外部キーとしてラック番号を追加した。
要望を反映したデータベース構成案では,既に所蔵している書籍とISBNコードが同じ書籍を追加購入した場合に,レコードを追加する必要のある表は [ d ] である。
また,需要がなくなった書籍を廃棄する場合は,ISBNコードが同じ書籍を全て廃棄する。データベースに対して行う操作は,次の①~④を, [ e ] の順序で行う必要がある。
① 書籍情報表の主キーが対象ISBNコードのレコードを削除する。
② 書籍表から対象ISBNコードに対応する書籍番号を抽出する。
③ 書籍表の対象ISBNコードに対応するレコードを削除する。
④ 貸出表の対象書籍番号に対応するレコードを削除する。
dに関する解答群
| ア | 書籍表 |
|---|---|
| イ | 書籍表及びラック表 |
| ウ | 書籍情報表及び書籍表 |
| エ | 書籍情報表,書籍表及びラック表 |
eに関する解答群
| ア | ②→①→③→④ |
|---|---|
| イ | ②→①→④→③ |
| ウ | ②→③→①→④ |
| エ | ②→③→④→① |
| オ | ②→④→①→③ |
| カ | ②→④→③→① |
答え : 設問1 (a)エ (b)イ 設問2 (c)イ 設問3 (d)ア (e)カ
分野 : テクノロジ系 › 技術要素 › データベース › データ操作
分野 : テクノロジ系 › 技術要素 › データベース › データ操作
問4
NATに関する次の記述を読んで,設問1,2に答えよ。
IPv4のIPアドレスのうち,全世界で重複しないように管理されているグローバルIPアドレスはインターネットへの接続に利用でき,プライベートIPアドレスは社内LANなどの閉じたネットワークだけで利用できる。
プライベートIPアドレスだけが割り当てられている機器(以下,LAN内機器という)とインターネットに接続されている外部の機器(以下,インターネット機器という)とは直接通信することはできないが,例えば,NAT(Network Address Translation)を使うことによって通信することができるようになる。
本問で扱うNATは,NAPT(Network Address Port Translation)とも呼ばれる,ルータが搭載している機能であり,通過するパケットのIPアドレス及びポート番号を書き換えることによって,LAN内機器とインターネット機器との通信を可能にする。表1に,LAN内機器とインターネット機器との通信の際にルータを通過するパケットの,IPアドレス及びポート番号の書換えの概要を示す。ここで,送信パケットとはLAN内機器がインターネット機器に向けて送信するパケットのことをいい,受信パケットとはルータがインターネット機器から受信するパケットのことをいう。
NATには,静的NATと動的NATがある。
静的NATでは,ルータのグローバルIPアドレス及びルータのポート番号の組みとLAN内機器のIPアドレス及びLAN内機器のポート番号の組みとの対応をあらかじめ定義しておき,その定義に基づいて,送信パケットと受信パケットの書換え対象のIPアドレス及びポート番号を書き換える。
動的NATでは,送信パケットと受信パケットの書換え対象のIPアドレス及びポート番号を,次のように書き換える。
(1) 送信パケットの送信元IPアドレス及び送信元ポート番号の書換え
① 送信パケットの送信元IPアドレス及び送信元ポート番号の,書換え前の組み(LAN内機器のIPアドレス及びLAN内機器のポート番号の組み)と書換え後の組み(ルータのグローバルIPアドレス及びルータのポート番号の組み)とを,関連付けて一定期間記憶する。
② 送信パケットの送信元IPアドレス及び送信元ポート番号の組みを,書換え前の組みとして記憶している間は,関連付けられている書換え後の組みに書き換える。
③ 送信パケットの送信元IPアドレス及び送信元ポート番号の組みを,書換え前の組みとして記憶していないときは,ルータに割り当てられている幾つかのグローバルIPアドレスのうちの一つと,そのIPアドレスで使用されていないポート番号のうちの一つとの組みに書き換える。
(2) 受信パケットの宛先IPアドレス及び宛先ポート番号の書換え
① 受信パケットの宛先IPアドレスと宛先ポート番号の組みが,上記(1)①の書換え後の組みとして記憶されている間は,関連付けられている書換え前の組みに書き換える。
設問1 次の(1)~(3)のケースのうち,静的NATよりも動的NATの方が適しているものを,解答群の中から選べ。
(1) インターネット機器からアクセス可能なサーバを,LAN内機器として設置する。
(2) LAN内機器から,インターネット機器にアクセスする。
(3) インターネットを介する異なるLANのLAN内機器同士が,あらかじめ決まった固定のポートを使い,相互に通信する。
解答群
設問2 次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。ここで,a1~a3に入れる答えは,aに関する解答群の中から組合せとして正しいものを選ぶものとする。
IPv6とIPv4とは互換性がないので,IPv6のネットワーク内の機器(以下,IPv6機器という)とIPv4のネットワーク内の機器(以下,IPv4機器という)とは直接通信することができない。IPv6機器からIPv4機器にアクセスする方法の一つに,NATの機能を拡張したNAT64と,DNSの機能を拡張したDNS64との組合せによる方法がある。この方法によるIPv6機器からIPv4機器へのアクセスの流れを次に示す。
(1) IPv6機器は,アクセス先の機器のIPアドレスを,DNS64から入手する。DNS64は [ a1 ] のネットワークに置かれるDNSであり,ホスト名に対応するIPアドレスの問合せに対し,対応する [ a2 ] アドレスがあればそれを返し,対応する [ a2 ] アドレスがなく, [ a3 ] アドレスがあればそれを [ a2 ] アドレスに変換して返す。ここで,IPv4アドレスのIPv6アドレス表現は,当該IPv4アドレスを示す4バイトの前に,あらかじめ決められた12バイトのプレフィックスを付加したものである。
(2) IPv6機器は,入手したIPアドレスに宛ててIPv6のパケットを送信する。
(3) (2)のパケットがIPv4機器向けならば,当該パケットとその返信パケットは,NAT64の機能をもつルータ(以下,NAT64ルータという)が受信する。
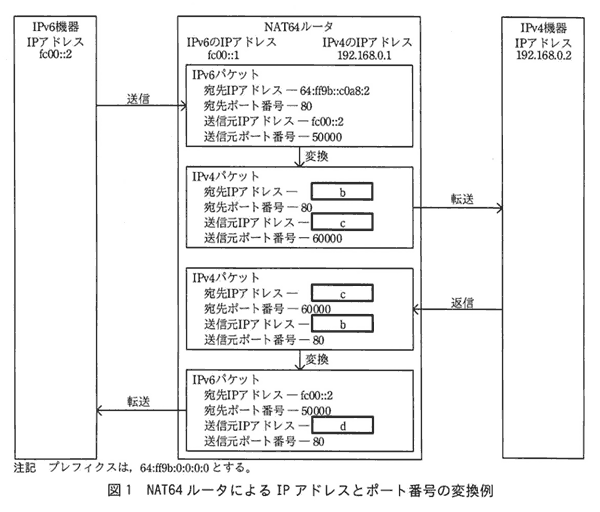
(4) NAT64ルータは,IPv6機器からIPv4機器に向けて送信されたIPv6のパケットをIPv4のパケットに,その返信パケットであるIPv4のパケットをIPv6のパケットに,それぞれ変換し,転送する。このとき,IPアドレス及びポート番号は,動的NATによる書換えの考え方を用いて変換する。NAT64ルータによるIPアドレスとポート番号の変換例を,図1に示す。
aに関する解答群
b,c,dに関する解答群
IPv4のIPアドレスのうち,全世界で重複しないように管理されているグローバルIPアドレスはインターネットへの接続に利用でき,プライベートIPアドレスは社内LANなどの閉じたネットワークだけで利用できる。
プライベートIPアドレスだけが割り当てられている機器(以下,LAN内機器という)とインターネットに接続されている外部の機器(以下,インターネット機器という)とは直接通信することはできないが,例えば,NAT(Network Address Translation)を使うことによって通信することができるようになる。
本問で扱うNATは,NAPT(Network Address Port Translation)とも呼ばれる,ルータが搭載している機能であり,通過するパケットのIPアドレス及びポート番号を書き換えることによって,LAN内機器とインターネット機器との通信を可能にする。表1に,LAN内機器とインターネット機器との通信の際にルータを通過するパケットの,IPアドレス及びポート番号の書換えの概要を示す。ここで,送信パケットとはLAN内機器がインターネット機器に向けて送信するパケットのことをいい,受信パケットとはルータがインターネット機器から受信するパケットのことをいう。
| 書換え対象 | 書換え前 | 書換え後 | |
| 送信 パケット | 送信元IPアドレス | LAN内機器のIPアドレス | ルータのグローバルIPアドレス |
| 送信元ポート番号 | LAN内機器のポート番号 | ルータのポート番号 | |
| 受信 パケット | 宛先IPアドレス | ルータのグローバルIPアドレス | LAN内機器のIPアドレス |
| 宛先ポート番号 | ルータのポート番号 | LAN内機器のポート番号 |
NATには,静的NATと動的NATがある。
静的NATでは,ルータのグローバルIPアドレス及びルータのポート番号の組みとLAN内機器のIPアドレス及びLAN内機器のポート番号の組みとの対応をあらかじめ定義しておき,その定義に基づいて,送信パケットと受信パケットの書換え対象のIPアドレス及びポート番号を書き換える。
動的NATでは,送信パケットと受信パケットの書換え対象のIPアドレス及びポート番号を,次のように書き換える。
(1) 送信パケットの送信元IPアドレス及び送信元ポート番号の書換え
① 送信パケットの送信元IPアドレス及び送信元ポート番号の,書換え前の組み(LAN内機器のIPアドレス及びLAN内機器のポート番号の組み)と書換え後の組み(ルータのグローバルIPアドレス及びルータのポート番号の組み)とを,関連付けて一定期間記憶する。
② 送信パケットの送信元IPアドレス及び送信元ポート番号の組みを,書換え前の組みとして記憶している間は,関連付けられている書換え後の組みに書き換える。
③ 送信パケットの送信元IPアドレス及び送信元ポート番号の組みを,書換え前の組みとして記憶していないときは,ルータに割り当てられている幾つかのグローバルIPアドレスのうちの一つと,そのIPアドレスで使用されていないポート番号のうちの一つとの組みに書き換える。
(2) 受信パケットの宛先IPアドレス及び宛先ポート番号の書換え
① 受信パケットの宛先IPアドレスと宛先ポート番号の組みが,上記(1)①の書換え後の組みとして記憶されている間は,関連付けられている書換え前の組みに書き換える。
設問1 次の(1)~(3)のケースのうち,静的NATよりも動的NATの方が適しているものを,解答群の中から選べ。
(1) インターネット機器からアクセス可能なサーバを,LAN内機器として設置する。
(2) LAN内機器から,インターネット機器にアクセスする。
(3) インターネットを介する異なるLANのLAN内機器同士が,あらかじめ決まった固定のポートを使い,相互に通信する。
解答群
| ア | (1)だけ |
|---|---|
| イ | (1)と(2) |
| ウ | (1)と(3) |
| エ | (2)だけ |
| オ | (2)と(3) |
| カ | (3)だけ |
設問2 次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。ここで,a1~a3に入れる答えは,aに関する解答群の中から組合せとして正しいものを選ぶものとする。
IPv6とIPv4とは互換性がないので,IPv6のネットワーク内の機器(以下,IPv6機器という)とIPv4のネットワーク内の機器(以下,IPv4機器という)とは直接通信することができない。IPv6機器からIPv4機器にアクセスする方法の一つに,NATの機能を拡張したNAT64と,DNSの機能を拡張したDNS64との組合せによる方法がある。この方法によるIPv6機器からIPv4機器へのアクセスの流れを次に示す。
(1) IPv6機器は,アクセス先の機器のIPアドレスを,DNS64から入手する。DNS64は [ a1 ] のネットワークに置かれるDNSであり,ホスト名に対応するIPアドレスの問合せに対し,対応する [ a2 ] アドレスがあればそれを返し,対応する [ a2 ] アドレスがなく, [ a3 ] アドレスがあればそれを [ a2 ] アドレスに変換して返す。ここで,IPv4アドレスのIPv6アドレス表現は,当該IPv4アドレスを示す4バイトの前に,あらかじめ決められた12バイトのプレフィックスを付加したものである。
(2) IPv6機器は,入手したIPアドレスに宛ててIPv6のパケットを送信する。
(3) (2)のパケットがIPv4機器向けならば,当該パケットとその返信パケットは,NAT64の機能をもつルータ(以下,NAT64ルータという)が受信する。
(4) NAT64ルータは,IPv6機器からIPv4機器に向けて送信されたIPv6のパケットをIPv4のパケットに,その返信パケットであるIPv4のパケットをIPv6のパケットに,それぞれ変換し,転送する。このとき,IPアドレス及びポート番号は,動的NATによる書換えの考え方を用いて変換する。NAT64ルータによるIPアドレスとポート番号の変換例を,図1に示す。
aに関する解答群
| a1 | a2 | a3 | |
| ア | IPv4 | IPv4 | IPv6 |
| イ | IPv4 | IPv6 | IPv4 |
| ウ | IPv6 | IPv4 | IPv6 |
| エ | IPv6 | IPv6 | IPv4 |
b,c,dに関する解答群
| ア | 192.168.0.0 |
|---|---|
| イ | 192.168.0.1 |
| ウ | 192.168.0.2 |
| エ | 64:ff9b:: |
| オ | 64:ff9b::c0a8:1 |
| カ | 64:ff9b::c0a8:2 |
| キ | fc00:: |
| ク | fc00::1 |
| ケ | fc00::2 |
答え : 設問1 エ 設問2 (a)エ (b)ウ (c)イ (d)カ
分野 : テクノロジ系 › 技術要素 › ネットワーク › ネットワーク管理
分野 : テクノロジ系 › 技術要素 › ネットワーク › ネットワーク管理
問5
ストレスチェックの検査支援を行うシステムに関する次の記述を読んで,設問1,2に答えよ。
K社は,厚生労働省が作成した"労働安全衛生法に基づくストレスチェック制度実施マニュアル(平成28年4月改訂)"を基に,労働者の,職業上の心理的な負担の程度を把握するための検査を支援するシステムを開発している。このシステムは,"職業性ストレス簡易調査票"の質問の全てに回答が入力されると,質問項目の領域ごとに回答の合計点を求めて,高ストレス者を簡易的に判別する。
〔職業性ストレス簡易調査票の説明〕
(1) 職業性ストレス簡易調査票には,全部で57項目の質問があり,次の4領域に分類される。
領域A 職場における当該労働者の心理的な負担の原因に関する質問(17項目)
領域B 心理的な負担による心身の自覚症状に関する質問(29項目)
領域C 職場における他の労働者による当該労働者への支援に関する質問(9項目)
領域D 仕事及び家庭生活の満足度に関する質問(2項目)
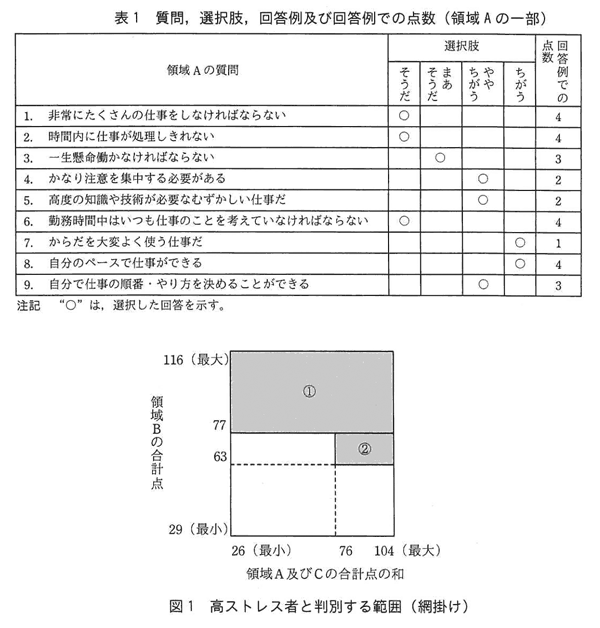
(2) 各質問に対して,四つの選択肢から一つを選択して回答する。各選択肢には,あらかじめ点数(1,2,3,4点のいずれか)が割り振られている。領域Aの一部を例に,質問,選択肢,回答例及び回答例での点数を,表1に示す。
〔高ストレス者を判別する方法〕
(1) 領域ごとに,質問に対する回答の合計点を求める。
(2) 次のいずれかを満たす場合に,高ストレス者と判別する。領域Dの合計点は,高ストレス者の判別には利用しない。
① 領域Bの合計点が77点以上である。
② 領域Bの合計点が63点以上76点以下であって,かつ,領域A及びCの合計点の和が76点以上である。
合計点によって高ストレス者と判別する〔高ストレス者を判別する方法〕の(2)の①及び②の範囲を,図1に示す。図1の網掛けの範囲に入る場合は高ストレス者であるとし,それ以外の場合は高ストレス者ではないとする。
設問1 図2中の [ ] に入れる正しい答えを,解答群の中から選べ。
職業性ストレス簡易調査票の回答結果から高ストレス者を判別する処理の流れ図を,図2に示す。変数"判別結果"に初期値として0を格納しておき,高ストレス者と判別した場合は,"判別結果"に1を格納する。
a,b,c,dに関する解答群
設問2 次の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。
このシステムのテストに備えてテストデータを用意した。各テストデータは,領域A~Cの回答の合計点が表2に示す合計点になるように回答が入力された職業性ストレス簡易調査票である。
図1に基づいて,①,②及びそれ以外の場合を判別できるかどうかをテストするには,テストデータ [ e ] を使用する。また,図2の流れ図で,分岐による全てのパスを通るテストをするには,テストデータ [ f ] を使用する。ここで,どちらのテストも,使用するテストデータの件数が最少となるように実施する。
e,fに関する解答群
K社は,厚生労働省が作成した"労働安全衛生法に基づくストレスチェック制度実施マニュアル(平成28年4月改訂)"を基に,労働者の,職業上の心理的な負担の程度を把握するための検査を支援するシステムを開発している。このシステムは,"職業性ストレス簡易調査票"の質問の全てに回答が入力されると,質問項目の領域ごとに回答の合計点を求めて,高ストレス者を簡易的に判別する。
〔職業性ストレス簡易調査票の説明〕
(1) 職業性ストレス簡易調査票には,全部で57項目の質問があり,次の4領域に分類される。
領域A 職場における当該労働者の心理的な負担の原因に関する質問(17項目)
領域B 心理的な負担による心身の自覚症状に関する質問(29項目)
領域C 職場における他の労働者による当該労働者への支援に関する質問(9項目)
領域D 仕事及び家庭生活の満足度に関する質問(2項目)
(2) 各質問に対して,四つの選択肢から一つを選択して回答する。各選択肢には,あらかじめ点数(1,2,3,4点のいずれか)が割り振られている。領域Aの一部を例に,質問,選択肢,回答例及び回答例での点数を,表1に示す。
〔高ストレス者を判別する方法〕
(1) 領域ごとに,質問に対する回答の合計点を求める。
(2) 次のいずれかを満たす場合に,高ストレス者と判別する。領域Dの合計点は,高ストレス者の判別には利用しない。
① 領域Bの合計点が77点以上である。
② 領域Bの合計点が63点以上76点以下であって,かつ,領域A及びCの合計点の和が76点以上である。
合計点によって高ストレス者と判別する〔高ストレス者を判別する方法〕の(2)の①及び②の範囲を,図1に示す。図1の網掛けの範囲に入る場合は高ストレス者であるとし,それ以外の場合は高ストレス者ではないとする。
設問1 図2中の [ ] に入れる正しい答えを,解答群の中から選べ。
職業性ストレス簡易調査票の回答結果から高ストレス者を判別する処理の流れ図を,図2に示す。変数"判別結果"に初期値として0を格納しておき,高ストレス者と判別した場合は,"判別結果"に1を格納する。
a,b,c,dに関する解答群
| ア | 62点以下 |
|---|---|
| イ | 62点以上 |
| ウ | 63点以下 |
| エ | 63点以上 |
| オ | 63点以上かつ76点以下 |
| カ | 63点以上かつ77点以下 |
| キ | 75点以下 |
| ク | 76点以上 |
設問2 次の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。
このシステムのテストに備えてテストデータを用意した。各テストデータは,領域A~Cの回答の合計点が表2に示す合計点になるように回答が入力された職業性ストレス簡易調査票である。
図1に基づいて,①,②及びそれ以外の場合を判別できるかどうかをテストするには,テストデータ [ e ] を使用する。また,図2の流れ図で,分岐による全てのパスを通るテストをするには,テストデータ [ f ] を使用する。ここで,どちらのテストも,使用するテストデータの件数が最少となるように実施する。
| テストデータ | 領域Aの合計点 | 領域Bの合計点 | 領域Cの合計点 |
| 1 | 34 | 63 | 18 |
| 2 | 34 | 87 | 27 |
| 3 | 34 | 63 | 36 |
| 4 | 51 | 87 | 36 |
| 5 | 51 | 58 | 36 |
| 6 | 51 | 66 | 36 |
e,fに関する解答群
| ア | 1,2及び3 |
|---|---|
| イ | 1,2及び4 |
| ウ | 1,3及び6 |
| エ | 2,4及び6 |
| オ | 4,5及び6 |
| カ | 1,2,3及び4 |
| キ | 1,3,4及び5 |
| ク | 1,4,5及び6 |
| ケ | 2,3,4及び5 |
| コ | 2,4,5及び6 |
答え : 設問1 (a)ア (b)オ (c)ク (d)キ 設問2 (e)オ (f)ク
分野 : テクノロジ系 › 開発技術 › システム開発技術 › 実装・構築
分野 : テクノロジ系 › 開発技術 › システム開発技術 › 実装・構築
問6
販売管理システム開発の結合テストにおける進捗及び品質管理に関する次の記述を読んで,設問1~3に答えよ。
製造業のP社では,販売管理システムを構築するプロジェクト(以下,Qプロジェクトという)を進めており,情報システム部門のRさんがプロジェクトマネージャを担当している。P社では,結合テスト工程において,バグ管理図を用いて,テストの進捗とソフトウェアの品質を評価している。本問におけるバグ管理図とは,横軸に結合テスト期間の経過率を,縦軸に未消化テスト項目数及び累積バグ検出数を表したグラフのことである。
P社では,過去のシステム構築の実績値を基に,テスト項目数及びバグ検出数の標準値を定めており,Qプロジェクトの結合テストで用いる,テスト項目1件当たりのバグ検出数の標準値は,0.02件である。Qプロジェクトにおける結合テスト期間の経過率ごとの未消化テスト項目数及び累積バグ検出数の計画値を,表1に示す。
Qプロジェクトでは,未消化テスト項目数,消化済テスト項目数及び累積バグ検出数の計画値と実績値から進捗と品質を評価する。また,結合テスト工程では,累積バグ検出数の実績値が,消化済テスト項目数の実績値に基づいて算出した累積バグ検出数の計画値の±25%の範囲内の場合,品質に問題はないと判断する。
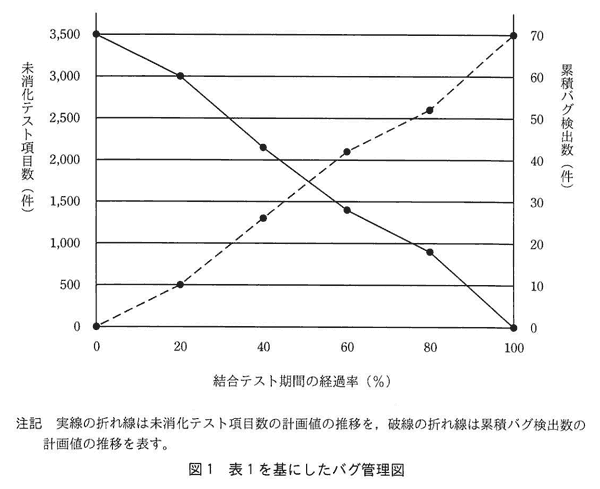
表1を基にしたバグ管理図を,図1に示す。Rさんは,図1に示すバグ管理図に,結合テスト期間の60%が経過した時点(以下,60%経過時点という)の未消化テスト項目数及び累積バグ検出数の実績値をプロットして進捗と品質を評価することにした。結合テストの担当者は,検出したバグの原因調査と修正も行う。結合テストの担当者A~Eそれぞれのテスト項目数の計画値と60%経過時点での消化済テスト項目数及び累積バグ検出数の実績値を,表2に示す。60%経過時点での結合テスト全体の未消化テスト項目数の実績値は図1の [ a ],累積バグ検出数の実績値は図1の [ b ]。Rさんはプロットした結果を基に,結合テストは計画どおりには進捗していないと判断した。また,担当者A~Eの60%経過時点での累積バグ検出数の実績値の合計値は,担当者A~Eの60%経過時点での消化済テスト項目数の実績値の合計値に,バグ検出数の標準値である0.02を乗じて算出した累積バグ検出数の [ c ] と判断した。
設問1 本文中の [ ] に入れる適切な答えを,解答群の中から選べ。
aに関する解答群
bに関する解答群
cに関する解答群
設問2 次の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。
Rさんは,更に結合テストの担当者ごとの進捗を評価することにした。60%経過時点での担当者ごとの消化済テスト項目数の計画値は,次の式で求める。
60%経過時点での消化済テスト項目数の計画値は,表1で示す未消化テスト項目数の計画値に基づいて算出した値である。60%経過時点での担当者ごとの消化済テスト項目数の計画値を,表3に示す。
注記 網掛けの部分は表示していない。
Qプロジェクトでは,結合テスト工程において,消化済テスト項目数の実績値が計画値の±10%の範囲内の場合,進捗に問題はないと判断する。Bさん,Cさん,Dさんの消化済テスト項目数の実績値は計画値の±10%の範囲内であり,累積バグ検出数の実績値も60%経過時点での消化済テスト項目数の実績値に基づいて算出した累積バグ検出数の計画値の±25%の範囲内なので,進捗及び品質に問題はないと判断した。
Aさんが担当するテストの進捗とソフトウェアの品質に基づく判断は,次のとおりである。
・進捗:消化済テスト項目数の実績値が計画値の90%未満なので,進捗は遅れている。
・品質:バグの検出及び検出したバグの原因調査と修正は,順調に行われている。60%経過時点での消化済テスト項目数の実績値に基づいて算出した累積バグ検出数の計画値は4.2件であり,累積バグ検出数の実績値は計画値の±25%の範囲内なので,品質に問題はない。
Rさんは,Aさんが担当するテストの進捗が遅れているので,Aさんの作業に問題がないかどうかを確認した。テスト項目の内容及びテスト手順は正しく,報告書も適切に記載されていたが,結合テストデータの作成に時間を要していることが分かった。そこで,Rさんは,Aさんの進捗遅れに対して,[ e ] という対応を実施することにした。
dに関する解答群
eに関する解答群
設問3 次の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。
Rさんは,60%経過時点でのEさんの消化済テスト項目数の実績値が計画値の90%未満であり,累積バグ検出数の実績値が消化済テスト項目数の実績値に基づいて算出した累積バグ検出数の計画値よりも大きくなっていたので,原因を調査することにした。Eさんは,Eさん以外の担当者が単体テストまでを行った機能1~5の結合テストを担当している。各機能は独立してテストが可能であり,機能1から順番にテストを行う計画である。
調査の結果,Eさんは機能1のテストは順調に完了したが,機能2のテストがはかどっていないことが分かった。理由を確認すると,機能2はバグの検出数が多く,バグの原因調査に時間を要したからであった。そこで,これまでに機能2で検出されたバグの原因を調査した結果,"詳細設計書の論理誤り"が多く見受けられた。Rさんは,更に,機能2の詳細設計を担当した者(以下,機能2担当者という)が詳細設計を担当した他の機能について,その結合テストの進捗を確認したところ,いずれの機能も結合テストの開始前であった。いずれの機能も,機能2と同じように問題が発生するおそれがあるので,Rさんは,販売管理システムに精通した要員を追加して, [ f ] を実施することにした。
fに関する解答群
製造業のP社では,販売管理システムを構築するプロジェクト(以下,Qプロジェクトという)を進めており,情報システム部門のRさんがプロジェクトマネージャを担当している。P社では,結合テスト工程において,バグ管理図を用いて,テストの進捗とソフトウェアの品質を評価している。本問におけるバグ管理図とは,横軸に結合テスト期間の経過率を,縦軸に未消化テスト項目数及び累積バグ検出数を表したグラフのことである。
P社では,過去のシステム構築の実績値を基に,テスト項目数及びバグ検出数の標準値を定めており,Qプロジェクトの結合テストで用いる,テスト項目1件当たりのバグ検出数の標準値は,0.02件である。Qプロジェクトにおける結合テスト期間の経過率ごとの未消化テスト項目数及び累積バグ検出数の計画値を,表1に示す。
Qプロジェクトでは,未消化テスト項目数,消化済テスト項目数及び累積バグ検出数の計画値と実績値から進捗と品質を評価する。また,結合テスト工程では,累積バグ検出数の実績値が,消化済テスト項目数の実績値に基づいて算出した累積バグ検出数の計画値の±25%の範囲内の場合,品質に問題はないと判断する。
| 結合テスト期間の経過率(%) | 0 | 20 | 40 | 60 | 80 | 100 |
| 未消化テスト項目数(件) | 3,500 | 3,000 | 2,200 | 1,400 | 900 | 0 |
| 累積バグ検出数(件) | 0 | 10 | 26 | 42 | 52 | 70 |
表1を基にしたバグ管理図を,図1に示す。Rさんは,図1に示すバグ管理図に,結合テスト期間の60%が経過した時点(以下,60%経過時点という)の未消化テスト項目数及び累積バグ検出数の実績値をプロットして進捗と品質を評価することにした。結合テストの担当者は,検出したバグの原因調査と修正も行う。結合テストの担当者A~Eそれぞれのテスト項目数の計画値と60%経過時点での消化済テスト項目数及び累積バグ検出数の実績値を,表2に示す。60%経過時点での結合テスト全体の未消化テスト項目数の実績値は図1の [ a ],累積バグ検出数の実績値は図1の [ b ]。Rさんはプロットした結果を基に,結合テストは計画どおりには進捗していないと判断した。また,担当者A~Eの60%経過時点での累積バグ検出数の実績値の合計値は,担当者A~Eの60%経過時点での消化済テスト項目数の実績値の合計値に,バグ検出数の標準値である0.02を乗じて算出した累積バグ検出数の [ c ] と判断した。
| 担当者 | A | B | C | D | E |
| 担当するテスト項目数(計画値) | 500 | 700 | 700 | 800 | 800 |
| 60%経過時点での消化済テスト項目数(実績値) | 210 | 390 | 400 | 450 | 300 |
| 60%経過時点での累積バグ検出数(実績値) | 4 | 9 | 8 | 11 | 13 |
設問1 本文中の [ ] に入れる適切な答えを,解答群の中から選べ。
aに関する解答群
| ア | 実線の折れ線が示す未消化テスト項目数の値より大きく |
|---|---|
| イ | 実線の折れ線が示す未消化テスト項目数の値と等しく |
| ウ | 実線の折れ線が示す未消化テスト項目数の値より小さく |
bに関する解答群
| ア | 破線の折れ線が示す累積バグ検出数の値より大きい |
|---|---|
| イ | 破線の折れ線が示す累積バグ検出数の値と等しい |
| ウ | 破線の折れ線が示す累積バグ検出数の値より小さい |
cに関する解答群
| ア | 計画値の75%未満なので,品質に問題がある |
|---|---|
| イ | 計画値の75%以上100%未満なので,品質に問題はない |
| ウ | 計画値の100%以上125%以下なので,品質に問題はない |
| エ | 計画値の125%を超えているので,品質に問題がある |
設問2 次の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。
Rさんは,更に結合テストの担当者ごとの進捗を評価することにした。60%経過時点での担当者ごとの消化済テスト項目数の計画値は,次の式で求める。
| 担当するテスト項目数 の計画値 |
60%経過時点での消化済テスト項目数の計画値 |
| × ━━━━━━━━━━━━━━━━━━━━ | |
| 結合テスト全体のテスト項目数の計画値 |
60%経過時点での消化済テスト項目数の計画値は,表1で示す未消化テスト項目数の計画値に基づいて算出した値である。60%経過時点での担当者ごとの消化済テスト項目数の計画値を,表3に示す。
| 担当者 | A | B | C | D | E |
| 消化済テスト項目数 | 300 | [ d ] | 480 | 480 |
Qプロジェクトでは,結合テスト工程において,消化済テスト項目数の実績値が計画値の±10%の範囲内の場合,進捗に問題はないと判断する。Bさん,Cさん,Dさんの消化済テスト項目数の実績値は計画値の±10%の範囲内であり,累積バグ検出数の実績値も60%経過時点での消化済テスト項目数の実績値に基づいて算出した累積バグ検出数の計画値の±25%の範囲内なので,進捗及び品質に問題はないと判断した。
Aさんが担当するテストの進捗とソフトウェアの品質に基づく判断は,次のとおりである。
・進捗:消化済テスト項目数の実績値が計画値の90%未満なので,進捗は遅れている。
・品質:バグの検出及び検出したバグの原因調査と修正は,順調に行われている。60%経過時点での消化済テスト項目数の実績値に基づいて算出した累積バグ検出数の計画値は4.2件であり,累積バグ検出数の実績値は計画値の±25%の範囲内なので,品質に問題はない。
Rさんは,Aさんが担当するテストの進捗が遅れているので,Aさんの作業に問題がないかどうかを確認した。テスト項目の内容及びテスト手順は正しく,報告書も適切に記載されていたが,結合テストデータの作成に時間を要していることが分かった。そこで,Rさんは,Aさんの進捗遅れに対して,[ e ] という対応を実施することにした。
dに関する解答群
| ア | 280 |
|---|---|
| イ | 300 |
| ウ | 360 |
| エ | 420 |
eに関する解答群
| ア | テスト項目を再度洗い出す |
|---|---|
| イ | テスト要員を追加する |
| ウ | テストデータを再作成する |
| エ | テスト証跡の記載を一部省略する |
| オ | テストの結果をAさんの結合テスト完了後に確認する |
設問3 次の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。
Rさんは,60%経過時点でのEさんの消化済テスト項目数の実績値が計画値の90%未満であり,累積バグ検出数の実績値が消化済テスト項目数の実績値に基づいて算出した累積バグ検出数の計画値よりも大きくなっていたので,原因を調査することにした。Eさんは,Eさん以外の担当者が単体テストまでを行った機能1~5の結合テストを担当している。各機能は独立してテストが可能であり,機能1から順番にテストを行う計画である。
調査の結果,Eさんは機能1のテストは順調に完了したが,機能2のテストがはかどっていないことが分かった。理由を確認すると,機能2はバグの検出数が多く,バグの原因調査に時間を要したからであった。そこで,これまでに機能2で検出されたバグの原因を調査した結果,"詳細設計書の論理誤り"が多く見受けられた。Rさんは,更に,機能2の詳細設計を担当した者(以下,機能2担当者という)が詳細設計を担当した他の機能について,その結合テストの進捗を確認したところ,いずれの機能も結合テストの開始前であった。いずれの機能も,機能2と同じように問題が発生するおそれがあるので,Rさんは,販売管理システムに精通した要員を追加して, [ f ] を実施することにした。
fに関する解答群
| ア | Eさんがテストを担当した機能の詳細設計書の再レビュー |
|---|---|
| イ | 機能2担当者が担当した機能の詳細設計書の再レビュー |
| ウ | 全機能の詳細設計書の再レビュー |
| エ | 販売管理システムの要件を理解するための勉強会 |
答え : 設問1 (a)ア (b)ア (c)エ 設問2 (d)エ (e)イ 設問3 (f)イ
分野 : テクノロジ系 › 開発技術 › システム開発技術 › 統合・テスト
分野 : テクノロジ系 › 開発技術 › システム開発技術 › 統合・テスト
問7
製品別の収益分析に関する次の記述を読んで,設問1~3に答えよ。
S社は,製品X,製品Y,製品Zを販売している。S社では,収益改善を目的にして,製品別の営業利益と営業利益率に関する分析を行っている。製品別の前年度実績を,表1に示す。
なお,本問における営業利益率などのパーセント(%)表記の値は,表においては,小数第1位を四捨五入して,整数で表示している。他の文中のパーセント(%)表記の値は,そのままの値を示している。
注記 営業費用は,売上原価と販売費及び一般管理費で構成される。
設問1 営業利益率の改善に関する次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
製品Xは,S社の売上高の半分以上を占めているが,営業利益率は全製品の中で最も低くなっている。そこでS社は,製品Xの営業利益率を上げるための施策を検討することにした。
製品Xの営業利益率を,ほかの製品の前年度実績を上回る16%にするためには,営業費用が前年度と同額ならば,売上高を [ a ] 百万円増やす必要がある。売上高が前年度と同額ならば,営業費用を [ b ] 百万円減らす必要がある。
aに関する解答群
bに関する解答群
設問2 収益改善に関する次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。ここで,c1とc2に入れる答えは,cに関する解答群の中から組合せとして正しいものを選ぶものとする。
S社は,各製品の収益を分析するために,製品別の営業費用を調査し,営業費用を固定費と変動費に分けた。調査結果を,表2に示す。ここで,固定費は販売数量の増減にかかわらず発生する一定額の費用のことであり,変動費は販売数量に比例して変化する費用のことである。
次にS社は,各製品の安全余裕率の分析を行った。安全余裕率は,売上高と損益分岐点売上高との差から算出される指標であり,数値が大きいほど売上高が低下した場合に赤字になる可能性が低いといった余裕度を示す。安全余裕率を求める式は,次のとおりである。安全余裕率に関わる項目の値を表3に,S社が定めている安全余裕率の基準とその状態を表4に示す。
限界利益率 = (売上高 - 変動費)÷ 売上高
損益分岐点売上高 = 固定費 ÷ 限界利益率
安全余裕率 = (売上高 - 損益分岐点売上高)÷ 売上高
表3の安全余裕率を見ると,製品Xは危険な状態にある。S社は,固定費を削減することによって,前年度実績と同じ売上高で安全余裕率20%を達成できるように,製品Xの固定費の削減目標の値を [ c1 ] 百万円と設定した。S社は,この目標値を達成するために,製品Xだけを販売している営業所を統廃合して賃借料などの固定費を削減することとした。ここで,営業所の統廃合によって製品Xの売上高は変化しないものとし,統廃合時に一時的に発生する費用は考慮しない。
さらに,統廃合の結果として削減される製品Xの固定費の削減金額 [ c1 ] 百万円を製品Zの固定費である人件費に追加して,営業を強化することにした。これによって,製品Zの固定費は [ c1 ] 百万円増えるが,売上高は1,000百万円に増やせると見込んだ。ここで,製品1個当たりの販売価格は販売数量にかかわらず同じとする。安全余裕率に関わる項目の試算値を,表5に示す。
注記 網掛けの部分は表示していない。
cに関する解答群
設問3 営業利益率の試算に関する次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
S社では,製品Xの売上高を確保するために,販売時に本来の販売価格に対して一律12%の値引きを行っていた。値引きなしで同じ売上高を達成した場合に製品Xの営業利益率がどうなるか,前年度実績に基づいて試算した。試算結果を,表6に示す。ここで,値引きなしで売る場合においても,製品1個当たりの販売価格は販売数量にかかわらず同じとする。
注記 網掛けの部分は表示していない。
dに関する解答群
eに関する解答群
S社は,製品X,製品Y,製品Zを販売している。S社では,収益改善を目的にして,製品別の営業利益と営業利益率に関する分析を行っている。製品別の前年度実績を,表1に示す。
なお,本問における営業利益率などのパーセント(%)表記の値は,表においては,小数第1位を四捨五入して,整数で表示している。他の文中のパーセント(%)表記の値は,そのままの値を示している。
| 製品X | 製品Y | 製品Z | 全体 | |
| 売上高(百万円) | 2,200 | 1,000 | 800 | 4,000 |
| 営業費用(百万円) | 2,100 | 850 | 680 | 3,630 |
| 営業利益(百万円) | 100 | 150 | 120 | 370 |
| 営業利益率(%) | 5 | 15 | 15 | 9 |
設問1 営業利益率の改善に関する次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
製品Xは,S社の売上高の半分以上を占めているが,営業利益率は全製品の中で最も低くなっている。そこでS社は,製品Xの営業利益率を上げるための施策を検討することにした。
製品Xの営業利益率を,ほかの製品の前年度実績を上回る16%にするためには,営業費用が前年度と同額ならば,売上高を [ a ] 百万円増やす必要がある。売上高が前年度と同額ならば,営業費用を [ b ] 百万円減らす必要がある。
aに関する解答群
| ア | 242 |
|---|---|
| イ | 300 |
| ウ | 352 |
| エ | 400 |
bに関する解答群
| ア | 231 |
|---|---|
| イ | 252 |
| ウ | 336 |
| エ | 352 |
設問2 収益改善に関する次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。ここで,c1とc2に入れる答えは,cに関する解答群の中から組合せとして正しいものを選ぶものとする。
S社は,各製品の収益を分析するために,製品別の営業費用を調査し,営業費用を固定費と変動費に分けた。調査結果を,表2に示す。ここで,固定費は販売数量の増減にかかわらず発生する一定額の費用のことであり,変動費は販売数量に比例して変化する費用のことである。
| 製品X | 製品Y | 製品Z | |
| 固定費 | 1,000 | 350 | 280 |
| 変動費 | 1,100 | 500 | 280 |
次にS社は,各製品の安全余裕率の分析を行った。安全余裕率は,売上高と損益分岐点売上高との差から算出される指標であり,数値が大きいほど売上高が低下した場合に赤字になる可能性が低いといった余裕度を示す。安全余裕率を求める式は,次のとおりである。安全余裕率に関わる項目の値を表3に,S社が定めている安全余裕率の基準とその状態を表4に示す。
限界利益率 = (売上高 - 変動費)÷ 売上高
損益分岐点売上高 = 固定費 ÷ 限界利益率
安全余裕率 = (売上高 - 損益分岐点売上高)÷ 売上高
| 製品X | 製品Y | 製品Z | |
| 売上高(百万円) | 2,200 | 1,000 | 800 |
| 限界利益率(%) | 50 | 50 | 50 |
| 損益分岐点売上高(百万円) | 2,000 | 700 | 560 |
| 安全余裕率(%) | 9 | 30 | 30 |
| 安全余裕率(%) | 状態 |
| 10未満 | 危険 |
| 10以上20未満 | 普通 |
| 20以上40未満 | 優良 |
| 40以上 | 極めて優良 |
表3の安全余裕率を見ると,製品Xは危険な状態にある。S社は,固定費を削減することによって,前年度実績と同じ売上高で安全余裕率20%を達成できるように,製品Xの固定費の削減目標の値を [ c1 ] 百万円と設定した。S社は,この目標値を達成するために,製品Xだけを販売している営業所を統廃合して賃借料などの固定費を削減することとした。ここで,営業所の統廃合によって製品Xの売上高は変化しないものとし,統廃合時に一時的に発生する費用は考慮しない。
さらに,統廃合の結果として削減される製品Xの固定費の削減金額 [ c1 ] 百万円を製品Zの固定費である人件費に追加して,営業を強化することにした。これによって,製品Zの固定費は [ c1 ] 百万円増えるが,売上高は1,000百万円に増やせると見込んだ。ここで,製品1個当たりの販売価格は販売数量にかかわらず同じとする。安全余裕率に関わる項目の試算値を,表5に示す。
| 製品X | 製品Z | |
| 売上高(百万円) | 2,200 | 1,000 |
| 限界利益率(%) | ||
| 損益分岐点売上高(百万円) | ||
| 安全余裕率(%) | 20 | [ c2 ] |
cに関する解答群
| c1 | c2 | |
| ア | 120 | 20 |
| イ | 120 | 33 |
| ウ | 240 | 20 |
| エ | 240 | 33 |
設問3 営業利益率の試算に関する次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
S社では,製品Xの売上高を確保するために,販売時に本来の販売価格に対して一律12%の値引きを行っていた。値引きなしで同じ売上高を達成した場合に製品Xの営業利益率がどうなるか,前年度実績に基づいて試算した。試算結果を,表6に示す。ここで,値引きなしで売る場合においても,製品1個当たりの販売価格は販売数量にかかわらず同じとする。
| 値引きあり | 値引きなし | ||
| 売上高(百万円) | 2,200 | 2,200 | |
| 営業費用(百万円) | 変動費 | 1,100 | [ d ] |
| 固定費 | 1,000 | ||
| 営業利益(百万円) | 100 | ||
| 営業利益率(%) | 5 | [ e ] | |
dに関する解答群
| ア | 880 |
|---|---|
| イ | 968 |
| ウ | 1,100 |
| エ | 1,232 |
| オ | 1,250 |
eに関する解答群
| ア | 5 |
|---|---|
| イ | 10 |
| ウ | 11 |
| エ | 15 |
答え : 設問1 (a)イ (b)イ 設問2 (c)ア 設問3 (d)イ (e)ウ
分野 : ストラテジ系 › 企業と法務 › 企業活動 › 会計・財務
分野 : ストラテジ系 › 企業と法務 › 企業活動 › 会計・財務
問8
次のプログラムの説明及びプログラムを読んで,設問1~3に答えよ。
〔プログラムの説明〕
関数BitapMatchは,Bitap法を使って文字列検索を行うプログラムである。
Bitap法は,検索対象の文字列(以下,対象文字列という)と検索文字列の照合に,個別の文字ごとに定義されるビット列を用いるという特徴をもつ。
なお,本問では,例えば2進数の16ビット論理型の定数 0000000000010101 は,上位の0を省略して “10101” B と表記する。
(1) 関数 BitapMatch は,対象文字列を Text[] に,検索文字列を Pat[] に格納して呼び出す。配列の要素番号は1から始まり,Text[] のi番目の文字は Text[i] と表記する。Pat[] についても同様にi番目の文字は Pat[i] と表記する。対象文字列と検索文字列は,英大文字で構成され,いずれも最長16文字とする。
対象文字列 Text[] が “AACBBAACABABAB” ,検索文字列 Pat[] が “ACABAB” の場合の格納例を,図1に示す。
(2) 関数 BitapMatch は,関数 GenerateBitMask を呼び出す。
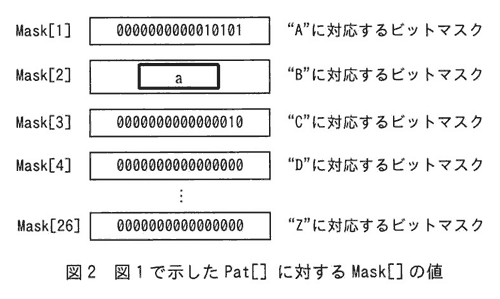
関数 GenerateBitMask は,文字 “A” ~ “Z” の文字ごとに,検索文字列に応じたビット列(以下,ビットマスクという)を生成し,要素数26の16ビット論理型配列 Mask[] に格納する。Mask[1] には文字 “A” に対するビットマスクを,Mask[2] には文字 “B” に対するビットマスクを格納する。このように Mask[1] ~ Mask[26] に文字 “A” ~ “Z” に対応するビットマスクを格納する。
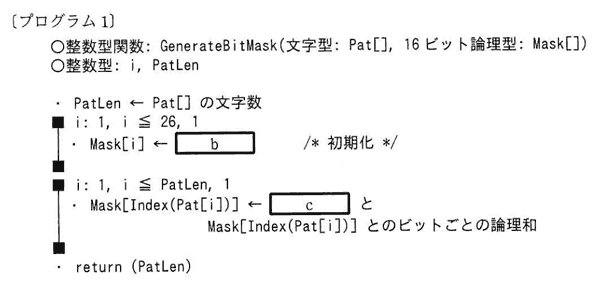
関数 GenerateBitMask は,Mask[] の全ての要素を “0” B に初期化した後,1以上で Pat[] の文字数以下の全てのiに対して,Pat[i] の文字に対応する Mask[] の要素である Mask[Index(Pat[i])] に格納されている値の,下位から数えてi番目のビットの値を1にする。
関数 Index は,引数にアルファベット順でn番目の英大文字を設定して呼び出すと,整数n(1≦n≦26)を返す。
(3) 図1で示した,Pat[] が “ACABAB” の例の場合,関数 GenerateBitMask を実行すると,Mask[] は図2のとおりになる。
(4) 関数 GenerateBitMask の引数と返却値の仕様は,表1のとおりである。
設問1 プログラムの説明及びプログラム1中の [ ] に入れる正しい答えを,解答群の中から選べ。
aに関する解答群
bに関する解答群
cに関する解答群
設問2 〔関数 BitapMatch の説明〕
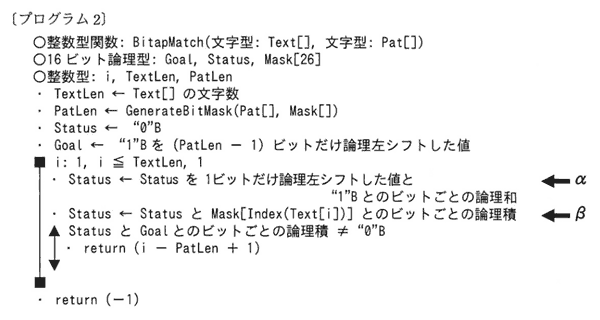
(1) Text[] と Pat[] を受け取り,Text[] の要素番号の小さい方から Pat[] と一致する文字列を検索し,見つかった場合は,一致した文字列の先頭の文字に対応する Text[] の要素の要素番号を返し,見つからなかった場合は,-1を返す。
(2) 図1の例では,Text[7] ~ Text[12] の文字列が Pat[] と一致するので,7を返す。
(3) 関数 BitapMatch の引数と返却値の仕様は,表2のとおりである。
次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
図1で示したとおりに,Text[] とPat [] に値を格納し,関数 BitapMatch を実行した。プログラム2の行βを実行した直後の変数iと配列要素 Mask[Index(Text[i])] と変数 Status の値の遷移は,表3のとおりである。
例えば,iが1のときに行βを実行した直後の Status の値は “1” B であることから,iが2のときに行αを実行した直後の Status の値は, “1” B を1ビットだけ論理左シフトした “10” B と “1” B とのビットごとの論理和を取った “11” B となる。次に,iが2のときに行βを実行した直後の Status の値は,Mask[Index(Text[2])] の値が “10101” B であることを考慮すると, [ d ] となる。
同様に,iが8のときに行βを実行した直後の Status の値が “10” B であるということに留意すると,iが9のときに行αを実行した直後の行βで参照する Mask[Index(Text[9])] の値は [ e ] であるので,行βを実行した直後の Status の値は [ f ] となる。
d,e,fに関する解答群
設問3 関数 GenerateBitMask の拡張に関する,次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。ここで,プログラム3中の [ b ] には,設問1の [ b ] の正しい答えが入っているものとする。
表4に示すような正規表現を検索文字列に指定できるように,関数 GenerateBitMask を拡張し,関数 GenerateBitMaskRegex を作成した。
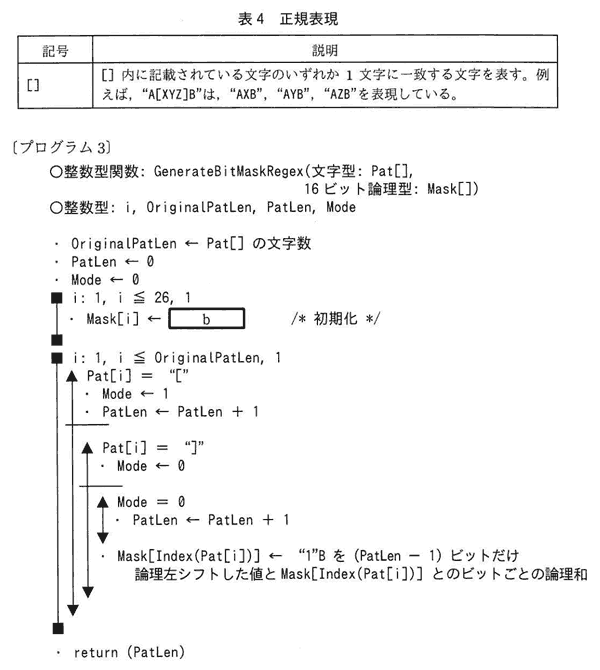
Pat[] に “AC[BA]A[ABC]A” を格納して,関数 GenerateBitMaskRegex を呼び出した場合を考える。この場合,文字 “A” に対応するビットマスクである Mask[1] は [ g ] となり,関数 GenerateBitMaskRegex の返却値は [ h ] となる。また,Pat[] に格納する文字列中において [] を入れ子にすることはできないが,誤って Pat[] に “AC[B[AB]AC]A” を格納して関数 GenerateBitMaskRegex を呼び出した場合,Mask[1] は [ i ] となる。
g,iに関する解答群
hに関する解答群
〔プログラムの説明〕
関数BitapMatchは,Bitap法を使って文字列検索を行うプログラムである。
Bitap法は,検索対象の文字列(以下,対象文字列という)と検索文字列の照合に,個別の文字ごとに定義されるビット列を用いるという特徴をもつ。
なお,本問では,例えば2進数の16ビット論理型の定数 0000000000010101 は,上位の0を省略して “10101” B と表記する。
(1) 関数 BitapMatch は,対象文字列を Text[] に,検索文字列を Pat[] に格納して呼び出す。配列の要素番号は1から始まり,Text[] のi番目の文字は Text[i] と表記する。Pat[] についても同様にi番目の文字は Pat[i] と表記する。対象文字列と検索文字列は,英大文字で構成され,いずれも最長16文字とする。
対象文字列 Text[] が “AACBBAACABABAB” ,検索文字列 Pat[] が “ACABAB” の場合の格納例を,図1に示す。
| 要素番号 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | 13 | 14 |
| Text[] | A | A | C | B | B | A | A | C | A | B | A | B | A | B |
| 要素番号 | 1 | 2 | 3 | 4 | 5 | 6 |
| Pat[] | A | C | A | B | A | B |
図1 対象文字列と検索文字列の格納例
(2) 関数 BitapMatch は,関数 GenerateBitMask を呼び出す。
関数 GenerateBitMask は,文字 “A” ~ “Z” の文字ごとに,検索文字列に応じたビット列(以下,ビットマスクという)を生成し,要素数26の16ビット論理型配列 Mask[] に格納する。Mask[1] には文字 “A” に対するビットマスクを,Mask[2] には文字 “B” に対するビットマスクを格納する。このように Mask[1] ~ Mask[26] に文字 “A” ~ “Z” に対応するビットマスクを格納する。
関数 GenerateBitMask は,Mask[] の全ての要素を “0” B に初期化した後,1以上で Pat[] の文字数以下の全てのiに対して,Pat[i] の文字に対応する Mask[] の要素である Mask[Index(Pat[i])] に格納されている値の,下位から数えてi番目のビットの値を1にする。
関数 Index は,引数にアルファベット順でn番目の英大文字を設定して呼び出すと,整数n(1≦n≦26)を返す。
(3) 図1で示した,Pat[] が “ACABAB” の例の場合,関数 GenerateBitMask を実行すると,Mask[] は図2のとおりになる。
(4) 関数 GenerateBitMask の引数と返却値の仕様は,表1のとおりである。
| 引数/返却値 | データ型 | 入力/出力 | 説明 |
| Pat[] | 文字型 | 入力 | 検索文字列が格納されている1次元配列 |
| Mask[] | 16ビット論理型 | 出力 | 文字 “A” ~ “Z” に対応するビットマスクが格納される1次元配列 |
| 返却値 | 整数型 | 出力 | 検索文字列の文字数 |
設問1 プログラムの説明及びプログラム1中の [ ] に入れる正しい答えを,解答群の中から選べ。
aに関する解答群
| ア | 0000000000000101 |
|---|---|
| イ | 0000000000101000 |
| ウ | 0001010000000000 |
| エ | 1010000000000000 |
bに関する解答群
| ア | “0” B |
|---|---|
| イ | “1” B |
| ウ | “1” BをPatLenビットだけ論理左シフトした値 |
| エ | “1” Bを(PatLen-1)ビットだけ論理左シフトした値 |
| オ | “1111111111111111” B |
cに関する解答群
| ア | “1” Bを(i-1)ビットだけ論理左シフトした値 |
|---|---|
| イ | “1” Bをiビットだけ論理左シフトした値 |
| ウ | “1” Bを(PatLen-1)ビットだけ論理左シフトした値 |
| エ | “1” BをPatLenビットだけ論理左シフトした値 |
| オ | “1” B |
設問2 〔関数 BitapMatch の説明〕
(1) Text[] と Pat[] を受け取り,Text[] の要素番号の小さい方から Pat[] と一致する文字列を検索し,見つかった場合は,一致した文字列の先頭の文字に対応する Text[] の要素の要素番号を返し,見つからなかった場合は,-1を返す。
(2) 図1の例では,Text[7] ~ Text[12] の文字列が Pat[] と一致するので,7を返す。
(3) 関数 BitapMatch の引数と返却値の仕様は,表2のとおりである。
| 引数/返却値 | データ型 | 入力/出力 | 説明 |
| Text[] | 文字型 | 入力 | 対象文字列が格納されている1次元配列 |
| Pat[] | 文字型 | 入力 | 検索文字列が格納されている1次元配列 |
| 返却値 | 整数型 | 出力 | 対象文字列中に検索文字列が見つかった場合は,一致した文字列の先頭の文字に対応する対象文字列の要素の要素番号を,検索文字列が見つからなかった場合は,-1を返す。 |
次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
図1で示したとおりに,Text[] とPat [] に値を格納し,関数 BitapMatch を実行した。プログラム2の行βを実行した直後の変数iと配列要素 Mask[Index(Text[i])] と変数 Status の値の遷移は,表3のとおりである。
例えば,iが1のときに行βを実行した直後の Status の値は “1” B であることから,iが2のときに行αを実行した直後の Status の値は, “1” B を1ビットだけ論理左シフトした “10” B と “1” B とのビットごとの論理和を取った “11” B となる。次に,iが2のときに行βを実行した直後の Status の値は,Mask[Index(Text[2])] の値が “10101” B であることを考慮すると, [ d ] となる。
同様に,iが8のときに行βを実行した直後の Status の値が “10” B であるということに留意すると,iが9のときに行αを実行した直後の行βで参照する Mask[Index(Text[9])] の値は [ e ] であるので,行βを実行した直後の Status の値は [ f ] となる。
| i | 1 | 2 | … | 8 | 9 | … |
| Mask[Index(Text[i])] | “10101” B | “10101” B | … | “10” B | [ e ] | … |
| Status | “1” B | [ d ] | … | “10” B | [ f ] | … |
d,e,fに関する解答群
| ア | “0” B |
|---|---|
| イ | “1” B |
| ウ | “10” B |
| エ | “11” B |
| オ | “100” B |
| カ | “101” B |
| キ | “10101” B |
設問3 関数 GenerateBitMask の拡張に関する,次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。ここで,プログラム3中の [ b ] には,設問1の [ b ] の正しい答えが入っているものとする。
表4に示すような正規表現を検索文字列に指定できるように,関数 GenerateBitMask を拡張し,関数 GenerateBitMaskRegex を作成した。
Pat[] に “AC[BA]A[ABC]A” を格納して,関数 GenerateBitMaskRegex を呼び出した場合を考える。この場合,文字 “A” に対応するビットマスクである Mask[1] は [ g ] となり,関数 GenerateBitMaskRegex の返却値は [ h ] となる。また,Pat[] に格納する文字列中において [] を入れ子にすることはできないが,誤って Pat[] に “AC[B[AB]AC]A” を格納して関数 GenerateBitMaskRegex を呼び出した場合,Mask[1] は [ i ] となる。
g,iに関する解答群
| ア | “1001101” B |
|---|---|
| イ | “1010100001” B |
| ウ | “1011001” B |
| エ | “101111” B |
| オ | “110011” B |
| カ | “111101” B |
hに関する解答群
| ア | 4 |
|---|---|
| イ | 6 |
| ウ | 9 |
| エ | 13 |
答え : 設問1 (a)イ (b)ア (c)ア 設問2 (d)イ (e)キ (f)カ 設問3 (g)カ (i)ウ (h)イ
分野 : テクノロジ系 › 基礎理論 › アルゴリズムとプログラミング › プログラミング
分野 : テクノロジ系 › 基礎理論 › アルゴリズムとプログラミング › プログラミング
 共有ボタンをタップ