基本情報技術者試験過去問 - 平成31年春期試験(科目B)
| 実施日 : | 2019年4月21日 | 受験者 : | 54,686人 |
| 問題数 : | 8問 | 合格者 : | 12,155人 |
| 合格率 : | 22.2% | ||
| 公式PDF : |
 問題
解答 |
問1
クラウドサービスの利用者認証に関する次の記述を読んで,設問1,2に答えよ。
A社では現在,Webベースの業務システムが複数稼働しており,それぞれが稼働するサーバ(以下,業務システムサーバという)を社内LANに設置している。A社のネットワーク構成を,図1に示す。
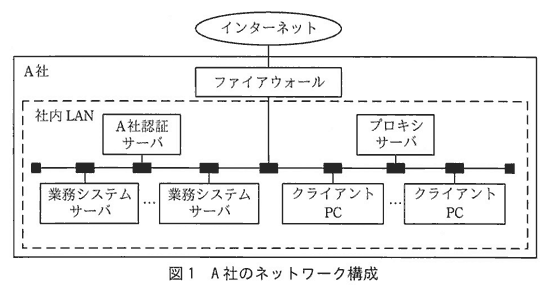
利用者は,業務システムを,社内LANに設置されたクライアントPCのWebブラウザから利用する。社外から社内LANへのリモートアクセスは禁止されている。業務システムの利用者認証は,A社認証サーバでの利用者IDとパスワード(以下,この二つを併せて利用者認証情報という)の検証によって行っており,シングルサインオンを実現している。
社内LANからインターネットを介した社外への通信は,クライアントPCからプロキシサーバを経由した,HTTP over TLS(以下,HTTPSという)による通信だけが,ファイアウォールによって許可されている。社外からインターネットを介した社内LANへの通信は,全てファイアウォールによって禁止されている。ファイアウォールの設定は,A社のセキュリティポリシに基づき変更しないものとする。
〔クラウドサービスの利用者認証〕
このたびA社は,業務システムの一つである販売管理システムを,B社がインターネットを介して提供する販売管理サービス(以下,B社クラウドサービスという)に移行することにした。利用者認証に関しては,A社認証サーバとB社クラウドサービスを連携し,次の(1)~(3)を実現することにした。
(1) B社クラウドサービスをシングルサインオンの対象とする。
(2) A社の利用者認証は,B社クラウドサービスについても,A社認証サーバで行う。
(3) 利用者が本人であることを確認するためにA社認証サーバで用いる [ a ] は,B社クラウドサービスには送信しない。
(1)~(3)を実現するために,A社は,利用者認証を仲介するIDプロバイダ(以下,IdPという)を社内LANに設置することにした。IdPは,認証結果,認証有効期限及び利用者ID(以下,これら三つを併せて認証済情報という)にディジタル署名を付加してから,Webブラウザを介して,B社クラウドサービスに送信する。B社クラウドサービスは,付加されているディジタル署名を使って,受信した認証済情報に [ b ] がないことを検証する。このために,IdPの [ c ] をB社クラウドサービスに登録しておく。
WebブラウザとB社クラウドサービスとの間,及びWebブラウザとIdPとの間の通信には,HTTPSを用いる。IdPとA社認証サーバとの間の通信にはLDAPを用いる。
〔B社クラウドサービスが利用可能になるまでの処理の手順〕
A社の利用者が,利用者認証されていない状態で,B社クラウドサービスを利用しようとした場合に,利用可能になるまでの処理の手順を次の①~⑩に示す。
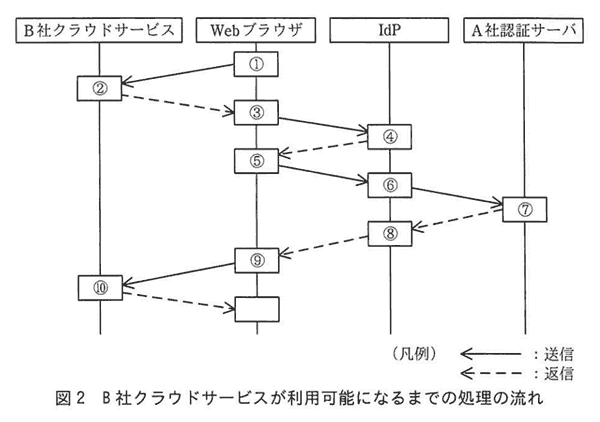
① 利用者は,WebブラウザからB社クラウドサービスにアクセスの要求を送信する。
② B社クラウドサービスは,アクセスの要求をIdPに転送する指示(以下,転送指示という)を,Webブラウザに返信する。
③ Webブラウザは,②の転送指示に従い,IdPにアクセスの要求を送信する。
④ IdPは,利用者認証情報の入力画面をWebブラウザに返信する。
⑤ 利用者は,Webブラウザで利用者認証情報を入力する。Webブラウザは,入力された利用者認証情報をIdPに送信する。
⑥ IdPは,利用者認証情報をA社認証サーバに送信する。
⑦ A社認証サーバは,利用者認証情報を検証し,認証結果をIdPに返信する。
⑧ IdPは,認証結果が成功の場合に,認証済情報を発行し,当該情報のB社クラウドサービスへの転送指示とともに,Webブラウザに返信する。
⑨ Webブラウザは,⑧の転送指示に従い,認証済情報をB社クラウドサービスに送信する。
⑩ B社クラウドサービスは,認証済情報に基づいて,B社クラウドサービスの利用を許可し,操作画面をWebブラウザに返信する。
B社クラウドサービスが利用可能になるまでの処理の流れを,図2に示す。図2中の①~⑩は,処理の手順の①~⑩と対応している。
設問1 本文中の [ ] に入れる適切な答えを,解答群の中から選べ。
a,b,cに関する解答群
設問2 次の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。
B社クラウドサービスでは,接続元のIPアドレスをA社のものに限定する機能は提供されていない。しかし,他の業務システムと同様に,B社クラウドサービスを,社内LANからの利用に限定できる。
この理由は,[ d ] ことが必要であるが,IdPを社内LANに設置するので,社外からB社クラウドサービスを利用しようとしても,図2中の [ e ] の送信で失敗し,利用者認証されないからである。
dに関する解答群
eに関する解答群
A社では現在,Webベースの業務システムが複数稼働しており,それぞれが稼働するサーバ(以下,業務システムサーバという)を社内LANに設置している。A社のネットワーク構成を,図1に示す。
利用者は,業務システムを,社内LANに設置されたクライアントPCのWebブラウザから利用する。社外から社内LANへのリモートアクセスは禁止されている。業務システムの利用者認証は,A社認証サーバでの利用者IDとパスワード(以下,この二つを併せて利用者認証情報という)の検証によって行っており,シングルサインオンを実現している。
社内LANからインターネットを介した社外への通信は,クライアントPCからプロキシサーバを経由した,HTTP over TLS(以下,HTTPSという)による通信だけが,ファイアウォールによって許可されている。社外からインターネットを介した社内LANへの通信は,全てファイアウォールによって禁止されている。ファイアウォールの設定は,A社のセキュリティポリシに基づき変更しないものとする。
〔クラウドサービスの利用者認証〕
このたびA社は,業務システムの一つである販売管理システムを,B社がインターネットを介して提供する販売管理サービス(以下,B社クラウドサービスという)に移行することにした。利用者認証に関しては,A社認証サーバとB社クラウドサービスを連携し,次の(1)~(3)を実現することにした。
(1) B社クラウドサービスをシングルサインオンの対象とする。
(2) A社の利用者認証は,B社クラウドサービスについても,A社認証サーバで行う。
(3) 利用者が本人であることを確認するためにA社認証サーバで用いる [ a ] は,B社クラウドサービスには送信しない。
(1)~(3)を実現するために,A社は,利用者認証を仲介するIDプロバイダ(以下,IdPという)を社内LANに設置することにした。IdPは,認証結果,認証有効期限及び利用者ID(以下,これら三つを併せて認証済情報という)にディジタル署名を付加してから,Webブラウザを介して,B社クラウドサービスに送信する。B社クラウドサービスは,付加されているディジタル署名を使って,受信した認証済情報に [ b ] がないことを検証する。このために,IdPの [ c ] をB社クラウドサービスに登録しておく。
WebブラウザとB社クラウドサービスとの間,及びWebブラウザとIdPとの間の通信には,HTTPSを用いる。IdPとA社認証サーバとの間の通信にはLDAPを用いる。
〔B社クラウドサービスが利用可能になるまでの処理の手順〕
A社の利用者が,利用者認証されていない状態で,B社クラウドサービスを利用しようとした場合に,利用可能になるまでの処理の手順を次の①~⑩に示す。
① 利用者は,WebブラウザからB社クラウドサービスにアクセスの要求を送信する。
② B社クラウドサービスは,アクセスの要求をIdPに転送する指示(以下,転送指示という)を,Webブラウザに返信する。
③ Webブラウザは,②の転送指示に従い,IdPにアクセスの要求を送信する。
④ IdPは,利用者認証情報の入力画面をWebブラウザに返信する。
⑤ 利用者は,Webブラウザで利用者認証情報を入力する。Webブラウザは,入力された利用者認証情報をIdPに送信する。
⑥ IdPは,利用者認証情報をA社認証サーバに送信する。
⑦ A社認証サーバは,利用者認証情報を検証し,認証結果をIdPに返信する。
⑧ IdPは,認証結果が成功の場合に,認証済情報を発行し,当該情報のB社クラウドサービスへの転送指示とともに,Webブラウザに返信する。
⑨ Webブラウザは,⑧の転送指示に従い,認証済情報をB社クラウドサービスに送信する。
⑩ B社クラウドサービスは,認証済情報に基づいて,B社クラウドサービスの利用を許可し,操作画面をWebブラウザに返信する。
B社クラウドサービスが利用可能になるまでの処理の流れを,図2に示す。図2中の①~⑩は,処理の手順の①~⑩と対応している。
設問1 本文中の [ ] に入れる適切な答えを,解答群の中から選べ。
a,b,cに関する解答群
| ア | PKI |
|---|---|
| イ | 改ざん |
| ウ | 公開鍵 |
| エ | サービス妨害 |
| オ | 生体情報 |
| カ | パスワード |
| キ | 秘密鍵 |
| ク | 利用者ID |
| ケ | 漏えい |
設問2 次の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。
B社クラウドサービスでは,接続元のIPアドレスをA社のものに限定する機能は提供されていない。しかし,他の業務システムと同様に,B社クラウドサービスを,社内LANからの利用に限定できる。
この理由は,[ d ] ことが必要であるが,IdPを社内LANに設置するので,社外からB社クラウドサービスを利用しようとしても,図2中の [ e ] の送信で失敗し,利用者認証されないからである。
dに関する解答群
| ア | B社クラウドサービスが,IdPと直接通信する |
|---|---|
| イ | B社クラウドサービスが,利用者認証情報を検証し,Webブラウザに返信する |
| ウ | IdPが,利用者に代わって,利用者認証情報をB社クラウドサービスに送信する |
| エ | Webブラウザが,IdPと通信する |
eに関する解答群
| ア | ① |
|---|---|
| イ | ③ |
| ウ | ⑤ |
| エ | ⑥ |
| オ | ⑨ |
答え : 設問1 (a)カ (b)イ (c)ウ 設問2 (d)エ (e)イ
分野 : テクノロジ系 › 技術要素 › セキュリティ › 情報セキュリティ管理
分野 : テクノロジ系 › 技術要素 › セキュリティ › 情報セキュリティ管理
問2
仮想記憶方式に関する次の記述を読んで,設問1~3に答えよ。
仮想記憶方式は,OSが提供する論理的な記憶領域(以下,仮想記憶という)上のアドレスと物理的な主記憶上のアドレスを対応付けて管理する方式である。仮想記憶方式では,補助記憶装置を仮想記憶の実装媒体として用いることによって,プログラムが主記憶の容量を超える大きさであっても,これを仮想記憶上のデータとして格納し,実行することができる。仮想記憶上のアドレス空間を仮想アドレス空間,主記憶上のアドレス空間を物理アドレス空間と呼び,それぞれの空間における記憶場所は仮想アドレス,物理アドレスで指定する。
仮想記憶方式の実現方法の一つにページング方式がある。この方式では,仮想アドレス空間と物理アドレス空間をそれぞれ仮想ページ,物理ページと呼ぶ固定長の領域に分割し,管理する。ページング方式では,プログラムの実行過程で,実行に必要な仮想ページのデータが物理アドレス空間に存在していないときは,そのデータが格納されている仮想ページからデータを物理ページに読み込んで利用する。
ページング方式のページ管理方法の例を次の(1)~(3)に示す。
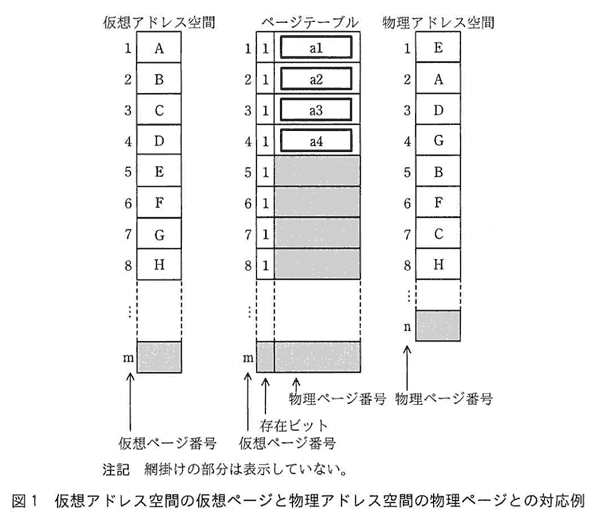
(1) 仮想アドレス空間及び物理アドレス空間の各ページには,1から順に番号を付け,それぞれを仮想ページ番号,物理ページ番号と呼ぶ。
(2) 仮想ページと物理ページの対応は,ページテーブルで管理する。ページテーブルの各要素は仮想ページと1対1に対応付けられており,要素の個数は仮想ページの個数と同じである。
(3) ページテーブルには,仮想ページのデータが物理アドレス空間に存在しているかどうかを示すビット(以下,存在ビットという)と,存在している場合に対応する物理ページ番号を登録する領域がある。存在ビットは,当該仮想ページのデータが物理アドレス空間に存在している場合は1,存在していない場合は0である。
仮想アドレス空間の仮想ページと物理アドレス空間の物理ページとの対応例を,図1に示す。ここで,図1中のA~Hは,仮想ページ及び物理ページに格納されているデータを示す。
設問1 図1中の [ ] に入れる正しい答えを,解答群の中から選べ。ここで,a1~a4に入れる答えは,aに関する解答群の中から組合せとして正しいものを選ぶものとする。
aに関する解答群
設問2 次の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。ここで,b1とb2,c1とc2に入れる答えは,それぞれb,cに関する解答群の中から組合せとして適切なものを選ぶものとする。
ページング方式では,プログラムの実行過程で,実行に必要なデータが物理アドレス空間に存在していないときには,ページフォールトという割込みが発生する。ページフォールトが発生すると,仮想ページに格納されているデータを物理ページに読み込む処理(以下,ページフォールト割込み処理という)を行う。
〔ページフォールト割込み処理〕
(1) 物理ページのうち,仮想ページと対応付けられていない物理ページ(以下,空きページという)を一つ探す。
(2) 空きページがなかった場合,空きページにする [ b1 ] ページを一つ選び,その選んだページに格納されているデータを [ b2 ]。その後,対応するページテーブルの要素の存在ビットを0にする。これによって空きページを確保する。
(3) 空きページがあった場合,又はなかった場合では(2)の処理後に,その空きページにプログラムの実行に必要な [ c1 ] ページに格納されているデータを [ c2 ]。その後,対応するページテーブルの要素に物理ページ番号を登録して,その存在ビットを1にする。
bに関する解答群
cに関する解答群
設問3 次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
ページング方式において,ページフォールトの発生回数を少なくするためには,どの物理ページを空きページにするかが重要になる。一般的に知られているアルゴリズムであるFIFOとLRUについて,あるプログラムの実行過程で仮想ページが次の順で参照される場合を考える。ここで,プログラムの実行開始時点では,このプログラムの実行のために割り当てられた物理ページは全て空きページである。
〔仮想ページの参照順〕
4→2→1→5→4→2→3→4→2→1→5→3→5
FIFOを用いると,割り当てられた物理ページの個数が3のときは,ページフォールトの発生回数は9回である。物理ページの個数が4ならば,物理ページの個数が3のときと比べて,ページフォールトの発生回数は [ d ]。
一方,LRUを用いると,物理ページの個数が3のときは,ページフォールトの発生回数は10回である。物理ページの個数が4ならば,物理ページの個数が3のときと比べて,ページフォールトの発生回数は [ e ]。
d,eに関する解答群
仮想記憶方式は,OSが提供する論理的な記憶領域(以下,仮想記憶という)上のアドレスと物理的な主記憶上のアドレスを対応付けて管理する方式である。仮想記憶方式では,補助記憶装置を仮想記憶の実装媒体として用いることによって,プログラムが主記憶の容量を超える大きさであっても,これを仮想記憶上のデータとして格納し,実行することができる。仮想記憶上のアドレス空間を仮想アドレス空間,主記憶上のアドレス空間を物理アドレス空間と呼び,それぞれの空間における記憶場所は仮想アドレス,物理アドレスで指定する。
仮想記憶方式の実現方法の一つにページング方式がある。この方式では,仮想アドレス空間と物理アドレス空間をそれぞれ仮想ページ,物理ページと呼ぶ固定長の領域に分割し,管理する。ページング方式では,プログラムの実行過程で,実行に必要な仮想ページのデータが物理アドレス空間に存在していないときは,そのデータが格納されている仮想ページからデータを物理ページに読み込んで利用する。
ページング方式のページ管理方法の例を次の(1)~(3)に示す。
(1) 仮想アドレス空間及び物理アドレス空間の各ページには,1から順に番号を付け,それぞれを仮想ページ番号,物理ページ番号と呼ぶ。
(2) 仮想ページと物理ページの対応は,ページテーブルで管理する。ページテーブルの各要素は仮想ページと1対1に対応付けられており,要素の個数は仮想ページの個数と同じである。
(3) ページテーブルには,仮想ページのデータが物理アドレス空間に存在しているかどうかを示すビット(以下,存在ビットという)と,存在している場合に対応する物理ページ番号を登録する領域がある。存在ビットは,当該仮想ページのデータが物理アドレス空間に存在している場合は1,存在していない場合は0である。
仮想アドレス空間の仮想ページと物理アドレス空間の物理ページとの対応例を,図1に示す。ここで,図1中のA~Hは,仮想ページ及び物理ページに格納されているデータを示す。
設問1 図1中の [ ] に入れる正しい答えを,解答群の中から選べ。ここで,a1~a4に入れる答えは,aに関する解答群の中から組合せとして正しいものを選ぶものとする。
aに関する解答群
| a1 | a2 | a3 | a4 | |
| ア | 1 | 2 | 3 | 4 |
| イ | 2 | 3 | 5 | 7 |
| ウ | 2 | 5 | 7 | 3 |
| エ | 5 | 1 | 4 | 7 |
| オ | 5 | 2 | 7 | 3 |
設問2 次の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。ここで,b1とb2,c1とc2に入れる答えは,それぞれb,cに関する解答群の中から組合せとして適切なものを選ぶものとする。
ページング方式では,プログラムの実行過程で,実行に必要なデータが物理アドレス空間に存在していないときには,ページフォールトという割込みが発生する。ページフォールトが発生すると,仮想ページに格納されているデータを物理ページに読み込む処理(以下,ページフォールト割込み処理という)を行う。
〔ページフォールト割込み処理〕
(1) 物理ページのうち,仮想ページと対応付けられていない物理ページ(以下,空きページという)を一つ探す。
(2) 空きページがなかった場合,空きページにする [ b1 ] ページを一つ選び,その選んだページに格納されているデータを [ b2 ]。その後,対応するページテーブルの要素の存在ビットを0にする。これによって空きページを確保する。
(3) 空きページがあった場合,又はなかった場合では(2)の処理後に,その空きページにプログラムの実行に必要な [ c1 ] ページに格納されているデータを [ c2 ]。その後,対応するページテーブルの要素に物理ページ番号を登録して,その存在ビットを1にする。
bに関する解答群
| b1 | b2 | |
| ア | 仮想 | 補助記憶装置から読み込む |
| イ | 仮想 | 補助記憶装置に書き出す |
| ウ | 物理 | 補助記憶装置から読み込む |
| エ | 物理 | 補助記憶装置に書き出す |
cに関する解答群
| c1 | c2 | |
| ア | 仮想 | 補助記憶装置から読み込む |
| イ | 仮想 | 補助記憶装置に書き出す |
| ウ | 物理 | 補助記憶装置から読み込む |
| エ | 物理 | 補助記憶装置に書き出す |
設問3 次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
ページング方式において,ページフォールトの発生回数を少なくするためには,どの物理ページを空きページにするかが重要になる。一般的に知られているアルゴリズムであるFIFOとLRUについて,あるプログラムの実行過程で仮想ページが次の順で参照される場合を考える。ここで,プログラムの実行開始時点では,このプログラムの実行のために割り当てられた物理ページは全て空きページである。
〔仮想ページの参照順〕
4→2→1→5→4→2→3→4→2→1→5→3→5
FIFOを用いると,割り当てられた物理ページの個数が3のときは,ページフォールトの発生回数は9回である。物理ページの個数が4ならば,物理ページの個数が3のときと比べて,ページフォールトの発生回数は [ d ]。
一方,LRUを用いると,物理ページの個数が3のときは,ページフォールトの発生回数は10回である。物理ページの個数が4ならば,物理ページの個数が3のときと比べて,ページフォールトの発生回数は [ e ]。
d,eに関する解答群
| ア | 1回増える |
|---|---|
| イ | 1回減る |
| ウ | 2回増える |
| エ | 2回減る |
| オ | 3回増える |
| カ | 3回減る |
| キ | 4回増える |
| ク | 4回減る |
| ケ | 変わらない |
答え : 設問1 (a)ウ 設問2 (b)エ (c)ア 設問3 (d)ア (e)エ
分野 : テクノロジ系 › コンピュータシステム › ソフトウェア › オペレーティングシステム
分野 : テクノロジ系 › コンピュータシステム › ソフトウェア › オペレーティングシステム
問3
定期健康診断のデータが登録されているデータベースに関する次の記述を読んで,設問1~3に答えよ。
D中学校では,年に1回,定期健康診断を実施し,結果をデータベースに登録している。
身長と体重の測定結果は,身長の単位はcm,体重の単位はkgとして,いずれも0.1刻みで健診結果表に登録している。定期健康診断を受ける生徒の生年月日,性別などの属性情報は,受診者情報表に登録している。
健診結果表を作成するSQL文の一部と,受診者情報表を作成するSQL文を次に示す。
ここで,DECIMAL(x, y)は固定小数点数を扱うデータ型であり,xは精度であって,表示する数字の桁数を示し,yは位取りであって,小数点以下の数字の桁数を示す。例えば,データベースに175.5を登録するには,xに4を,yに1を指定する。
健診結果表及び受診者情報表のデータ(以下,定期健康診断データという)から,身長と体重を統計データとして参照するために,測定結果ビューを使用する。測定結果ビューを作成するSQL文を次に示す。
CREATE VIEW 測定結果ビュー( 年度, 学年, 性別, 生年月日, 身長, 体重 ) AS
SELECT 健診結果表.年度, 健診結果表.学年,
CASE 受診者情報表.性別
WHEN 0 THEN '男'
WHEN 1 THEN '女'
ELSE '-'
END,
受診者情報表.生年月日, 健診結果表.身長, 健診結果表.体重
FROM 健診結果表, 受診者情報表
WHERE 健診結果表.受診者ID = 受診者情報表.受診者ID
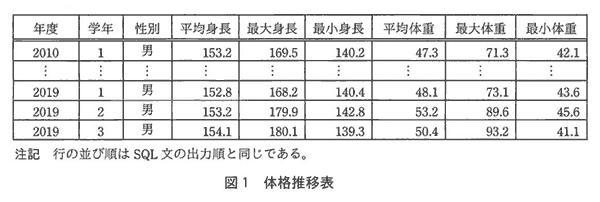
設問1 2010年度から2019年度までの定期健康診断データを基に,男子生徒の体格の推移を見る。次のSQL文の実行結果を用いて,図1に示す体格推移表を作成した。平均身長と平均体重は小数第2位を四捨五入した値である。SQL文の [ ] に入れる正しい答えを,解答群の中から選べ。ここで,c1とc2に入れる答えは,cに関する解答群の中から組合せとして正しいものを選ぶものとする。
SELECT 年度, 学年, 性別,
AVG(身長) AS 平均身長, MAX(身長) AS 最大身長, MIN(身長) AS 最小身長,
AVG(体重) AS 平均体重, MAX(体重) AS 最大体重, MIN(体重) AS 最小体重
FROM 測定結果ビュー WHERE 年度 [ a ] AND 性別 = [ b ]
GROUP BY 年度, 学年, 性別
ORDER BY 年度 [ c1 ], 学年 [ c2 ]
aに関する解答群
bに関する解答群
cに関する解答群
設問2 次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
D中学校では,転入生を受け入れる場合,転出元の中学校から受領した定期健康診断の結果の情報をデータベースに登録する。健診結果表には,受診者IDと年度に [ d ] 制約を設定し,受診者IDに受診者情報表の受診者IDへの [ e ] 制約を設定している。この制約に従うと,転入生の定期健康診断の結果の情報の健診結果表への登録は,受診者情報表に転入生の情報を登録した後に行う必要がある。
d,eに関する解答群
設問3 次の記述中の に入れる正しい答えを,解答群の中から選べ。
図2に示す身長階級表を作成し,これに対応させて,2019年度の男子生徒の定期健康診断データを基に,図3に示す身長度数分布表を作成したところ, “人数が相違している” との指摘があった。
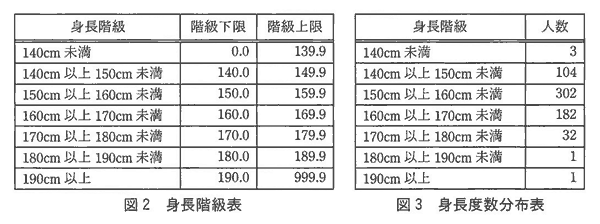
図3に示す身長度数分布表の作成は,次の(1)~(3)の手順で行った。
(1) 図2に示す身長階級表をデータベースに作成した。
(2) 新たなSQL文を作成した。
(3) (2)で作成したSQL文の実行結果を用いて,図3に示す身長度数分布表を作成した。
調査の結果,(2)で作成したSQL文に誤りがあることが分かった。(2)で作成したSQL文は,次のとおりである。このSQL文は,対象とした全生徒を必ずいずれかの身長区分に分類して集計するために,身長階級表からは全レコードを,測定結果ビューからはON句に指定した結合条件に一致するレコードを抽出している。
SELECT 身長階級, 階級下限, COUNT(*) AS 人数
FROM 測定結果ビュー RIGHT OUTER JOIN 身長階級表 ON
身長 BETWEEN 階級下限 AND 階級上限
AND 年度 = '2019'
AND 性別 = '男'
GROUP BY 身長階級, 階級下限, 階級上限
ORDER BY 階級下限 ASC
図1を見ると,2019年度は男子全学年での最大身長が180.1cmであり,190cm以上の生徒は存在しないが,図3の身長度数分布表では,190cm以上の人数が1となっている。この原因は,(2)で作成したSQL文では [ f ] とすべき箇所をCOUNT(*)としていることにある。その結果,測定結果ビューと身長階級表を結合した結果において,NULLとなっているレコードもカウントしているからである。
fに関する解答群
D中学校では,年に1回,定期健康診断を実施し,結果をデータベースに登録している。
身長と体重の測定結果は,身長の単位はcm,体重の単位はkgとして,いずれも0.1刻みで健診結果表に登録している。定期健康診断を受ける生徒の生年月日,性別などの属性情報は,受診者情報表に登録している。
健診結果表を作成するSQL文の一部と,受診者情報表を作成するSQL文を次に示す。
|
CREATE TABLE 健診結果表 ( 年度 CHAR(4), 受診者ID CHAR(10), 学年 INT, 身長 DECIMAL(4, 1), 体重 DECIMAL(4, 1), ⋮ 肺活量 INT, PRIMARY KEY(年度,受診者ID), FOREIGN KEY(受診者ID) REFERENCES 受診者情報表(受診者ID) ) |
CREATE TABLE 受診者情報表 ( 受診者ID CHAR(10), 氏名 VARCHAR(50), ふりがな VARCHAR(50), 生年月日 DATE, 性別 SMALLINT, 特記事項 VARCHAR(512), PRIMARY KEY(受診者ID) ) |
ここで,DECIMAL(x, y)は固定小数点数を扱うデータ型であり,xは精度であって,表示する数字の桁数を示し,yは位取りであって,小数点以下の数字の桁数を示す。例えば,データベースに175.5を登録するには,xに4を,yに1を指定する。
健診結果表及び受診者情報表のデータ(以下,定期健康診断データという)から,身長と体重を統計データとして参照するために,測定結果ビューを使用する。測定結果ビューを作成するSQL文を次に示す。
CREATE VIEW 測定結果ビュー( 年度, 学年, 性別, 生年月日, 身長, 体重 ) AS
SELECT 健診結果表.年度, 健診結果表.学年,
CASE 受診者情報表.性別
WHEN 0 THEN '男'
WHEN 1 THEN '女'
ELSE '-'
END,
受診者情報表.生年月日, 健診結果表.身長, 健診結果表.体重
FROM 健診結果表, 受診者情報表
WHERE 健診結果表.受診者ID = 受診者情報表.受診者ID
設問1 2010年度から2019年度までの定期健康診断データを基に,男子生徒の体格の推移を見る。次のSQL文の実行結果を用いて,図1に示す体格推移表を作成した。平均身長と平均体重は小数第2位を四捨五入した値である。SQL文の [ ] に入れる正しい答えを,解答群の中から選べ。ここで,c1とc2に入れる答えは,cに関する解答群の中から組合せとして正しいものを選ぶものとする。
SELECT 年度, 学年, 性別,
AVG(身長) AS 平均身長, MAX(身長) AS 最大身長, MIN(身長) AS 最小身長,
AVG(体重) AS 平均体重, MAX(体重) AS 最大体重, MIN(体重) AS 最小体重
FROM 測定結果ビュー WHERE 年度 [ a ] AND 性別 = [ b ]
GROUP BY 年度, 学年, 性別
ORDER BY 年度 [ c1 ], 学年 [ c2 ]
aに関する解答群
| ア | LIKE '201_' |
|---|---|
| イ | LIKE '2010' |
| ウ | LIKE '2019' |
| エ | = '201%' |
| オ | = '201_' |
| カ | = '201*' |
bに関する解答群
| ア | 0 |
|---|---|
| イ | 1 |
| ウ | '男' |
| エ | '女' |
| オ | '-' |
cに関する解答群
| c1 | c2 | |
| ア | ASC | ASC |
| イ | ASC | DESC |
| ウ | DESC | ASC |
| エ | DESC | DESC |
設問2 次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
D中学校では,転入生を受け入れる場合,転出元の中学校から受領した定期健康診断の結果の情報をデータベースに登録する。健診結果表には,受診者IDと年度に [ d ] 制約を設定し,受診者IDに受診者情報表の受診者IDへの [ e ] 制約を設定している。この制約に従うと,転入生の定期健康診断の結果の情報の健診結果表への登録は,受診者情報表に転入生の情報を登録した後に行う必要がある。
d,eに関する解答群
| ア | UNIQUE |
|---|---|
| イ | 検査 |
| ウ | 参照 |
| エ | 主キー |
| オ | 非NULL |
設問3 次の記述中の に入れる正しい答えを,解答群の中から選べ。
図2に示す身長階級表を作成し,これに対応させて,2019年度の男子生徒の定期健康診断データを基に,図3に示す身長度数分布表を作成したところ, “人数が相違している” との指摘があった。
図3に示す身長度数分布表の作成は,次の(1)~(3)の手順で行った。
(1) 図2に示す身長階級表をデータベースに作成した。
(2) 新たなSQL文を作成した。
(3) (2)で作成したSQL文の実行結果を用いて,図3に示す身長度数分布表を作成した。
調査の結果,(2)で作成したSQL文に誤りがあることが分かった。(2)で作成したSQL文は,次のとおりである。このSQL文は,対象とした全生徒を必ずいずれかの身長区分に分類して集計するために,身長階級表からは全レコードを,測定結果ビューからはON句に指定した結合条件に一致するレコードを抽出している。
SELECT 身長階級, 階級下限, COUNT(*) AS 人数
FROM 測定結果ビュー RIGHT OUTER JOIN 身長階級表 ON
身長 BETWEEN 階級下限 AND 階級上限
AND 年度 = '2019'
AND 性別 = '男'
GROUP BY 身長階級, 階級下限, 階級上限
ORDER BY 階級下限 ASC
図1を見ると,2019年度は男子全学年での最大身長が180.1cmであり,190cm以上の生徒は存在しないが,図3の身長度数分布表では,190cm以上の人数が1となっている。この原因は,(2)で作成したSQL文では [ f ] とすべき箇所をCOUNT(*)としていることにある。その結果,測定結果ビューと身長階級表を結合した結果において,NULLとなっているレコードもカウントしているからである。
fに関する解答群
| ア | COUNT(身長) |
|---|---|
| イ | COUNT(身長階級) |
| ウ | MAX(身長) |
| エ | MAX(身長階級) |
| オ | 身長 |
| カ | 身長階級 |
答え : 設問1 (a)ア (b)ウ (c)ア 設問2 (d)エ (e)ウ 設問3 (f)ア
分野 : テクノロジ系 › 技術要素 › データベース › データ操作
分野 : テクノロジ系 › 技術要素 › データベース › データ操作
問4
eラーニングシステムの構成変更に関する次の記述を読んで,設問1~3に答えよ。
G社は,全国に設置した様々な規模の教室から教育コンテンツにアクセスできるWebベースのeラーニングシステムを構築し,このシステムを使った教育事業を展開している。
eラーニングシステムは,1台のコンテンツサーバと1台のアプリケーションサーバで構成されている。コンテンツサーバは,教材や試験問題などの教育コンテンツを保持し,アプリケーションサーバを経由して,クライアントである教室のPCに教育コンテンツを送信する。
アプリケーションサーバは,受講者の認証を行い,ログインしている受講者を管理する。
受講者は,クライアントを利用して,教室ごとに設置されているプロキシサーバとインターネットを経由して,eラーニングシステムにアクセスして学習する。
最近,一部の受講者から,システム利用に関して,"応答に時間が掛かる"などの苦情が寄せられている。G社では,応答時間を短縮するために,アプリケーションサーバ1台の追加と負荷分散装置の導入を伴う新しいネットワーク構成を検討した。負荷分散装置は,クライアントからの要求を,同じ機能をもつ複数のサーバのうちのいずれかに振り分ける装置である。
〔検討したネットワーク構成〕
検討したネットワーク構成を,図1に示す。
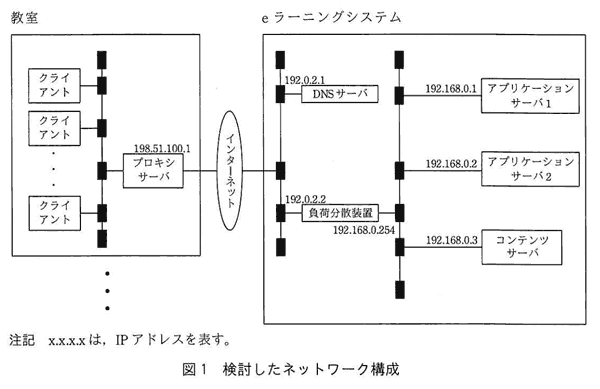
クライアントからプロキシサーバを経由して,eラーニングシステムにアクセスするために,DNSサーバ及び負荷分散装置には次の設定を行う。
・DNSサーバに,eラーニングシステムのドメイン名とこれに対応するIPアドレスとして [ a ] とを登録する。
・負荷分散装置に,振り分け先IPアドレスとして [ b ] とを登録する。
〔負荷分散装置を用いたアクセスの振り分け〕
アプリケーションサーバは,ログインしている受講者を管理し,その受講者がどの教育コンテンツを閲覧中かなどの状況を保持する。したがって,負荷分散装置を用いてアプリケーションサーバの負荷分散を行う場合には,受講者がeラーニングシステムにログインしてからログアウトするまでは,その受講者が利用する1台のクライアントからアプリケーションサーバへの要求を,常に同一のアプリケーションサーバへ振り分ける必要がある。負荷分散装置には,送信元のIPアドレスの情報を基に要求を振り分けるタイプ(以下,装置タイプAという)と,OSI基本参照モデルのレイヤ4以上の情報を基に要求を振り分けるタイプ(以下,装置タイプBという)とがある。二つのタイプそれぞれの装置の動作について,概要を次に示す。
(1) 装置タイプA
(a) 振り分け先が決まっていない送信元IPアドレスからの要求は,ラウンドロビン方式で決定したアプリケーションサーバに振り分けるとともに,送信元IPアドレスと振り分け先のアプリケーションサーバのIPアドレスとを記録する。
(b) 振り分け先が決まっている送信元IPアドレスからの要求は,そのアプリケーションサーバに振り分ける。
装置タイプAを用いると,①多くのクライアントのある大規模な教室からのアクセスが,1台のアプリケーションサーバに集中して,アプリケーションサーバの負荷に偏りが生じることが予想される。
(2) 装置タイプB
(a) クライアントから送信された要求中のHTTPヘッダ内に c (以下,識別情報という)がない場合は,ラウンドロビン方式で決定したアプリケーションサーバに振り分ける。
(b) アプリケーションサーバから送信された応答に含まれるHTTPヘッダ内の識別情報と,当該アプリケーションサーバのIPアドレスとを記録する。
(c) クライアントから送信された要求中のHTTPヘッダ内の識別情報に対応するアプリケーションサーバのIPアドレスが(b)の処理によって記録されている場合は,そのアプリケーションサーバに振り分ける。
装置タイプBを用いると,多くのクライアントのある大規模な教室からプロキシサーバを経由してアクセスがあっても,振り分け先の決定をクライアント単位で行える。
検討の結果,アプリケーションサーバの負荷に偏りが少なくなることから,装置タイプBを導入することにした。
設問1 本文中の [ ] に入れる適切な答えを,解答群の中から選べ。
aに関する解答群
bに関する解答群
cに関する解答群
設問2 本文中の下線部①で,装置タイプAを用いたときに,アプリケーションサーバの負荷に偏りが生じる要因となり得るものはどれか。適切な答えを,解答群の中から選べ。
解答群
設問3 次の記述中の に入れる正しい答えを,解答群の中から選べ。
eラーニングシステムの応答時間は,1件の要求に対するネットワーク上のデータ転送時間,アプリケーションサーバでの処理待ち時間,及びアプリケーションサーバの処理時間(処理を始めてから応答を返すまでの時間)の合計である。検討したネットワーク構成での応答時間の短縮効果を評価するために,アプリケーションサーバでの平均処理待ち時間を計算する。
アプリケーションサーバの要求1件の平均処理時間は0.40秒であり,要求の平均到着率は2.30件/秒である。処理の待ち行列はアプリケーションサーバだけで発生するものとして,現行のネットワーク構成における平均処理待ち時間を,次のM/M/1の待ち行列モデルの式で計算すると,4.60秒となる。
ρ:アプリケーションサーバの利用率=λ/μ
μ:アプリケーションサーバの処理率(=平均処理時間の逆数)
λ:アプリケーションサーバへの平均到着率
アプリケーションサーバを1台追加し,装置タイプBを導入したとき,1台のアプリケーションサーバでの平均処理待ち時間をM/M/1の待ち行列モデルによって計算すると,[ ] 秒となる。ここで,要求は2台のアプリケーションサーバに交互に振り分けられると仮定する。また,平均処理待ち時間は小数第3位を四捨五入し,ネットワーク上のデータ転送時間とアプリケーションサーバの処理時間は変わらないものとする。
解答群
G社は,全国に設置した様々な規模の教室から教育コンテンツにアクセスできるWebベースのeラーニングシステムを構築し,このシステムを使った教育事業を展開している。
eラーニングシステムは,1台のコンテンツサーバと1台のアプリケーションサーバで構成されている。コンテンツサーバは,教材や試験問題などの教育コンテンツを保持し,アプリケーションサーバを経由して,クライアントである教室のPCに教育コンテンツを送信する。
アプリケーションサーバは,受講者の認証を行い,ログインしている受講者を管理する。
受講者は,クライアントを利用して,教室ごとに設置されているプロキシサーバとインターネットを経由して,eラーニングシステムにアクセスして学習する。
最近,一部の受講者から,システム利用に関して,"応答に時間が掛かる"などの苦情が寄せられている。G社では,応答時間を短縮するために,アプリケーションサーバ1台の追加と負荷分散装置の導入を伴う新しいネットワーク構成を検討した。負荷分散装置は,クライアントからの要求を,同じ機能をもつ複数のサーバのうちのいずれかに振り分ける装置である。
〔検討したネットワーク構成〕
検討したネットワーク構成を,図1に示す。
クライアントからプロキシサーバを経由して,eラーニングシステムにアクセスするために,DNSサーバ及び負荷分散装置には次の設定を行う。
・DNSサーバに,eラーニングシステムのドメイン名とこれに対応するIPアドレスとして [ a ] とを登録する。
・負荷分散装置に,振り分け先IPアドレスとして [ b ] とを登録する。
〔負荷分散装置を用いたアクセスの振り分け〕
アプリケーションサーバは,ログインしている受講者を管理し,その受講者がどの教育コンテンツを閲覧中かなどの状況を保持する。したがって,負荷分散装置を用いてアプリケーションサーバの負荷分散を行う場合には,受講者がeラーニングシステムにログインしてからログアウトするまでは,その受講者が利用する1台のクライアントからアプリケーションサーバへの要求を,常に同一のアプリケーションサーバへ振り分ける必要がある。負荷分散装置には,送信元のIPアドレスの情報を基に要求を振り分けるタイプ(以下,装置タイプAという)と,OSI基本参照モデルのレイヤ4以上の情報を基に要求を振り分けるタイプ(以下,装置タイプBという)とがある。二つのタイプそれぞれの装置の動作について,概要を次に示す。
(1) 装置タイプA
(a) 振り分け先が決まっていない送信元IPアドレスからの要求は,ラウンドロビン方式で決定したアプリケーションサーバに振り分けるとともに,送信元IPアドレスと振り分け先のアプリケーションサーバのIPアドレスとを記録する。
(b) 振り分け先が決まっている送信元IPアドレスからの要求は,そのアプリケーションサーバに振り分ける。
装置タイプAを用いると,①多くのクライアントのある大規模な教室からのアクセスが,1台のアプリケーションサーバに集中して,アプリケーションサーバの負荷に偏りが生じることが予想される。
(2) 装置タイプB
(a) クライアントから送信された要求中のHTTPヘッダ内に c (以下,識別情報という)がない場合は,ラウンドロビン方式で決定したアプリケーションサーバに振り分ける。
(b) アプリケーションサーバから送信された応答に含まれるHTTPヘッダ内の識別情報と,当該アプリケーションサーバのIPアドレスとを記録する。
(c) クライアントから送信された要求中のHTTPヘッダ内の識別情報に対応するアプリケーションサーバのIPアドレスが(b)の処理によって記録されている場合は,そのアプリケーションサーバに振り分ける。
装置タイプBを用いると,多くのクライアントのある大規模な教室からプロキシサーバを経由してアクセスがあっても,振り分け先の決定をクライアント単位で行える。
検討の結果,アプリケーションサーバの負荷に偏りが少なくなることから,装置タイプBを導入することにした。
設問1 本文中の [ ] に入れる適切な答えを,解答群の中から選べ。
aに関する解答群
| ア | 192.0.2.1 |
|---|---|
| イ | 192.0.2.2 |
| ウ | 192.168.0.1 |
| エ | 192.168.0.2 |
| オ | 192.168.0.3 |
| カ | 198.51.100.1 |
bに関する解答群
| ア | 192.168.0.1と192.168.0.2 |
|---|---|
| イ | 192.168.0.1と192.168.0.3 |
| ウ | 192.168.0.2と192.168.0.3 |
| エ | 192.168.0.2と192.168.0.254 |
cに関する解答群
| ア | DNSサーバのIPアドレス |
|---|---|
| イ | アプリケーションサーバとコンテンツサーバのポート番号 |
| ウ | セッションIDを示すcookie |
| エ | 負荷分散装置のIPアドレス |
設問2 本文中の下線部①で,装置タイプAを用いたときに,アプリケーションサーバの負荷に偏りが生じる要因となり得るものはどれか。適切な答えを,解答群の中から選べ。
解答群
| ア | 同じ教室のどのクライアントからの要求も送信元IPアドレスが全て同じになること。 |
|---|---|
| イ | クライアントから送られてきたIPパケット内の送信先アドレスが変換されること。 |
| ウ | 負荷分散装置が送信元IPアドレスの情報を用いるだけの単純な機能なので,高速に動作すること。 |
| エ | プロキシサーバを経由しても,HTTPヘッダの情報が変更されないこと。 |
設問3 次の記述中の に入れる正しい答えを,解答群の中から選べ。
eラーニングシステムの応答時間は,1件の要求に対するネットワーク上のデータ転送時間,アプリケーションサーバでの処理待ち時間,及びアプリケーションサーバの処理時間(処理を始めてから応答を返すまでの時間)の合計である。検討したネットワーク構成での応答時間の短縮効果を評価するために,アプリケーションサーバでの平均処理待ち時間を計算する。
アプリケーションサーバの要求1件の平均処理時間は0.40秒であり,要求の平均到着率は2.30件/秒である。処理の待ち行列はアプリケーションサーバだけで発生するものとして,現行のネットワーク構成における平均処理待ち時間を,次のM/M/1の待ち行列モデルの式で計算すると,4.60秒となる。
ρ:アプリケーションサーバの利用率=λ/μ
μ:アプリケーションサーバの処理率(=平均処理時間の逆数)
λ:アプリケーションサーバへの平均到着率
アプリケーションサーバを1台追加し,装置タイプBを導入したとき,1台のアプリケーションサーバでの平均処理待ち時間をM/M/1の待ち行列モデルによって計算すると,[ ] 秒となる。ここで,要求は2台のアプリケーションサーバに交互に振り分けられると仮定する。また,平均処理待ち時間は小数第3位を四捨五入し,ネットワーク上のデータ転送時間とアプリケーションサーバの処理時間は変わらないものとする。
解答群
| ア | 0.03 |
|---|---|
| イ | 0.34 |
| ウ | 1.34 |
| エ | 3.41 |
答え : 設問1 (a)イ (b)ア (c)ウ 設問2 ア 設問3 イ
分野 : テクノロジ系 › 技術要素 › ネットワーク › ネットワーク方式
分野 : テクノロジ系 › 技術要素 › ネットワーク › ネットワーク方式
問5
農産物の検査管理システムに関する次の記述を読んで,設問1~3に答えよ。
K社は,農産物を検査し,結果を報告する検査業務を実施している。検査の申込者の情報,検査を依頼された農産物(以下,検査農産物という)の情報,及び検査項目ごとの検査結果の情報は,検査管理システムで管理する。
〔検査農産物の検査業務の流れ〕
検査農産物の検査業務の流れは,次のとおりである。
(1) 担当者は,申込者から検査農産物と検査項目を受け付ける。一つの検査農産物に対して五つまでの検査項目を受け付ける。
(2) 担当者は,申込者が新規の場合,申込者の情報を検査管理システムに登録する。
(3) 担当者は,検査農産物の情報を検査管理システムに登録する。ただし,検査項目は登録しない。
(4) 担当者は,受け付けた検査項目の検査を実施する。受け付けた全ての検査項目の検査が終了した後,検査結果の情報を,検査項目ごとに検査管理システムに一括して登録する。
(5) 担当者は,検査管理システムに登録された検査結果を確認して,申込者に検査結果を報告する。
〔検査管理システムの説明〕
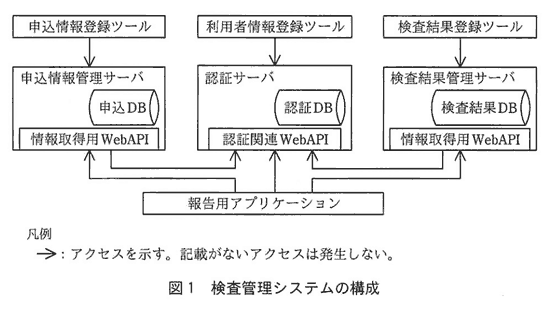
検査管理システムの構成を,図1に示す。検査管理システムは3台のサーバから成り,各サーバは個別にデータベース(以下,DBという)をもつ。各DBへの情報の登録には,各サーバの申込情報登録ツール,利用者情報登録ツール及び検査結果登録ツールを利用する。
申込者に報告する検査結果を確認するために,担当者は報告用アプリケーションを利用する。報告用アプリケーションは,各サーバが提供しているWebインタフェースのAPI(以下,WebAPIという)である情報取得用WebAPIと認証関連WebAPIだけを利用して,各DBにアクセスする。
担当者は,報告用アプリケーションに自身の利用者IDとパスワードを入力して,検査管理システムにログインする。報告用アプリケーションは,ログイン処理に認証関連WebAPIを利用し,ログインに成功したら認証サーバからアクセス用のID(以下,アクセスIDという)を取得する。アクセスIDは,認証情報として認証DBに格納され,ログアウトするまで管理される。報告用アプリケーションは,アクセスIDを情報取得用WebAPIの引数に指定して,各DBから必要な情報を取得する。
〔検査管理システムが管理する情報〕
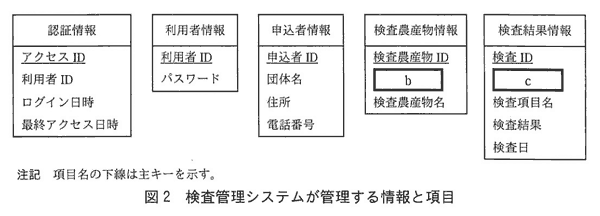
検査管理システムが管理する情報と項目を,図2に示す。各情報は,個別のID(利用者ID,検査IDなど)を付与される。各情報は,いずれかのDBだけに格納されている。各サーバがもつDBは,そのサーバが提供している情報取得用WebAPI(表1参照)又は認証関連WebAPIと,登録ツールだけからアクセスできる。よって,申込DBに格納されている情報は,図2に示す情報のうち,[ a ] である。
〔情報取得用WebAPIの説明〕
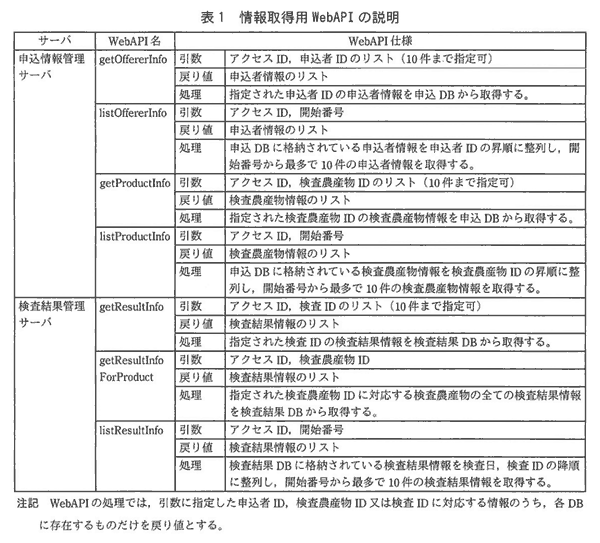
申込情報管理サーバと検査結果管理サーバが提供している情報取得用WebAPIの説明を,表1に示す。
情報取得用WebAPIは,指定された引数に基づいて処理を実行し,取得した情報を戻り値とする。
引数の指定方法には,情報取得用WebAPIによって,個別のIDを指定する方法,IDのリストを指定する方法,開始番号を指定する方法の3通りがある。情報取得用WebAPIの引数が開始番号の場合,格納されている情報を整列し,整列後の並びの先頭の情報を1件目とし,開始番号の位置から最多で10件を取得して戻り値とする。例えば,検査結果情報が25件ある場合,開始番号が1のときは整列後の並びの1~10件目を,開始番号が11のときは11~20件目を,開始番号が21のときは21~25件目を戻り値とする。
情報取得用WebAPIは,処理開始時に,認証関連WebAPIを利用して,引数に指定されたアクセスIDが認証情報として管理されているかどうかを確認する。管理されていない場合は,処理を受け付けない。ここで,表1中のWebAPI仕様の処理の説明では,アクセスIDの確認処理の説明は省略している。
設問1 本文中及び図2中の [ ] に入れる正しい答えを,解答群の中から選べ。
aに関する解答群
b,cに関する解答群
設問2 次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
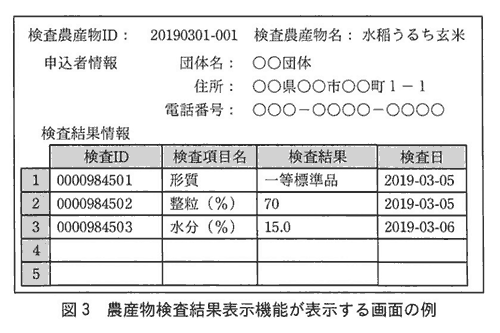
報告用アプリケーションには農産物検査結果表示機能があり,この機能は,1件の検査農産物IDを入力して"表示"ボタンをクリックすると,画面に情報を表示する。農産物検査結果表示機能が表示する画面の例を,図3に示す。検査結果の情報が登録済みの検査農産物の検査農産物IDを入力した場合, “表示” ボタンをクリックしてから画面の表示が完了するまでには,表1に示す情報取得用WebAPIの実行が最低 [ d ] 回必要である。ここで,実行時にエラーは発生しないものとする。
dに関する解答群
設問3 次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
担当者から,検査農産物IDの検査結果を個別に閲覧するのではなく,一覧形式で閲覧したいという要望が挙がった。要望を受けて,報告用アプリケーションに検査結果リスト表示機能を追加する。
検査結果リスト表示機能では,表1に示す情報取得用WebAPIを利用して,登録されている検査結果の情報(以下,農産物検査結果情報という)を全て一覧形式で表示する。1行の表示内容は,各農産物検査結果情報の一覧全体での位置を示す番号と,農産物検査結果情報の内訳として,団体名,検査農産物ID,検査ID,検査項目名,検査結果及び検査日である。一覧にするとき,最近実施した検査の検査結果が先に表示されるように,検査日の降順に整列する。検査結果リスト表示機能が表示する画面の例を,図4に示す。ここで,実行時にエラーは発生しないものとする。
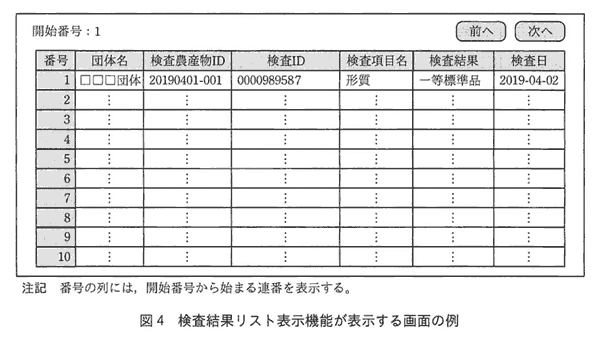
検査結果リスト表示機能は,1画面に最多で10件の農産物検査結果情報を表示する。画面に表示されていない農産物検査結果情報を表示するときは,ボタン “前へ” 又は “次へ” をクリックして表示の対象を切り替える。
この機能では,初期表示時の開始番号を1として画面を表示する。ボタン “前へ” 又は “次へ” をクリックすると,開始番号に-10又は10を加算して,画面を再表示する。画面表示のたびに,開始番号及び情報取得用WebAPIを利用して表示する情報を取得する場合,情報取得用WebAPIを [ e ] という順番で1回ずつ実行する。
eに関する解答群
K社は,農産物を検査し,結果を報告する検査業務を実施している。検査の申込者の情報,検査を依頼された農産物(以下,検査農産物という)の情報,及び検査項目ごとの検査結果の情報は,検査管理システムで管理する。
〔検査農産物の検査業務の流れ〕
検査農産物の検査業務の流れは,次のとおりである。
(1) 担当者は,申込者から検査農産物と検査項目を受け付ける。一つの検査農産物に対して五つまでの検査項目を受け付ける。
(2) 担当者は,申込者が新規の場合,申込者の情報を検査管理システムに登録する。
(3) 担当者は,検査農産物の情報を検査管理システムに登録する。ただし,検査項目は登録しない。
(4) 担当者は,受け付けた検査項目の検査を実施する。受け付けた全ての検査項目の検査が終了した後,検査結果の情報を,検査項目ごとに検査管理システムに一括して登録する。
(5) 担当者は,検査管理システムに登録された検査結果を確認して,申込者に検査結果を報告する。
〔検査管理システムの説明〕
検査管理システムの構成を,図1に示す。検査管理システムは3台のサーバから成り,各サーバは個別にデータベース(以下,DBという)をもつ。各DBへの情報の登録には,各サーバの申込情報登録ツール,利用者情報登録ツール及び検査結果登録ツールを利用する。
申込者に報告する検査結果を確認するために,担当者は報告用アプリケーションを利用する。報告用アプリケーションは,各サーバが提供しているWebインタフェースのAPI(以下,WebAPIという)である情報取得用WebAPIと認証関連WebAPIだけを利用して,各DBにアクセスする。
担当者は,報告用アプリケーションに自身の利用者IDとパスワードを入力して,検査管理システムにログインする。報告用アプリケーションは,ログイン処理に認証関連WebAPIを利用し,ログインに成功したら認証サーバからアクセス用のID(以下,アクセスIDという)を取得する。アクセスIDは,認証情報として認証DBに格納され,ログアウトするまで管理される。報告用アプリケーションは,アクセスIDを情報取得用WebAPIの引数に指定して,各DBから必要な情報を取得する。
〔検査管理システムが管理する情報〕
検査管理システムが管理する情報と項目を,図2に示す。各情報は,個別のID(利用者ID,検査IDなど)を付与される。各情報は,いずれかのDBだけに格納されている。各サーバがもつDBは,そのサーバが提供している情報取得用WebAPI(表1参照)又は認証関連WebAPIと,登録ツールだけからアクセスできる。よって,申込DBに格納されている情報は,図2に示す情報のうち,[ a ] である。
〔情報取得用WebAPIの説明〕
申込情報管理サーバと検査結果管理サーバが提供している情報取得用WebAPIの説明を,表1に示す。
情報取得用WebAPIは,指定された引数に基づいて処理を実行し,取得した情報を戻り値とする。
引数の指定方法には,情報取得用WebAPIによって,個別のIDを指定する方法,IDのリストを指定する方法,開始番号を指定する方法の3通りがある。情報取得用WebAPIの引数が開始番号の場合,格納されている情報を整列し,整列後の並びの先頭の情報を1件目とし,開始番号の位置から最多で10件を取得して戻り値とする。例えば,検査結果情報が25件ある場合,開始番号が1のときは整列後の並びの1~10件目を,開始番号が11のときは11~20件目を,開始番号が21のときは21~25件目を戻り値とする。
情報取得用WebAPIは,処理開始時に,認証関連WebAPIを利用して,引数に指定されたアクセスIDが認証情報として管理されているかどうかを確認する。管理されていない場合は,処理を受け付けない。ここで,表1中のWebAPI仕様の処理の説明では,アクセスIDの確認処理の説明は省略している。
設問1 本文中及び図2中の [ ] に入れる正しい答えを,解答群の中から選べ。
aに関する解答群
| ア | 認証情報及び申込者情報 |
|---|---|
| イ | 認証情報及び利用者情報 |
| ウ | 認証情報,申込者情報及び検査農産物情報 |
| エ | 検査農産物情報 |
| オ | 申込者情報 |
| カ | 申込者情報及び検査農産物情報 |
b,cに関する解答群
| ア | アクセスID |
|---|---|
| イ | 検査ID |
| ウ | 検査項目名 |
| エ | 検査農産物ID |
| オ | 申込者ID |
| カ | 利用者ID |
設問2 次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
報告用アプリケーションには農産物検査結果表示機能があり,この機能は,1件の検査農産物IDを入力して"表示"ボタンをクリックすると,画面に情報を表示する。農産物検査結果表示機能が表示する画面の例を,図3に示す。検査結果の情報が登録済みの検査農産物の検査農産物IDを入力した場合, “表示” ボタンをクリックしてから画面の表示が完了するまでには,表1に示す情報取得用WebAPIの実行が最低 [ d ] 回必要である。ここで,実行時にエラーは発生しないものとする。
dに関する解答群
| ア | 2 |
|---|---|
| イ | 3 |
| ウ | 4 |
| エ | 5 |
| オ | 6 |
| カ | 7 |
| キ | 8 |
設問3 次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
担当者から,検査農産物IDの検査結果を個別に閲覧するのではなく,一覧形式で閲覧したいという要望が挙がった。要望を受けて,報告用アプリケーションに検査結果リスト表示機能を追加する。
検査結果リスト表示機能では,表1に示す情報取得用WebAPIを利用して,登録されている検査結果の情報(以下,農産物検査結果情報という)を全て一覧形式で表示する。1行の表示内容は,各農産物検査結果情報の一覧全体での位置を示す番号と,農産物検査結果情報の内訳として,団体名,検査農産物ID,検査ID,検査項目名,検査結果及び検査日である。一覧にするとき,最近実施した検査の検査結果が先に表示されるように,検査日の降順に整列する。検査結果リスト表示機能が表示する画面の例を,図4に示す。ここで,実行時にエラーは発生しないものとする。
検査結果リスト表示機能は,1画面に最多で10件の農産物検査結果情報を表示する。画面に表示されていない農産物検査結果情報を表示するときは,ボタン “前へ” 又は “次へ” をクリックして表示の対象を切り替える。
この機能では,初期表示時の開始番号を1として画面を表示する。ボタン “前へ” 又は “次へ” をクリックすると,開始番号に-10又は10を加算して,画面を再表示する。画面表示のたびに,開始番号及び情報取得用WebAPIを利用して表示する情報を取得する場合,情報取得用WebAPIを [ e ] という順番で1回ずつ実行する。
eに関する解答群
| ア | listOffererInfo,listProductInfo,getResultInfoForProduct |
|---|---|
| イ | listProductInfo,getOffererInfo,getResultInfoForProduct |
| ウ | listProductInfo,listOffererInfo,getResultInfoForProduct |
| エ | listResultInfo,getOffererInfo,getProductInfo |
| オ | listResultInfo,getProductInfo,getOffererInfo |
答え : 設問1 (a)カ (b)オ (c)エ 設問2 (d)イ 設問3 (e)オ
分野 : テクノロジ系 › 開発技術 › システム開発技術 › 設計
分野 : テクノロジ系 › 開発技術 › システム開発技術 › 設計
問6
社内システムの仕様変更の扱いに関する次の記述を読んで,設問1,2に答えよ。
Q社では,ある社内システムを刷新する開発プロジェクト(以下,刷新プロジェクトという)を実施している。刷新プロジェクトは,設計,プログラム開発,結合試験及び総合試験の4工程で推進する。刷新プロジェクトは,利用部門,プロジェクト管理チーム,プロジェクトマネージャ(以下,担当PMという)及び複数の開発チームで構成されている。Q社では,過去の社内システムの構築において,開発中に発生した仕様変更に伴い,プロジェクト計画の大幅な見直しが必要になったことがあり,利用部門から仕様変更の依頼が発生した場合の取扱手順を定めている。
〔仕様変更の依頼が発生した場合の取扱手順〕
プロジェクト管理チーム,担当PM,開発チームの役割は,次のとおりである。
・プロジェクト管理チーム
仕様変更依頼票の受渡しなど利用部門との書類や情報のやり取り,担当PMや開発チームとの書類のやり取り,取りまとめを行う。また,変更管理会議の運営を行う。
・担当PM
仕様変更依頼票の確認,仕様変更の採否の判断,プロジェクト計画の更新を行う。
・開発チーム
仕様変更依頼票の内容に基づく影響調査を実施する。
(1) 利用部門は,仕様変更の目的及び内容と,変更によって得られる効果を記述した仕様変更依頼票を起票し,[ a1 ] に提出する。
(2) [ a1 ] は,仕様変更依頼票を受け付けて,受付番号を記入して,管理簿への記録を行う。
(3) [ a2 ] は,仕様変更依頼票の記述内容を確認し,内容が妥当であれば,受領し,変更内容に対する影響調査を該当する a3 に対して依頼するように [ a1 ] に指示する。ここで,プログラム開発以降の工程では,システム全体への影響を迅速に把握する必要があるので,Q社のルールでは,全ての [ a3 ] に対して影響調査を依頼する。受領しない場合,受領しない理由を仕様変更依頼票に付して利用部門に返却するよう [ a1 ] に指示する。
(4) 依頼された [ a3 ] は,仕様変更依頼票に記述してある仕様変更の内容に基づき,自チームで開発している機能に関する影響を調査する。追加,変更などが必要な設計書のページ数,対象プログラム及び影響を受ける開発規模を調査し,影響調査結果を回答する。
(5) [ a1 ] は,影響調査結果を取りまとめ,利用部門,[ a2 ] 及び影響のある [ a3 ] のメンバを出席者とする変更管理会議を開催する。
(6) 変更管理会議において,影響調査結果を参考にして,担当PMは,仕様変更の依頼の重要性及び緊急性,納期遅延の可能性,工数増加の有無,変更によるプログラム品質への影響などを総合的に評価して,変更を採用するかしないかを判断する。
(7) プロジェクト管理チームは,利用部門に仕様変更依頼の採否の結果を回答する。
(8) 変更管理会議において,仕様変更依頼が採用された場合,担当PMは [ b ] する。
設問1 〔仕様変更の依頼が発生した場合の取扱手順〕の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。ここで,a1~a3に入れる答えは,aに関する解答群の中から組合せとして適切なものを選ぶものとする。
aに関する解答群
bに関する解答群
設問2 次の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。
刷新プロジェクトのスケジュールを,図1に示す。ここで,1か月は4週とする。
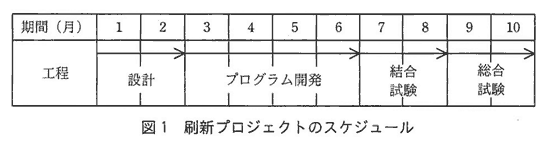
スケジュールのとおりに開発が進んでいたところ,刷新プロジェクトの開始後13週目において,機能Lに対する仕様変更依頼票が起票され,すぐに担当PMは受領した。刷新プロジェクトでは,機能Lを開発チーム1が,機能Mを開発チーム2が,機能Nを開発チーム3が担当している。現在の工程では,変更内容に対する影響調査の依頼先は,Q社のルールにのっとり,[ c ] となる。
〔影響調査結果の概要〕
影響調査の結果,開発チーム1が担当している機能L(当初計画の開発規模は,400kステップ)だけに影響があることが分かった。機能Lに関する生産性及び当初計画の工数を,表1に示す。
仕様変更を行っても,開発を進めている機能Lのプログラムを変更する必要はなく,機能Lの当初計画の開発規模の10%の追加開発が必要と分かった。また,仕様変更分における工程ごとの生産性は,当初計画と同じである。仕様変更に関わる,設計工程から結合試験工程までは,当初計画分と切り離して実施可能であり,この期間に必要な追加の工数は [ d ] 人月となる。
開発チーム1では,仕様変更分の総合試験の実施に関して,次の二つの計画を検討した。
・計画1
仕様変更分の総合試験は,当初計画分の総合試験の開始時点から実施する。
・計画2
仕様変更分の総合試験は,当初計画分の総合試験の5週目開始時点から実施する。
仕様変更に関わる,設計工程から結合試験工程までの期間は,刷新プロジェクトの開始後17週目開始から,計画1又は計画2の総合試験工程の開始前までとする。総合試験工程は,図1のスケジュールで示した当初計画どおりに完了させる。ここで,仕様変更分の開発に必要な追加の要員数は,設計工程から結合試験工程までの期間の各週で同一とする。また,追加の要員は,全ての工程を担当できるスキルを備えているものとする。
計画1の場合は刷新プロジェクトの開始後 [ e ] 週目終了までに,計画2の場合は刷新プロジェクトの開始後36週目終了までに,結合試験工程を完了させる必要がある。仕様変更に関わる,設計工程から結合試験工程までの期間の各週に必要な追加の要員は,計画1の場合は少なくとも [ f ] 人,計画2の場合は少なくとも [ g ] 人である。追加可能な要員が各週とも最多4人である場合,[ h ]。
前記の影響調査結果も踏まえて変更管理会議を開催し,仕様変更依頼を採用することになった。
cに関する解答群
dに関する解答群
eに関する解答群
f,gに関する解答群
hに関する解答群
Q社では,ある社内システムを刷新する開発プロジェクト(以下,刷新プロジェクトという)を実施している。刷新プロジェクトは,設計,プログラム開発,結合試験及び総合試験の4工程で推進する。刷新プロジェクトは,利用部門,プロジェクト管理チーム,プロジェクトマネージャ(以下,担当PMという)及び複数の開発チームで構成されている。Q社では,過去の社内システムの構築において,開発中に発生した仕様変更に伴い,プロジェクト計画の大幅な見直しが必要になったことがあり,利用部門から仕様変更の依頼が発生した場合の取扱手順を定めている。
〔仕様変更の依頼が発生した場合の取扱手順〕
プロジェクト管理チーム,担当PM,開発チームの役割は,次のとおりである。
・プロジェクト管理チーム
仕様変更依頼票の受渡しなど利用部門との書類や情報のやり取り,担当PMや開発チームとの書類のやり取り,取りまとめを行う。また,変更管理会議の運営を行う。
・担当PM
仕様変更依頼票の確認,仕様変更の採否の判断,プロジェクト計画の更新を行う。
・開発チーム
仕様変更依頼票の内容に基づく影響調査を実施する。
(1) 利用部門は,仕様変更の目的及び内容と,変更によって得られる効果を記述した仕様変更依頼票を起票し,[ a1 ] に提出する。
(2) [ a1 ] は,仕様変更依頼票を受け付けて,受付番号を記入して,管理簿への記録を行う。
(3) [ a2 ] は,仕様変更依頼票の記述内容を確認し,内容が妥当であれば,受領し,変更内容に対する影響調査を該当する a3 に対して依頼するように [ a1 ] に指示する。ここで,プログラム開発以降の工程では,システム全体への影響を迅速に把握する必要があるので,Q社のルールでは,全ての [ a3 ] に対して影響調査を依頼する。受領しない場合,受領しない理由を仕様変更依頼票に付して利用部門に返却するよう [ a1 ] に指示する。
(4) 依頼された [ a3 ] は,仕様変更依頼票に記述してある仕様変更の内容に基づき,自チームで開発している機能に関する影響を調査する。追加,変更などが必要な設計書のページ数,対象プログラム及び影響を受ける開発規模を調査し,影響調査結果を回答する。
(5) [ a1 ] は,影響調査結果を取りまとめ,利用部門,[ a2 ] 及び影響のある [ a3 ] のメンバを出席者とする変更管理会議を開催する。
(6) 変更管理会議において,影響調査結果を参考にして,担当PMは,仕様変更の依頼の重要性及び緊急性,納期遅延の可能性,工数増加の有無,変更によるプログラム品質への影響などを総合的に評価して,変更を採用するかしないかを判断する。
(7) プロジェクト管理チームは,利用部門に仕様変更依頼の採否の結果を回答する。
(8) 変更管理会議において,仕様変更依頼が採用された場合,担当PMは [ b ] する。
設問1 〔仕様変更の依頼が発生した場合の取扱手順〕の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。ここで,a1~a3に入れる答えは,aに関する解答群の中から組合せとして適切なものを選ぶものとする。
aに関する解答群
| a1 | a2 | a3 | |
| ア | 開発チーム | 担当PM | プロジェクト管理チーム |
| イ | 担当PM | 開発チーム | プロジェクト管理チーム |
| ウ | 担当PM | プロジェクト管理チーム | |
| エ | プロジェクト管理チーム | 担当PM | 開発チーム |
bに関する解答群
| ア | 仕様変更依頼の内容に対する影響調査を指示 |
|---|---|
| イ | 仕様変更依頼の内容をプロジェクト計画に反映させて更新 |
| ウ | 仕様変更依頼票の起票に至る経緯をプロジェクト管理チームに確認 |
| エ | 仕様変更依頼票の起票に至る経緯を利用部門に確認 |
設問2 次の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。
刷新プロジェクトのスケジュールを,図1に示す。ここで,1か月は4週とする。
スケジュールのとおりに開発が進んでいたところ,刷新プロジェクトの開始後13週目において,機能Lに対する仕様変更依頼票が起票され,すぐに担当PMは受領した。刷新プロジェクトでは,機能Lを開発チーム1が,機能Mを開発チーム2が,機能Nを開発チーム3が担当している。現在の工程では,変更内容に対する影響調査の依頼先は,Q社のルールにのっとり,[ c ] となる。
〔影響調査結果の概要〕
影響調査の結果,開発チーム1が担当している機能L(当初計画の開発規模は,400kステップ)だけに影響があることが分かった。機能Lに関する生産性及び当初計画の工数を,表1に示す。
| 工程 | 生産性(kステップ/人月) | 工数(人月) |
| 設計 | 10 | 40 |
| プログラム開発 | 4 | 100 |
| 結合試験 | 8 | 50 |
| 総合試験 | 10 | 40 |
仕様変更を行っても,開発を進めている機能Lのプログラムを変更する必要はなく,機能Lの当初計画の開発規模の10%の追加開発が必要と分かった。また,仕様変更分における工程ごとの生産性は,当初計画と同じである。仕様変更に関わる,設計工程から結合試験工程までは,当初計画分と切り離して実施可能であり,この期間に必要な追加の工数は [ d ] 人月となる。
開発チーム1では,仕様変更分の総合試験の実施に関して,次の二つの計画を検討した。
・計画1
仕様変更分の総合試験は,当初計画分の総合試験の開始時点から実施する。
・計画2
仕様変更分の総合試験は,当初計画分の総合試験の5週目開始時点から実施する。
仕様変更に関わる,設計工程から結合試験工程までの期間は,刷新プロジェクトの開始後17週目開始から,計画1又は計画2の総合試験工程の開始前までとする。総合試験工程は,図1のスケジュールで示した当初計画どおりに完了させる。ここで,仕様変更分の開発に必要な追加の要員数は,設計工程から結合試験工程までの期間の各週で同一とする。また,追加の要員は,全ての工程を担当できるスキルを備えているものとする。
計画1の場合は刷新プロジェクトの開始後 [ e ] 週目終了までに,計画2の場合は刷新プロジェクトの開始後36週目終了までに,結合試験工程を完了させる必要がある。仕様変更に関わる,設計工程から結合試験工程までの期間の各週に必要な追加の要員は,計画1の場合は少なくとも [ f ] 人,計画2の場合は少なくとも [ g ] 人である。追加可能な要員が各週とも最多4人である場合,[ h ]。
前記の影響調査結果も踏まえて変更管理会議を開催し,仕様変更依頼を採用することになった。
cに関する解答群
| ア | 開発チーム1 |
|---|---|
| イ | 開発チーム2 |
| ウ | 開発チーム3 |
| エ | 開発チーム1及び開発チーム2 |
| オ | 開発チーム1及び開発チーム3 |
| カ | 開発チーム2及び開発チーム3 |
| キ | 全ての開発チーム |
dに関する解答群
| ア | 19 |
|---|---|
| イ | 23 |
| ウ | 190 |
| エ | 230 |
eに関する解答群
| ア | 17 |
|---|---|
| イ | 31 |
| ウ | 32 |
| エ | 36 |
f,gに関する解答群
| ア | 1 |
|---|---|
| イ | 2 |
| ウ | 3 |
| エ | 4 |
| オ | 5 |
| カ | 6 |
| キ | 7 |
| ク | 8 |
hに関する解答群
| ア | 計画1だけが実現可能である |
|---|---|
| イ | 計画2だけが実現可能である |
| ウ | 両計画とも実現可能である |
| エ | 両計画とも実現不可能である |
答え : 設問1 (a)エ (b)イ 設問2 (c)キ (d)ア (e)ウ (f)オ (g)エ (h)イ
分野 : マネジメント系 › プロジェクトマネジメント › プロジェクトマネジメント › プロジェクトマネジメント
分野 : マネジメント系 › プロジェクトマネジメント › プロジェクトマネジメント › プロジェクトマネジメント
問7
製造業における情報システムの統合に関する次の記述を読んで,設問1~3に答えよ。
T社は,大手家電製品メーカであり,製品の設計及び需要予測は事業部ごとに行っている。各製造工場は,一つ以上の事業部の製品を製造している。
2018年度に各製造工場が製造した製品の事業部別取扱高を,表1に示す。
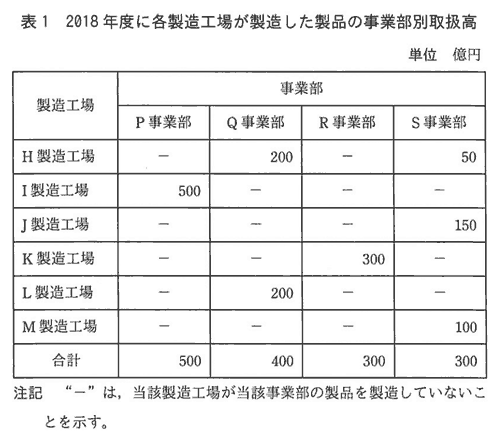
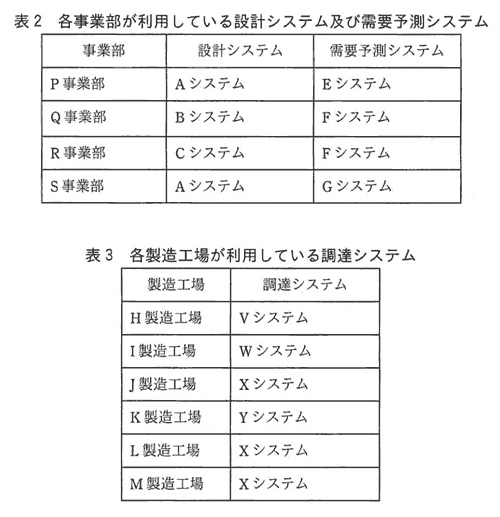
T社は,事業部と製造工場ごとに情報システムを整備してきた経緯があり,設計システムには三つ,需要予測システムには三つ,調達システムには四つのシステムがある。各事業部が利用している設計システム及び需要予測システムを表2に,各製造工場が利用している調達システムを表3に示す。システムの名称が同一の場合は,事業部又は製造工場が同じシステムを共用していることを意味している。例えば,P事業部とS事業部は,設計システムとしてAシステムを共用している。
T社では情報システムの運用保守コストの削減が求められており,本社の情報システム部門の主導によってプロジェクトを立ち上げ,設計システム,需要予測システム及び調達システムのそれぞれについて,複数のシステムを統合することとした。
設問 データの受渡し(以下,データ連携という)に関する次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。c,dは解答の記号が五十音順に並ぶように選べ。(一部改題)
調達システムは,製品の製造に必要な部品の在庫管理と発注処理を行っている。各製造工場が利用している調達システムは,その工場が製造する製品を担当している事業部が利用している設計システム及び需要予測システムとデータ連携している。設計システムと需要予測システムとの間のデータ連携はない。
表1~3によれば,最も多くの調達システムとデータ連携している設計システムは [ a ] システムであり,そのデータ連携先の調達システム数は [ b ] である。また,調達システムの中で,データ連携している設計システム数と需要予測システム数の合計が最も多いのは,[ c ] システムと [ d ] システムである。
aに関する解答群
bに関する解答群
c,dに関する解答群
T社は,大手家電製品メーカであり,製品の設計及び需要予測は事業部ごとに行っている。各製造工場は,一つ以上の事業部の製品を製造している。
2018年度に各製造工場が製造した製品の事業部別取扱高を,表1に示す。
T社は,事業部と製造工場ごとに情報システムを整備してきた経緯があり,設計システムには三つ,需要予測システムには三つ,調達システムには四つのシステムがある。各事業部が利用している設計システム及び需要予測システムを表2に,各製造工場が利用している調達システムを表3に示す。システムの名称が同一の場合は,事業部又は製造工場が同じシステムを共用していることを意味している。例えば,P事業部とS事業部は,設計システムとしてAシステムを共用している。
T社では情報システムの運用保守コストの削減が求められており,本社の情報システム部門の主導によってプロジェクトを立ち上げ,設計システム,需要予測システム及び調達システムのそれぞれについて,複数のシステムを統合することとした。
設問 データの受渡し(以下,データ連携という)に関する次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。c,dは解答の記号が五十音順に並ぶように選べ。(一部改題)
調達システムは,製品の製造に必要な部品の在庫管理と発注処理を行っている。各製造工場が利用している調達システムは,その工場が製造する製品を担当している事業部が利用している設計システム及び需要予測システムとデータ連携している。設計システムと需要予測システムとの間のデータ連携はない。
表1~3によれば,最も多くの調達システムとデータ連携している設計システムは [ a ] システムであり,そのデータ連携先の調達システム数は [ b ] である。また,調達システムの中で,データ連携している設計システム数と需要予測システム数の合計が最も多いのは,[ c ] システムと [ d ] システムである。
aに関する解答群
| ア | A |
|---|---|
| イ | B |
| ウ | C |
bに関する解答群
| ア | 2 |
|---|---|
| イ | 3 |
| ウ | 4 |
| エ | 5 |
| オ | 6 |
c,dに関する解答群
| ア | V |
|---|---|
| イ | W |
| ウ | X |
| エ | Y |
答え : 設問1 (a)ア (b)イ (c)ア (d)ウ
分野 : ストラテジ系 › システム戦略 › システム戦略 › 情報システム戦略
分野 : ストラテジ系 › システム戦略 › システム戦略 › 情報システム戦略
問8
ハフマン符号化を用いた文字列圧縮に関する次の記述を読んで,設問1~3に答えよ。
“A” ~ “D” の4種類の文字から成る文字列をハフマン符号化によって圧縮する。ハフマン符号化では,出現回数の多い文字には短いビット列を,出現回数の少ない文字には長いビット列を割り当てる。ハフマン符号化による文字列の圧縮手順は,次の(1)~(4)のとおりである。
(1) 文字列中の文字の出現回数を求め,出現回数表を作成する。例えば,文字列 “AAAABBCDCDDACCAAAAA” (以下,文字列αという)中の文字の出現回数表は,表1のとおりになる。
(2) 文字の出現回数表に基づいてハフマン木を作成する。
ハフマン木の定義は,次のとおりである。
・節と枝で構成する二分木である。
・親である節は,子である節を常に二つもち,子の節の値の和を値としてもつ。
・子をもたない節(以下,葉という)は文字に対応し,出現回数を値としてもつ。
・親をもたない節(以下,根という)は,文字列の文字数を値としてもつ。
文字列αに対応するハフマン木の例を,図1に示す。
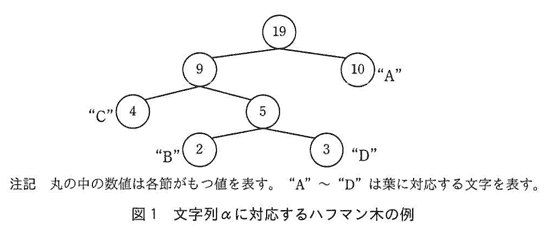
ハフマン木は,次の手順で配列によって実現する。
① 節の値を格納する1次元配列を用意する。
② 文字の出現回数表に基づいて,各文字に対応する葉の値を,配列の先頭の要素から順に格納する。
③ 親が作成されていない節を二つ選択し,選択した順に左側の子,右側の子とする親の節を一つ作成する。この節の値を,配列中で値が格納されている最後の要素の次の要素に格納する。節の選択は節の値の小さい順に行い,同じ値をもつ節が二つ以上ある場合は,配列の先頭に近い要素に値が格納されている節を選択する。
④ 親が作成されていない節が一つになるまで③を繰り返す。
(3) ハフマン木から文字のビット列(以下,ビット表現という)を次の手順で作成する。
① 親と左側の子をつなぐ枝に0,右側の子をつなぐ枝に1の値をもつビットを割り当てる。
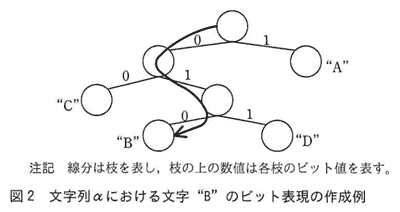
② 文字ごとに根から対応する葉までたどったとき,枝のビット値を順に左から並べたものを各文字のビット表現とする。
図2に示すとおり,根から矢印のようにたどると,文字列αの文字 “B” のビット表現は 010 となる。
(4) 文字列の全ての文字を(3)で得られたビット表現に置き換えて,ビット列を作成する。
設問1 次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
文字列 “ABBBBBBBBCCCDD” を,ハフマン符号化を用いて表現する。各文字とビット表現を示した表は [ a ] である。ハフマン符号化によって圧縮すると,文字 “A” ~ “D” をそれぞれ2ビットの固定長で表現したときの当該文字列の総ビット長に対する圧縮率は [ b ] となる。ここで,圧縮率は次式で計算した値の小数第3位を四捨五入して求める。
aに関する解答群
bに関する解答群
設問2 ハフマン木を作成するプログラム1の説明及びプログラム1を読んで,プログラム1中の [ ] に入れる正しい答えを,解答群の中から選べ。
〔プログラム1の説明〕
(1) 四つの1次元配列 parent,left,right 及び freq の同じ要素番号に対応する要素の組み(以下,要素組という)によって,一つの節を表す。要素番号は0から始まる。四つの配列の大きさはいずれも十分に大きく,全ての要素は -1 で初期化されている。
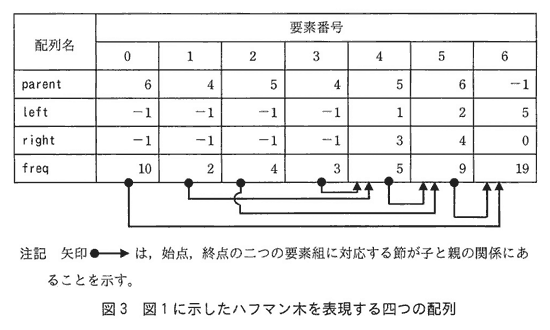
(2) 図3に,図1に示したハフマン木を表現した場合の各配列の要素がもつ値を示す。配列 parent には親,配列 left には左側の子,配列 right には右側の子を表す要素組の要素番号がそれぞれ格納され,配列 freq には節の値が格納される。節が葉のとき,配列 left と配列 right の要素の値は,いずれも -1 である。図3では,要素番号 0~3 の要素組が,順に文字 “A” ~ “D” の葉に対応している。節が根のとき,配列 parent の要素の値は -1 である。
(3) 副プログラム Huffman は,次の①~⑤を受け取り,ハフマン木を表現する配列を作成する。
① 葉である節の個数 size
② 初期化された配列 parent
③ 初期化された配列 left
④ 初期化された配列 right
⑤ 初期化された後,文字の出現回数が要素番号0から順に格納された配列 freq
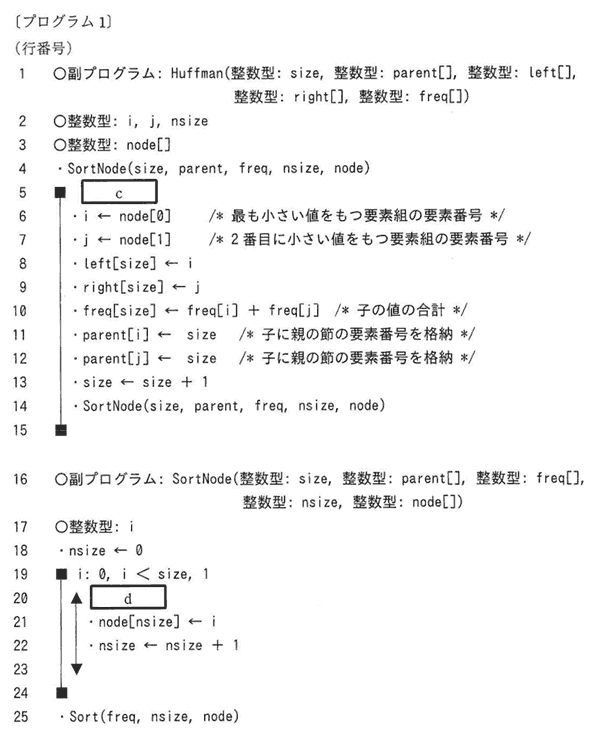
(4) 副プログラム SortNode は,親が作成されていない節を抽出し,節の値の昇順に整列し,節を表す要素組の要素番号を順に配列 node に格納し,その個数を変数 nsize に格納する。行番号 19~24 で親が作成されていない節を表す要素組の要素番号を抽出し,行番号25で節の値の昇順に整列する。
(5) 副プログラム Sort (プログラムは省略)は,節を表す要素組の要素番号の配列 node を受け取り,要素番号に対応する要素組が表す節の値が昇順となるように整列する。節の値が同じときの順序は並べ替える直前の順序に従う。
(6) 副プログラム Huffman,SortNode 及び Sort の引数の仕様を,表2~4に示す。
c,dに関する解答群
設問3 ハフマン木から文字のビット表現を作成して表示するプログラム2の説明及びプログラム2を読んで,プログラム2中の [ ] に入れる正しい答えを,解答群の中から選べ。
〔プログラム2の説明〕
(1) ビット表現を求めたい文字に対応する葉を表す要素組の要素番号を,副プログラム Encode の引数kに与えて呼び出すと,ハフマン木から文字のビット表現を作成して表示する。
(2) 副プログラム Encode の引数の仕様を,表5に示す。
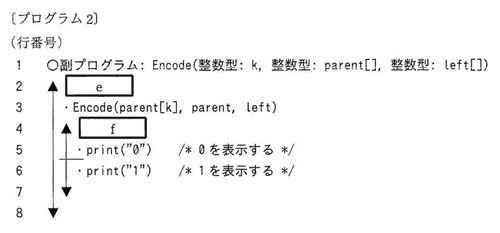
(3) 副プログラム Encode は,行番号2の条件が成り立つとき,副プログラム Encode を再帰的に呼び出す。これによって,ハフマン木を葉から根までたどっていく。
(4) 根にたどり着くと次は葉に向かってたどっていく。現在の節が親の左側の子のときは0を,右側の子のときは1を表示する。
(5) 関数 print は,引数で与えられた文字列を表示する。
eに関する解答群
fに関する解答群
“A” ~ “D” の4種類の文字から成る文字列をハフマン符号化によって圧縮する。ハフマン符号化では,出現回数の多い文字には短いビット列を,出現回数の少ない文字には長いビット列を割り当てる。ハフマン符号化による文字列の圧縮手順は,次の(1)~(4)のとおりである。
(1) 文字列中の文字の出現回数を求め,出現回数表を作成する。例えば,文字列 “AAAABBCDCDDACCAAAAA” (以下,文字列αという)中の文字の出現回数表は,表1のとおりになる。
| 文字 | A | B | C | D |
| 出現回数 | 10 | 2 | 4 | 3 |
(2) 文字の出現回数表に基づいてハフマン木を作成する。
ハフマン木の定義は,次のとおりである。
・節と枝で構成する二分木である。
・親である節は,子である節を常に二つもち,子の節の値の和を値としてもつ。
・子をもたない節(以下,葉という)は文字に対応し,出現回数を値としてもつ。
・親をもたない節(以下,根という)は,文字列の文字数を値としてもつ。
文字列αに対応するハフマン木の例を,図1に示す。
ハフマン木は,次の手順で配列によって実現する。
① 節の値を格納する1次元配列を用意する。
② 文字の出現回数表に基づいて,各文字に対応する葉の値を,配列の先頭の要素から順に格納する。
③ 親が作成されていない節を二つ選択し,選択した順に左側の子,右側の子とする親の節を一つ作成する。この節の値を,配列中で値が格納されている最後の要素の次の要素に格納する。節の選択は節の値の小さい順に行い,同じ値をもつ節が二つ以上ある場合は,配列の先頭に近い要素に値が格納されている節を選択する。
④ 親が作成されていない節が一つになるまで③を繰り返す。
(3) ハフマン木から文字のビット列(以下,ビット表現という)を次の手順で作成する。
① 親と左側の子をつなぐ枝に0,右側の子をつなぐ枝に1の値をもつビットを割り当てる。
② 文字ごとに根から対応する葉までたどったとき,枝のビット値を順に左から並べたものを各文字のビット表現とする。
図2に示すとおり,根から矢印のようにたどると,文字列αの文字 “B” のビット表現は 010 となる。
(4) 文字列の全ての文字を(3)で得られたビット表現に置き換えて,ビット列を作成する。
設問1 次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
文字列 “ABBBBBBBBCCCDD” を,ハフマン符号化を用いて表現する。各文字とビット表現を示した表は [ a ] である。ハフマン符号化によって圧縮すると,文字 “A” ~ “D” をそれぞれ2ビットの固定長で表現したときの当該文字列の総ビット長に対する圧縮率は [ b ] となる。ここで,圧縮率は次式で計算した値の小数第3位を四捨五入して求める。
aに関する解答群
| ア |
| ||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| イ |
| ||||||||||
| ウ |
| ||||||||||
| エ |
|
bに関する解答群
| ア | 0.77 |
|---|---|
| イ | 0.85 |
| ウ | 0.88 |
| エ | 0.92 |
設問2 ハフマン木を作成するプログラム1の説明及びプログラム1を読んで,プログラム1中の [ ] に入れる正しい答えを,解答群の中から選べ。
〔プログラム1の説明〕
(1) 四つの1次元配列 parent,left,right 及び freq の同じ要素番号に対応する要素の組み(以下,要素組という)によって,一つの節を表す。要素番号は0から始まる。四つの配列の大きさはいずれも十分に大きく,全ての要素は -1 で初期化されている。
(2) 図3に,図1に示したハフマン木を表現した場合の各配列の要素がもつ値を示す。配列 parent には親,配列 left には左側の子,配列 right には右側の子を表す要素組の要素番号がそれぞれ格納され,配列 freq には節の値が格納される。節が葉のとき,配列 left と配列 right の要素の値は,いずれも -1 である。図3では,要素番号 0~3 の要素組が,順に文字 “A” ~ “D” の葉に対応している。節が根のとき,配列 parent の要素の値は -1 である。
(3) 副プログラム Huffman は,次の①~⑤を受け取り,ハフマン木を表現する配列を作成する。
① 葉である節の個数 size
② 初期化された配列 parent
③ 初期化された配列 left
④ 初期化された配列 right
⑤ 初期化された後,文字の出現回数が要素番号0から順に格納された配列 freq
(4) 副プログラム SortNode は,親が作成されていない節を抽出し,節の値の昇順に整列し,節を表す要素組の要素番号を順に配列 node に格納し,その個数を変数 nsize に格納する。行番号 19~24 で親が作成されていない節を表す要素組の要素番号を抽出し,行番号25で節の値の昇順に整列する。
(5) 副プログラム Sort (プログラムは省略)は,節を表す要素組の要素番号の配列 node を受け取り,要素番号に対応する要素組が表す節の値が昇順となるように整列する。節の値が同じときの順序は並べ替える直前の順序に従う。
(6) 副プログラム Huffman,SortNode 及び Sort の引数の仕様を,表2~4に示す。
| 引数 | データ型 | 入出力 | 説明 |
| size | 整数型 | 入力/出力 | 節の個数 |
| parent[] | 整数型 | 入力/出力 | 節の親を表す要素組の要素番号を格納した配列 |
| left[] | 整数型 | 入力/出力 | 節の左側の子を表す要素組の要素番号を格納した配列 |
| right[] | 整数型 | 入力/出力 | 節の右側の子を表す要素組の要素番号を格納した配列 |
| freq[] | 整数型 | 入力/出力 | 節の値を格納した配列 |
| 引数 | データ型 | 入出力 | 説明 |
| size | 整数型 | 入力 | 節の個数 |
| parent[] | 整数型 | 入力 | 節の親を表す要素組の要素番号を格納した配列 |
| freq[] | 整数型 | 入力 | 節の値を格納した配列 |
| nsize | 整数型 | 出力 | 配列node中の,整列対象とした節の個数 |
| node[] | 整数型 | 出力 | 節の値の昇順に整列した,親が作成されていない節を表す要素組の要素番号を格納した配列 |
| 引数 | データ型 | 入出力 | 説明 |
| freq[] | 整数型 | 入力 | 節の値を格納した配列 |
| nsize | 整数型 | 入力 | 配列node中の,整列対象の節の個数 |
| node[] | 整数型 | 入力/出力 | 節を表す要素組の要素番号を格納した配列 |
c,dに関する解答群
| ア | nsize ≧ 0 |
|---|---|
| イ | nsize ≧ 1 |
| ウ | nsize ≧ 2 |
| エ | parent[i] < 0 |
| オ | parent[i] < 0 |
| カ | size ≦ nsize |
| キ | size ≧ nsize |
設問3 ハフマン木から文字のビット表現を作成して表示するプログラム2の説明及びプログラム2を読んで,プログラム2中の [ ] に入れる正しい答えを,解答群の中から選べ。
〔プログラム2の説明〕
(1) ビット表現を求めたい文字に対応する葉を表す要素組の要素番号を,副プログラム Encode の引数kに与えて呼び出すと,ハフマン木から文字のビット表現を作成して表示する。
(2) 副プログラム Encode の引数の仕様を,表5に示す。
| 引数 | データ型 | 入出力 | 説明 |
| k | 整数型 | 入力 | 節を表す要素組の要素番号 |
| parent[] | 整数型 | 入力 | 節の親を表す要素組の要素番号を格納した配列 |
| left[] | 整数型 | 入力 | 節の左側の子を表す要素組の要素番号を格納した配列 |
(3) 副プログラム Encode は,行番号2の条件が成り立つとき,副プログラム Encode を再帰的に呼び出す。これによって,ハフマン木を葉から根までたどっていく。
(4) 根にたどり着くと次は葉に向かってたどっていく。現在の節が親の左側の子のときは0を,右側の子のときは1を表示する。
(5) 関数 print は,引数で与えられた文字列を表示する。
eに関する解答群
| ア | k ≧ 0 |
|---|---|
| イ | left[k] = -1 |
| ウ | left[k] ≧ 0 |
| エ | parent[k] = -1 |
| オ | parent[k] ≧ 0 |
fに関する解答群
| ア | left[k] = k |
|---|---|
| イ | left[parent[k]] = k |
| ウ | parent[k] = k |
| エ | parent[left[k]] = k |
答え : 設問1 (a)ア (b)イ 設問2 (c)ウ (d)エ 設問3 (e)オ (f)イ
分野 : テクノロジ系 › 基礎理論 › アルゴリズムとプログラミング › アルゴリズム
分野 : テクノロジ系 › 基礎理論 › アルゴリズムとプログラミング › アルゴリズム
 共有ボタンをタップ