基本情報技術者試験過去問 - 平成30年春期試験(科目B)
| 実施日 : | 2018年4月15日 | 受験者 : | 51,377人 |
| 問題数 : | 8問 | 合格者 : | 14,829人 |
| 合格率 : | 28.8% | ||
| 公式PDF : |
 問題
解答 |
問1
Webサービスを利用するためのパスワードを安全に保存する方法に関する次の記述を読んで,設問1~3に答えよ。
A社が提供するWebサービスを利用するには,利用者が決めた利用者IDとパスワードを,Webアプリケーションが動作するサーバに登録しておく必要がある。A社のWebアプリケーションでは,利用者がWebアプリケーションにログインするときに,Webブラウザから利用者IDとパスワードがサーバに送信される。サーバは,受信した利用者IDとパスワードを,照合することによって認証する。利用者が決めたパスワードは,パスワードファイルに平文で保存されている。
近年,パスワードファイルが漏えいし,不正ログインが発生したと考えられる事件が多数報道されている。そこで,A社に勤めるCさんは,自社のWebアプリケーションにおけるパスワードファイルが漏えいした際の不正ログインを防止するための対策について,上司から検討を命じられた。
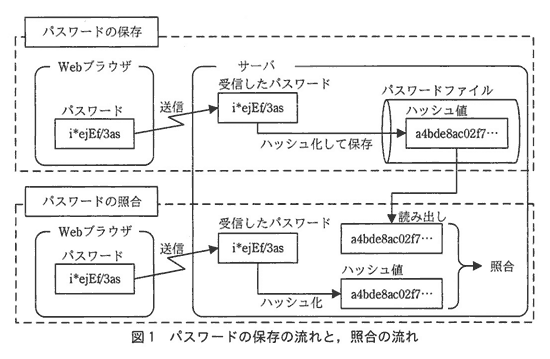
Cさんは対策として,パスワードを平文で保存するのではなく,ハッシュ関数でパスワードのハッシュ値を計算(以下,ハッシュ化という)し,そのハッシュ値を保存する方式を提案することにした。この方式におけるログイン時の認証では,受信したパスワードから求めたハッシュ値を,パスワードファイルに保存されているハッシュ値と照合する。パスワードの保存の流れと,照合の流れを図1に示す。
Cさんは,パスワードのハッシュ化には,ハッシュ関数の一つである [ a ] を用いることにした。ハッシュ化に用いるハッシュ関数は,一般的に次のような特徴を備えているので,パスワードが一致していることの確認に用いることができる。また,利用者のパスワードを平文で保存する場合と比べて,パスワードファイルが漏えいしても,より安全だと考えたからである。
〔ハッシュ化に用いるハッシュ関数の特徴〕
(1) パスワードの長さに関係なく,ハッシュ値は固定長になる。
(2) [ b ]
(3) ハッシュ値からパスワードを推測することが非常に困難である。
(4) パスワードが1文字でも異なれば,ハッシュ値は大きく異なる。
設問1 本文中の [ ] に入れる適切な答えを,解答群の中から選べ。
aに関する解答群
bに関する解答群
設問2 次の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。
Cさんは,自身が提案する方式について,社内の情報セキュリティ責任者にレビューを依頼したところ,この方式は漏えいしたパスワードファイルを攻撃者に入手された場合,事前計算による辞書攻撃に弱いという指摘を受けた。この攻撃では,あらかじめ攻撃者はパスワードとしてよく使われる文字列を,よく使われているハッシュ関数でハッシュ化し,ハッシュ値から元のパスワードが検索可能な一覧表を作成しておく。その後,攻撃者が漏えいしたパスワードファイルを入手したとき,この作成した一覧表からハッシュ値を検索する。ハッシュ値が一覧表に載っている場合は,元のパスワードを容易に知ることができる。
Cさんは,事前計算による辞書攻撃を難しくする方式を調査し,ソルトを用いる方式を提案することにした。ソルトとは,十分な長さをもつランダムな文字列である。
この方式におけるパスワードの保存では,まず,サーバは新しいパスワードの保存の都度,新しいソルトを生成し,ソルトとパスワードを連結した文字列をハッシュ化する。このとき得られるハッシュ値は,パスワードだけをハッシュ化した場合のハッシュ値 [ c ] 。次に,ハッシュ化に使用したソルトと得られたハッシュ値をパスワードファイルに保存する。
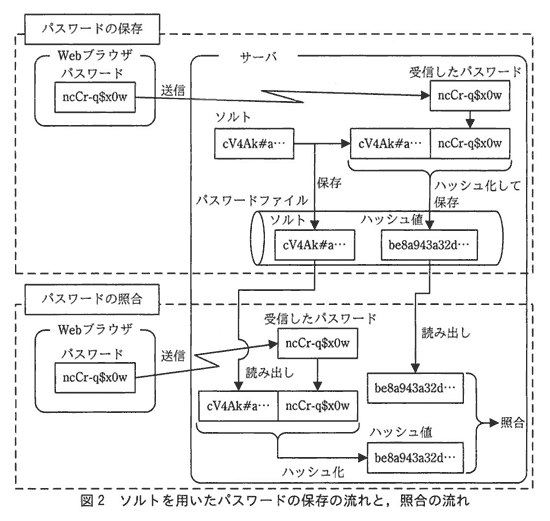
この方式におけるパスワードの照合では,まず,サーバはパスワードファイルからソルトとハッシュ値を読み出す。次に,読み出したソルトと受信したパスワードを連結した文字列をハッシュ化し,得られたハッシュ値を,読み出したハッシュ値と照合する。ソルトを用いたパスワードの保存の流れと,照合の流れを図2に示す。
ソルトを用いる方式が,事前計算による辞書攻撃の対策として効果があるのは,[ d ] からである。
cに関する解答群
dに関する解答群
設問3 次の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。
Cさんは,オフライン総当たり攻撃についても,対策を検討することにした。
漏えいしたパスワードファイルに対するオフライン総当たり攻撃とは,攻撃者が,パスワードファイルを入手した後,全てのパスワードの候補を逐次生成してはハッシュ化し,得られたハッシュ値がパスワードファイルに保存されているハッシュ値と一致するかどうか,しらみつぶしに確認することによって,ハッシュ値の元のパスワードを見つける攻撃方法である。
Cさんは,オフライン総当たり攻撃を難しくする方式として,ストレッチングという方式があることを知った。
この方式では,まず,ソルトとパスワードを連結した文字列をハッシュ化してハッシュ値を得る。次に,得られたハッシュ値の後にソルトとパスワードを連結し,その連結結果をハッシュ化する。この操作を指定した回数だけ繰り返すことによって,パスワードの照合に用いるハッシュ値を得る。パスワードファイルには,ソルト及びパスワードの照合に用いるハッシュ値に加えて,繰返し回数も保存する。この方式では,ハッシュ化の操作を1回だけ行う方式と比べると,攻撃者が,オフライン総当たり攻撃を行う際,[ ]。
解答群
A社が提供するWebサービスを利用するには,利用者が決めた利用者IDとパスワードを,Webアプリケーションが動作するサーバに登録しておく必要がある。A社のWebアプリケーションでは,利用者がWebアプリケーションにログインするときに,Webブラウザから利用者IDとパスワードがサーバに送信される。サーバは,受信した利用者IDとパスワードを,照合することによって認証する。利用者が決めたパスワードは,パスワードファイルに平文で保存されている。
近年,パスワードファイルが漏えいし,不正ログインが発生したと考えられる事件が多数報道されている。そこで,A社に勤めるCさんは,自社のWebアプリケーションにおけるパスワードファイルが漏えいした際の不正ログインを防止するための対策について,上司から検討を命じられた。
Cさんは対策として,パスワードを平文で保存するのではなく,ハッシュ関数でパスワードのハッシュ値を計算(以下,ハッシュ化という)し,そのハッシュ値を保存する方式を提案することにした。この方式におけるログイン時の認証では,受信したパスワードから求めたハッシュ値を,パスワードファイルに保存されているハッシュ値と照合する。パスワードの保存の流れと,照合の流れを図1に示す。
Cさんは,パスワードのハッシュ化には,ハッシュ関数の一つである [ a ] を用いることにした。ハッシュ化に用いるハッシュ関数は,一般的に次のような特徴を備えているので,パスワードが一致していることの確認に用いることができる。また,利用者のパスワードを平文で保存する場合と比べて,パスワードファイルが漏えいしても,より安全だと考えたからである。
〔ハッシュ化に用いるハッシュ関数の特徴〕
(1) パスワードの長さに関係なく,ハッシュ値は固定長になる。
(2) [ b ]
(3) ハッシュ値からパスワードを推測することが非常に困難である。
(4) パスワードが1文字でも異なれば,ハッシュ値は大きく異なる。
設問1 本文中の [ ] に入れる適切な答えを,解答群の中から選べ。
aに関する解答群
| ア | AES |
|---|---|
| イ | Diffie-Hellman |
| ウ | RSA |
| エ | SHA-256 |
| オ | TLS |
bに関する解答群
| ア | 異なるパスワードをハッシュ化したとき,同じハッシュ値になる可能性が高い。 |
|---|---|
| イ | 同一のパスワードをハッシュ化すると,同じハッシュ値になる。 |
| ウ | パスワードをハッシュ化した結果のハッシュ値を再度ハッシュ化すると,元のパスワードになる。 |
| エ | 秘密鍵を使用してハッシュ値から元のパスワードを復元できる。 |
設問2 次の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。
Cさんは,自身が提案する方式について,社内の情報セキュリティ責任者にレビューを依頼したところ,この方式は漏えいしたパスワードファイルを攻撃者に入手された場合,事前計算による辞書攻撃に弱いという指摘を受けた。この攻撃では,あらかじめ攻撃者はパスワードとしてよく使われる文字列を,よく使われているハッシュ関数でハッシュ化し,ハッシュ値から元のパスワードが検索可能な一覧表を作成しておく。その後,攻撃者が漏えいしたパスワードファイルを入手したとき,この作成した一覧表からハッシュ値を検索する。ハッシュ値が一覧表に載っている場合は,元のパスワードを容易に知ることができる。
Cさんは,事前計算による辞書攻撃を難しくする方式を調査し,ソルトを用いる方式を提案することにした。ソルトとは,十分な長さをもつランダムな文字列である。
この方式におけるパスワードの保存では,まず,サーバは新しいパスワードの保存の都度,新しいソルトを生成し,ソルトとパスワードを連結した文字列をハッシュ化する。このとき得られるハッシュ値は,パスワードだけをハッシュ化した場合のハッシュ値 [ c ] 。次に,ハッシュ化に使用したソルトと得られたハッシュ値をパスワードファイルに保存する。
この方式におけるパスワードの照合では,まず,サーバはパスワードファイルからソルトとハッシュ値を読み出す。次に,読み出したソルトと受信したパスワードを連結した文字列をハッシュ化し,得られたハッシュ値を,読み出したハッシュ値と照合する。ソルトを用いたパスワードの保存の流れと,照合の流れを図2に示す。
ソルトを用いる方式が,事前計算による辞書攻撃の対策として効果があるのは,[ d ] からである。
cに関する解答群
| ア | と同じ値になる |
|---|---|
| イ | とは異なる値になる |
| ウ | よりも長さが長い |
| エ | よりも長さが短い |
dに関する解答群
| ア | 攻撃者が,ハッシュ値からではなくソルトから元のパスワードを検索するための一覧表を事前に作成しておく必要がある |
|---|---|
| イ | 攻撃者がパスワードファイルからソルトを入手できない |
| ウ | 攻撃者がパスワードファイルを入手するのが困難になる |
| エ | 攻撃者が一つのパスワードに対して事前に求めるハッシュ値の数が膨大になる |
設問3 次の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。
Cさんは,オフライン総当たり攻撃についても,対策を検討することにした。
漏えいしたパスワードファイルに対するオフライン総当たり攻撃とは,攻撃者が,パスワードファイルを入手した後,全てのパスワードの候補を逐次生成してはハッシュ化し,得られたハッシュ値がパスワードファイルに保存されているハッシュ値と一致するかどうか,しらみつぶしに確認することによって,ハッシュ値の元のパスワードを見つける攻撃方法である。
Cさんは,オフライン総当たり攻撃を難しくする方式として,ストレッチングという方式があることを知った。
この方式では,まず,ソルトとパスワードを連結した文字列をハッシュ化してハッシュ値を得る。次に,得られたハッシュ値の後にソルトとパスワードを連結し,その連結結果をハッシュ化する。この操作を指定した回数だけ繰り返すことによって,パスワードの照合に用いるハッシュ値を得る。パスワードファイルには,ソルト及びパスワードの照合に用いるハッシュ値に加えて,繰返し回数も保存する。この方式では,ハッシュ化の操作を1回だけ行う方式と比べると,攻撃者が,オフライン総当たり攻撃を行う際,[ ]。
解答群
| ア | 生成すべきパスワードの候補の最大文字列長が長くなる |
|---|---|
| イ | 一つのパスワードの候補から求めたハッシュ値の長さが長くなる |
| ウ | 一つのパスワードの候補から求めたハッシュ値を,パスワードファイルのハッシュ値と比較する回数が増える |
| エ | 一つのパスワードの候補からハッシュ値を求める時間が増加する |
答え : 設問1 (a)エ (b)イ 設問2 (c)イ (d)エ 設問3 エ
分野 : テクノロジ系 › 技術要素 › セキュリティ › 情報セキュリティ管理
分野 : テクノロジ系 › 技術要素 › セキュリティ › 情報セキュリティ管理
問2
論理回路に関する次の記述を読んで,設問1~3に答えよ。
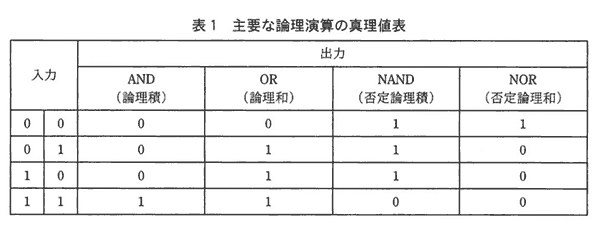
主要な論理演算の真理値表を表1に示す。
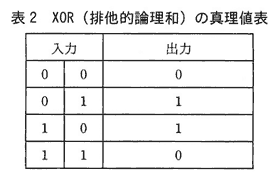
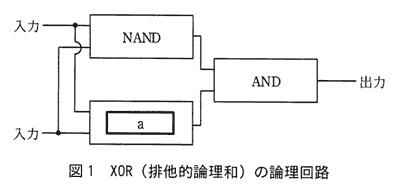
設問1 表1に示した論理演算を行う論理回路を用いて,表2に示すXOR(排他的論理和)の論理演算を行う論理回路を図1のとおり作成した。図1中の [ ] に入れる正しい答えを,解答群の中から選べ。
aに関する解答群
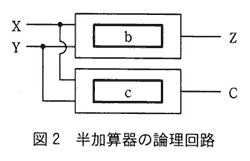
設問2 1桁の2進数X,Yを入力して,その和の下位桁をZ,桁上がりをCに出力する半加算器の論理回路を図2に示す。図2中の [ ] に入れる正しい答えを,解答群の中から選べ。
b,cに関する解答群
設問3 論理回路に関する次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
この論理回路は,1ビットの入力 X,Y をそれぞれパラメタ Wx,Wy で重み付けして加算した結果を求め,パラメタ T をしきい値として,次のとおりに動作する。
Wx×X+Wy×Y≧T のとき,1 を Z に出力する。
Wx×X+Wy×Y<T のとき,0 を Z に出力する。
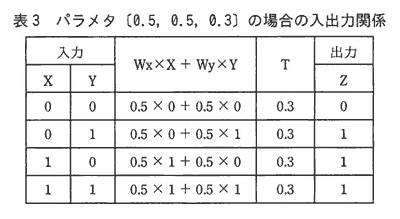
例えば,パラメタWxが 0.5,Wy が 0.5,T が 0.3(以下,パラメタ〔0.5,0.5,0.3〕のように表記する)の場合には,表3に示すとおり,この論理回路における入力と出力の関係(以下,入出力関係という)はOR(論理和)になる。
同様に,
(1) AND(論理積)になる入出力関係は,パラメタ [ d ] で実現できる。
(2) NAND(否定論理積)になる入出力関係は,パラメタ [ e ] で実現できる。
d,eに関する解答群
主要な論理演算の真理値表を表1に示す。
設問1 表1に示した論理演算を行う論理回路を用いて,表2に示すXOR(排他的論理和)の論理演算を行う論理回路を図1のとおり作成した。図1中の [ ] に入れる正しい答えを,解答群の中から選べ。
aに関する解答群
| ア | AND |
|---|---|
| イ | NAND |
| ウ | NOR |
| エ | OR |
設問2 1桁の2進数X,Yを入力して,その和の下位桁をZ,桁上がりをCに出力する半加算器の論理回路を図2に示す。図2中の [ ] に入れる正しい答えを,解答群の中から選べ。
b,cに関する解答群
| ア | AND |
|---|---|
| イ | NAND |
| ウ | NOR |
| エ | OR |
| オ | XOR |
設問3 論理回路に関する次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
この論理回路は,1ビットの入力 X,Y をそれぞれパラメタ Wx,Wy で重み付けして加算した結果を求め,パラメタ T をしきい値として,次のとおりに動作する。
Wx×X+Wy×Y≧T のとき,1 を Z に出力する。
Wx×X+Wy×Y<T のとき,0 を Z に出力する。
例えば,パラメタWxが 0.5,Wy が 0.5,T が 0.3(以下,パラメタ〔0.5,0.5,0.3〕のように表記する)の場合には,表3に示すとおり,この論理回路における入力と出力の関係(以下,入出力関係という)はOR(論理和)になる。
同様に,
(1) AND(論理積)になる入出力関係は,パラメタ [ d ] で実現できる。
(2) NAND(否定論理積)になる入出力関係は,パラメタ [ e ] で実現できる。
d,eに関する解答群
| ア | 〔-0.5,-0.5,-0.8〕 |
|---|---|
| イ | 〔-0.5,-0.5,-0.2〕 |
| ウ | 〔0.5,0.5,-0.5〕 |
| エ | 〔0.5,0.5,0.2〕 |
| オ | 〔0.5,0.5,0.8〕 |
| カ | 〔0.5,0.5,1.5〕 |
答え : 設問1 (a)エ 設問2 (b)オ (c)ア 設問3 (d)オ (e)ア
分野 : テクノロジ系 › コンピュータシステム › ハードウェア › ハードウェア
分野 : テクノロジ系 › コンピュータシステム › ハードウェア › ハードウェア
問3
小学生を対象とした,ある子供会の名簿を管理する関係データベースに関する次の記述を読んで,設問1~4に答えよ。
D子供会は,小学校に入学するときに入会を受け付け,小学校を卒業したら退会する。D子供会では,会員名簿を管理するためのデータベースを構築して,会の運営に活用している。
このたび,児童のイベントへの参加実績を記録するために,活動表とイベント表を追加した。
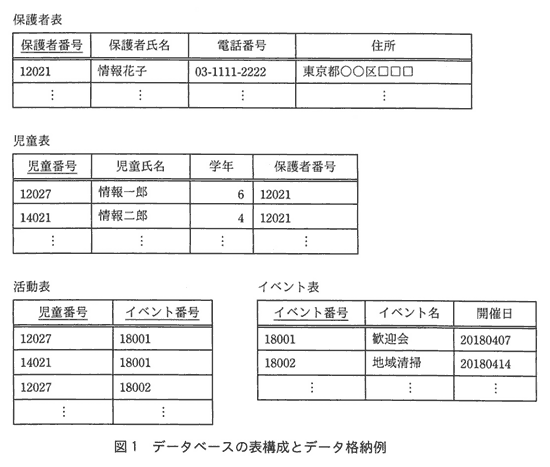
データベースの表構成とデータ格納例を図1に示す。下線付きの項目は,主キーを表す。
設問1 6年生を対象に実施するイベントの案内を配布するために,6年生の保護者の氏名と住所を抽出する。ここで,同一の保護者は重複して抽出しない。また,同じ住所に氏名が同じ保護者は,複数人いないものとする。正しいSQL文を,解答群の中から選べ。
解答群
設問2 イベント番号が18001のイベントに参加した児童のうち,1年生である児童の保護者の保護者番号と氏名を抽出する。ここで,同一の保護者は重複して抽出しない。次のSQL文の [ ] に入れる正しい答えを,解答群の中から選べ。
SELECT DISTINCT 保護者表.保護者番号, 保護者表.保護者氏名
[ a ]
aに関する解答群
設問3 イベント名と,そのイベントに参加した児童の数を表示する。次のSQL文の に入れる正しい答えを,解答群の中から選べ。ここで,イベント名は全て異なるものとする。
SELECT イベント表.イベント名,[ b ]
FROM 活動表, イベント表
WHERE 活動表.イベント番号 = イベント表.イベント番号
GROUP BY イベント表.イベント名
bに関する解答群
設問4 年度の切替えのために,次に示す手順で表を更新する。(1),(2)は入会前の準備のために3月31日に実行し,(3)~(7)は6年生が退会した4月1日に実行する。次のSQL文の [ ] に入れる正しい答えを,解答群の中から選べ。
〔手順〕
(1) 新入会児童の保護者のうち,未登録の保護者を登録する。
(2) 新入会児童を登録する。このとき,学年の値は0とする。
(3) 活動表のレコードを全て削除する。
(4) 児童表の全ての児童に対して,学年の値に1を加える。
(5) 児童表から,学年の値が7の児童を削除する。
(6) 次のSQL文を実行して,保護者表から,在籍する児童がいなくなった保護者を削除する。
DELETE FROM 保護者表
WHERE [ c ]
(7) イベント表のレコードを全て削除してから,新年度の計画に合わせてイベントを登録する。
cに関する解答群
D子供会は,小学校に入学するときに入会を受け付け,小学校を卒業したら退会する。D子供会では,会員名簿を管理するためのデータベースを構築して,会の運営に活用している。
このたび,児童のイベントへの参加実績を記録するために,活動表とイベント表を追加した。
データベースの表構成とデータ格納例を図1に示す。下線付きの項目は,主キーを表す。
設問1 6年生を対象に実施するイベントの案内を配布するために,6年生の保護者の氏名と住所を抽出する。ここで,同一の保護者は重複して抽出しない。また,同じ住所に氏名が同じ保護者は,複数人いないものとする。正しいSQL文を,解答群の中から選べ。
解答群
| ア | SELECT DISTINCT 保護者表.保護者氏名, 保護者表.住所 FROM 保護者表 WHERE 保護者表.保護者番号 NOT IN (SELECT 児童表.保護者番号 FROM 児童表 WHERE 児童表.学年 = 6) |
|---|---|
| イ | SELECT DISTINCT 保護者表.保護者氏名, 保護者表.住所 FROM 保護者表, 児童表 WHERE 児童表.学年 = 6 GROUP BY 保護者表.保護者氏名, 保護者表.住所 |
| ウ | SELECT DISTINCT 保護者表.保護者氏名, 保護者表.住所 FROM 保護者表, 児童表 WHERE 保護者表.保護者番号 = 児童表.保護者番号 AND 児童表.学年 = 6 |
| エ | SELECT 保護者表.保護者氏名, 保護者表.住所 FROM 保護者表, 児童表 WHERE 保護者表.保護者番号 = 児童表.保護者番号 GROUP BY 保護者表.保護者氏名, 保護者表.住所 HAVING 児童表.学年 = 6 |
設問2 イベント番号が18001のイベントに参加した児童のうち,1年生である児童の保護者の保護者番号と氏名を抽出する。ここで,同一の保護者は重複して抽出しない。次のSQL文の [ ] に入れる正しい答えを,解答群の中から選べ。
SELECT DISTINCT 保護者表.保護者番号, 保護者表.保護者氏名
[ a ]
aに関する解答群
| ア | FROM 児童表, 保護者表, イベント表 WHERE 児童表.学年 = 1 AND イベント表.イベント番号 = 18001 |
|---|---|
| イ | FROM 児童表, 保護者表, イベント表 WHERE 児童表.保護者番号 = 保護者表.保護者番号 AND 児童表.学年 = 1 AND イベント表.イベント番号 = 18001 |
| ウ | FROM 児童表, 活動表, 保護者表 WHERE 児童表.児童番号 = 活動表.児童番号 AND 児童表.保護者番号 = 保護者表.保護者番号 AND 活動表.イベント番号 = 18001 GROUP BY 児童表.児童氏名 HAVING 児童表.学年 = 1 |
| エ | FROM 児童表, 活動表, 保護者表 WHERE 児童表.児童番号 = 活動表.児童番号 AND 保護者表.保護者番号 = 保護者表.保護者番号 AND 児童表.学年 = 1 AND 活動表.イベント番号 = 18001 |
設問3 イベント名と,そのイベントに参加した児童の数を表示する。次のSQL文の に入れる正しい答えを,解答群の中から選べ。ここで,イベント名は全て異なるものとする。
SELECT イベント表.イベント名,[ b ]
FROM 活動表, イベント表
WHERE 活動表.イベント番号 = イベント表.イベント番号
GROUP BY イベント表.イベント名
bに関する解答群
| ア | AVG(活動表.イベント番号) |
|---|---|
| イ | COUNT(*) |
| ウ | MAX(活動表.イベント番号) エ SUM(活動表.イベント番号) |
| エ | SUM(活動表.イベント番号) |
設問4 年度の切替えのために,次に示す手順で表を更新する。(1),(2)は入会前の準備のために3月31日に実行し,(3)~(7)は6年生が退会した4月1日に実行する。次のSQL文の [ ] に入れる正しい答えを,解答群の中から選べ。
〔手順〕
(1) 新入会児童の保護者のうち,未登録の保護者を登録する。
(2) 新入会児童を登録する。このとき,学年の値は0とする。
(3) 活動表のレコードを全て削除する。
(4) 児童表の全ての児童に対して,学年の値に1を加える。
(5) 児童表から,学年の値が7の児童を削除する。
(6) 次のSQL文を実行して,保護者表から,在籍する児童がいなくなった保護者を削除する。
DELETE FROM 保護者表
WHERE [ c ]
(7) イベント表のレコードを全て削除してから,新年度の計画に合わせてイベントを登録する。
cに関する解答群
| ア | 保護者表.保護者番号 = NULL |
|---|---|
| イ | 保護者表.保護者番号 IN (SELECT 児童表.保護者番号 FROM 児童表 WHERE 児童表.学年 = 7) |
| ウ | 保護者表.保護者番号 IN (SELECT 児童表.保護者番号 FROM 児童表) |
| エ | 保護者表.保護者番号 NOT IN (SELECT 児童表.保護者番号 FROM 児童表) |
答え : 設問1 ウ 設問2 (a)エ 設問3 (b)イ 設問4 (c)エ
分野 : テクノロジ系 › 技術要素 › データベース › データ操作
分野 : テクノロジ系 › 技術要素 › データベース › データ操作
問4
クラウドサービス上でのシステム構築に関する次の記述を読んで,設問1,2に答えよ。
G社は,J社が運営するクラウドサービス上で,写真投稿サービス及び写真検索サービスを構築することにした。
(1) 写真投稿サービスは,利用者から投稿された写真を受け付け,自動で分類し,保管するサービスである。
(2) 写真検索サービスは,利用者から指定された条件に合致する写真を,保管されている写真の中から検索し,表示させるサービスである。
(3) 利用者は,PC,スマートフォンなど(以下,クライアントという)を用いてサービスを利用する。
システム構成を図1に示す。図1中の矢印の向きはアクセスの方向を示している。

写真投稿サービスにおける処理の概要は,次のとおりである。
(1) フロントサーバは,クライアントから写真を受け取り,一意なIDを写真に割り当て,ストレージサーバに保存する。
(2) フロントサーバは,写真のID,ストレージサーバ上での写真の保存場所などを,その写真の属性情報としてDBサーバに登録する。
(3) フロントサーバは,キューサーバに写真のIDを格納する。
(4) バックサーバは,キューサーバから写真のIDを取得する。
(5) バックサーバは,(4)で取得したIDに該当する写真の属性情報をDBサーバから検索し,ストレージサーバから写真を取得する。
(6) バックサーバは,(5)で取得した写真をあるアルゴリズムによって分類し,分類結果をDBサーバのその写真の属性情報に付加する。
(7) レプリケーションサーバは,ストレージサーバに定期的にアクセスし,新規に保存された写真を取得して自サーバ上に保存する。レプリケーションサーバ上の写真の保存場所は,ストレージサーバ上のそれと一意に対応付けられるように,あらかじめ定めてある規則に従って決定する。
写真検索サービスにおける処理の概要は,次のとおりである。
(1) フロントサーバは,クライアントから検索要求を受け取り,条件に合致する写真の属性情報をDBサーバから検索する。
(2) フロントサーバは,検索された写真の属性情報から,レプリケーションサーバに保存された写真にアクセスするためのURLを作成する。
(3) フロントサーバは,作成したURLを含むHTMLデータを生成してクライアントに返す。
(4) クライアントは,フロントサーバから返されたHTMLデータに基づきレプリケーションサーバにアクセスし,写真を取得して表示する。
なお,クライアントは,インターネットと負荷分散装置を介して,フロントサーバとレプリケーションサーバにアクセスする。
サーバは仮想マシン上で稼働させる。フロントサーバ及びバックサーバを稼働させる仮想マシンの主記憶容量やディスク容量は十分にあり,負荷に応じて台数を増減できる。
計算処理能力やネットワーク処理能力に着目すると,仮想マシンには幾つかのタイプがある。仮想マシンのタイプを表1に示す。
表1中の計算処理能力は,タイプAの計算処理能力を1としたときの相対的な値である。ネットワーク処理能力は,タイプAのネットワーク処理能力を1としたときの相対的な値である。
“1秒の計算処理量” とは,タイプAの仮想マシン1台を計算処理能力の100%で1秒間使用したときの処理量をいう。また, “1秒のネットワーク処理量” とは,タイプAの仮想マシン1台をネットワーク処理能力の100%で1秒間使用したときの処理量をいう。
フロントサーバにおいては,1要求当たり,計算処理量は0.1秒,ネットワーク処理量は0.07秒である。
クライアントからの要求が非常に多いとき,フロントサーバのコストを最も低く抑えることができる仮想マシンのタイプは [ a ] である。ここで,各仮想マシンの計算処理能力とネットワーク処理能力の平均の使用率は,それぞれ50%以下に抑えることとする。
バックサーバにはタイプDの仮想マシンを使用する。
バックサーバの写真1枚当たりの計算処理量は,25秒である。1時間当たり4,000枚の写真の投稿があるとき,計算処理能力の平均の使用率を50%以下とするのに最低限必要な仮想マシンの台数は b 台である。ここで,ネットワーク処理能力は足りているものとする。
図1中の各サーバ及び負荷分散装置(以下,サーバ類という)は表2に示すいずれかのグループに属しており,グループごとに他のグループやインターネットからのアクセス許可を設定することができる。サーバ類が受け付けるプロトコルを表3に示す。
各グループが許可するアクセスを必要最低限とすることにした結果,[ c ] が許可するアクセスは一致する。また,グループ3が許可するアクセスは表4に示すとおりになった。
表4は,グループ3に属するサーバ類が,アクセス元に指定したグループに属するサーバ類からの,指定したポート番号のポートを介してのアクセスを許可することを示している。
設問1 本文中の [ ] に入れる正しい答えを,解答群の中から選べ。
aに関する解答群
bに関する解答群
cに関する解答群
設問2 クライアントからの写真へのアクセスを,ストレージサーバがインターネットを介して直接受ける方法も考えられるが,この方法ではなく,図1のように負荷分散装置を介し,レプリケーションサーバが受けることの利点として適切な答えを,解答群の中から二つ選び,d,eに記号が五十音順になるよう記せ。(一部改題)
d,eに関する解答群
G社は,J社が運営するクラウドサービス上で,写真投稿サービス及び写真検索サービスを構築することにした。
(1) 写真投稿サービスは,利用者から投稿された写真を受け付け,自動で分類し,保管するサービスである。
(2) 写真検索サービスは,利用者から指定された条件に合致する写真を,保管されている写真の中から検索し,表示させるサービスである。
(3) 利用者は,PC,スマートフォンなど(以下,クライアントという)を用いてサービスを利用する。
システム構成を図1に示す。図1中の矢印の向きはアクセスの方向を示している。
写真投稿サービスにおける処理の概要は,次のとおりである。
(1) フロントサーバは,クライアントから写真を受け取り,一意なIDを写真に割り当て,ストレージサーバに保存する。
(2) フロントサーバは,写真のID,ストレージサーバ上での写真の保存場所などを,その写真の属性情報としてDBサーバに登録する。
(3) フロントサーバは,キューサーバに写真のIDを格納する。
(4) バックサーバは,キューサーバから写真のIDを取得する。
(5) バックサーバは,(4)で取得したIDに該当する写真の属性情報をDBサーバから検索し,ストレージサーバから写真を取得する。
(6) バックサーバは,(5)で取得した写真をあるアルゴリズムによって分類し,分類結果をDBサーバのその写真の属性情報に付加する。
(7) レプリケーションサーバは,ストレージサーバに定期的にアクセスし,新規に保存された写真を取得して自サーバ上に保存する。レプリケーションサーバ上の写真の保存場所は,ストレージサーバ上のそれと一意に対応付けられるように,あらかじめ定めてある規則に従って決定する。
写真検索サービスにおける処理の概要は,次のとおりである。
(1) フロントサーバは,クライアントから検索要求を受け取り,条件に合致する写真の属性情報をDBサーバから検索する。
(2) フロントサーバは,検索された写真の属性情報から,レプリケーションサーバに保存された写真にアクセスするためのURLを作成する。
(3) フロントサーバは,作成したURLを含むHTMLデータを生成してクライアントに返す。
(4) クライアントは,フロントサーバから返されたHTMLデータに基づきレプリケーションサーバにアクセスし,写真を取得して表示する。
なお,クライアントは,インターネットと負荷分散装置を介して,フロントサーバとレプリケーションサーバにアクセスする。
サーバは仮想マシン上で稼働させる。フロントサーバ及びバックサーバを稼働させる仮想マシンの主記憶容量やディスク容量は十分にあり,負荷に応じて台数を増減できる。
計算処理能力やネットワーク処理能力に着目すると,仮想マシンには幾つかのタイプがある。仮想マシンのタイプを表1に示す。
表1中の計算処理能力は,タイプAの計算処理能力を1としたときの相対的な値である。ネットワーク処理能力は,タイプAのネットワーク処理能力を1としたときの相対的な値である。
“1秒の計算処理量” とは,タイプAの仮想マシン1台を計算処理能力の100%で1秒間使用したときの処理量をいう。また, “1秒のネットワーク処理量” とは,タイプAの仮想マシン1台をネットワーク処理能力の100%で1秒間使用したときの処理量をいう。
フロントサーバにおいては,1要求当たり,計算処理量は0.1秒,ネットワーク処理量は0.07秒である。
クライアントからの要求が非常に多いとき,フロントサーバのコストを最も低く抑えることができる仮想マシンのタイプは [ a ] である。ここで,各仮想マシンの計算処理能力とネットワーク処理能力の平均の使用率は,それぞれ50%以下に抑えることとする。
バックサーバにはタイプDの仮想マシンを使用する。
バックサーバの写真1枚当たりの計算処理量は,25秒である。1時間当たり4,000枚の写真の投稿があるとき,計算処理能力の平均の使用率を50%以下とするのに最低限必要な仮想マシンの台数は b 台である。ここで,ネットワーク処理能力は足りているものとする。
図1中の各サーバ及び負荷分散装置(以下,サーバ類という)は表2に示すいずれかのグループに属しており,グループごとに他のグループやインターネットからのアクセス許可を設定することができる。サーバ類が受け付けるプロトコルを表3に示す。
| グループ | グループに属するサーバ類 |
| 1 | 負荷分散装置 |
| 2 | フロントサーバ |
| 3 | DBサーバ,キューサーバ |
| 4 | バックサーバ |
| 5 | ストレージサーバ |
| 6 | レプリケーションサーバ |
| サーバ類 | プロトコル | ポート番号 |
| フロントサーバ | HTTP | 80 |
| キューサーバ | 独自 | 15672 |
| バックサーバ | 無し | 無し |
| ストレージサーバ | HTTP | 80 |
| DBサーバ | 独自 | 15432 |
| レプリケーションサーバ | HTTP | 80 |
| HTTP over TLS | 443 |
各グループが許可するアクセスを必要最低限とすることにした結果,[ c ] が許可するアクセスは一致する。また,グループ3が許可するアクセスは表4に示すとおりになった。
表4は,グループ3に属するサーバ類が,アクセス元に指定したグループに属するサーバ類からの,指定したポート番号のポートを介してのアクセスを許可することを示している。
| アクセス元 | ート番号 |
| グループ2 | 15432と15672 |
| グループ4 | 15432と15672 |
設問1 本文中の [ ] に入れる正しい答えを,解答群の中から選べ。
aに関する解答群
| ア | A |
|---|---|
| イ | B |
| ウ | C |
| エ | D |
bに関する解答群
| ア | 4 |
|---|---|
| イ | 7 |
| ウ | 28 |
| エ | 56 |
cに関する解答群
| ア | グループ1,2,5及び6 |
|---|---|
| イ | グループ2,5及び6 |
| ウ | グループ2及び6 |
| エ | グループ5及び6 |
設問2 クライアントからの写真へのアクセスを,ストレージサーバがインターネットを介して直接受ける方法も考えられるが,この方法ではなく,図1のように負荷分散装置を介し,レプリケーションサーバが受けることの利点として適切な答えを,解答群の中から二つ選び,d,eに記号が五十音順になるよう記せ。(一部改題)
d,eに関する解答群
| ア | クライアントからの写真へのアクセスが増加しても,ストレージサーバの負荷は高まらない。 |
|---|---|
| イ | クライアントと写真へのアクセスに応答するサーバとの間に介在するサーバ類の台数が少ないので,ネットワーク遅延が小さい。 |
| ウ | ストレージサーバに障害が発生しても,写真検索サービスの提供を継続できる。 |
| エ | ストレージサーバに障害が発生しても,写真投稿サービスの提供を継続できる。 |
| オ | 全てのフロントサーバに障害が発生しても,写真検索サービスの提供を継続できる。 |
答え : 設問1 (a)イ (b)イ (c)ウ 設問2 (d)ア (e)ウ
分野 : テクノロジ系 › 技術要素 › ネットワーク › ネットワーク方式
分野 : テクノロジ系 › 技術要素 › ネットワーク › ネットワーク方式
問5
健康管理システムの設計に関する次の記述を読んで,設問1,2に答えよ。
K社は,従業員の健康診断管理業務に健康管理システムを利用している。全従業員には,年1回,誕生月に定期健康診断を受診させる。再検査が必要となった場合には,再度,健康診断を受診させる。
〔健康管理システムを利用した健康診断管理業務の説明〕
月初に,受診日(当月中旬の特定日)を指定して受診案内を通知する。受診すれば,受診した月の月末に健康診断結果を通知する。
(1) 健康管理システムに,当月の受診対象者を登録する。
① 当月が誕生月である従業員を抽出する。
② 前月の定期健康診断において,再検査が必要と判定された従業員を抽出する。
③ ①と②で抽出した従業員を受診対象者とし,健康診断コースを決定する。
④ 受診日を決定し,受診対象者の健康診断レコードを健康管理システムに登録する。
(2) 受診案内を受診対象者に通知する。
(3) 定期健康診断及び再検査の受診後に,受診者の判定結果などを健康管理システムに登録する。
(4) 受診者に,健康診断結果を通知する。
〔健康管理システムの機能の説明〕
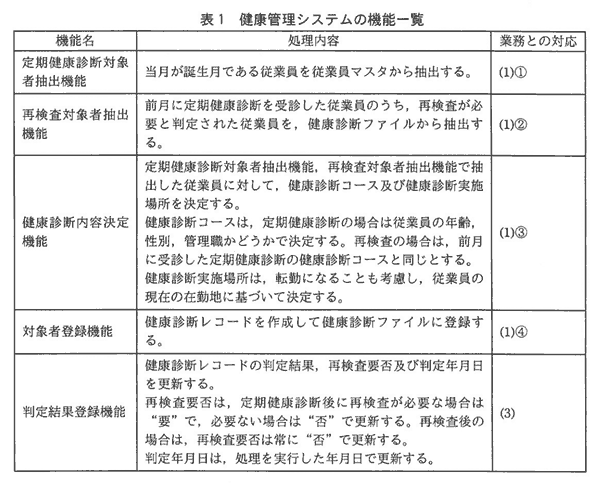
健康管理システムの機能一覧を,表1に示す。表1において, “業務との対応” 列の項番は,〔健康管理システムを利用した健康診断管理業務の説明〕の項番に対応する。各機能では,健康管理システムの健康診断ファイルのアクセスと,人事システムの各マスタファイル(以下,マスタという)の情報の参照を行う。
〔健康管理システム及び人事システムの関係の説明〕
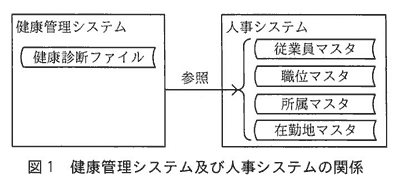
健康管理システムは,健康診断結果を健康診断ファイルで管理し,従業員の情報については,必要な項目の最新情報を人事システムの各マスタを参照して利用する。健康管理システム及び人事システムの関係は,図1のとおりである。
〔健康診断ファイルの説明〕
健康診断ファイルのレコード様式を,図2に示す。下線付きの項目は,主キーである。
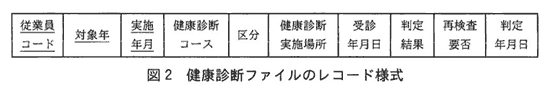
(1) 対象年には,定期健康診断の受診対象となった年を設定する。再検査の場合は,前月に受診した定期健康診断の対象年と同じとする。
(2) 実施年月には,健康診断を受診する年月を設定する。
(3) 区分には,定期健康診断の場合は"定期"を,再検査の場合は"再検"を設定する。
(4) 判定結果,再検査要否及び判定年月日は,対象者登録機能で空白を設定し,判定結果登録機能で更新する。
〔人事システムの各マスタの説明〕
健康管理システムが参照する人事システムの各マスタのレコード様式を,図3に示す。下線付きの項目は,主キーである。
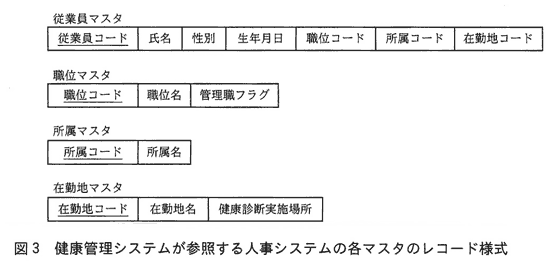
従業員マスタは,従業員の氏名,性別,生年月日などを保持する。従業員コードは,従業員に一意に付けられた番号であり,在勤地コードには,現在の在勤地の在勤地コードが入っている。職位マスタは,職位名と管理職フラグを保持し,管理職フラグで管理職かどうかが判別できる。在勤地マスタは,在勤地名とその在勤地の健康診断実施場所を保持する。
設問1 次の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。
健康診断内容決定機能において,定期健康診断対象者抽出機能で従業員マスタから抽出された情報に加えて,定期健康診断の健康診断コース及び健康診断実施場所を決定するために最低限必要となるのは,[ a ] の情報である。再検査対象者抽出機能で健康診断ファイルから抽出された情報に加えて,再検査の健康診断実施場所を決定するために最低限必要となるのは,[ b ] の情報である。
a,bに関する解答群
設問2 次の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。
今回,健康管理業務として,12月の受診者の健康診断の判定結果を登録した後に,当年の健康診断の未受診者を抽出することになった。そのために,未受診者抽出機能を追加することにした。ここで,当年の健康診断の未受診者は,従業員マスタから情報が抽出できる従業員のうち,次のいずれかに該当する者とする。
(1) 当年の定期健康診断の健康診断レコードが存在しない。
(2) 当年の定期健康診断の判定結果が登録されていない。
(3) 当年の定期健康診断の結果,再検査が必要と判定されたが,再検査の健康診断レコードが存在しない,又はその判定結果が登録されていない。
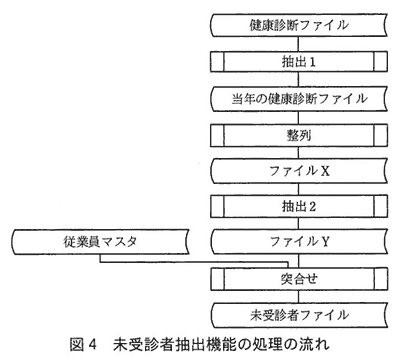
未受診者抽出機能の処理の流れを図4に示す。ここで,図4の従業員マスタは従業員コードの昇順で整列されているものとする。
〔未受診者抽出機能の処理の説明〕
(1) 図4の突合せ処理において,各ファイルを先頭から順次読み込んで処理できるように,前処理として次の①~③を実行する。
① 抽出1処理で,対象年が当年のレコードを健康診断ファイルから抽出し,当年の健康診断ファイルを作成する。
② 整列処理で,当年の健康診断ファイルを [ c ] で整列し,ファイルXを作成する。
③ 抽出2処理で,ファイルXのレコードを先頭から順にファイルYに出力する。ここで,[ d ] が連続した場合には,最初に出現したレコードだけを出力する。
(2) 突合せ処理で,従業員マスタに存在する従業員コードに対して,次に示す①又は②のいずれかに該当する場合に,従業員コードを未受診者ファイルに出力する。
① 従業員コードが一致するレコードがファイルYに存在しない。
② [ e ] のレコードがファイルYに存在する。
cに関する解答群
dに関する解答群
eに関する解答群
K社は,従業員の健康診断管理業務に健康管理システムを利用している。全従業員には,年1回,誕生月に定期健康診断を受診させる。再検査が必要となった場合には,再度,健康診断を受診させる。
〔健康管理システムを利用した健康診断管理業務の説明〕
月初に,受診日(当月中旬の特定日)を指定して受診案内を通知する。受診すれば,受診した月の月末に健康診断結果を通知する。
(1) 健康管理システムに,当月の受診対象者を登録する。
① 当月が誕生月である従業員を抽出する。
② 前月の定期健康診断において,再検査が必要と判定された従業員を抽出する。
③ ①と②で抽出した従業員を受診対象者とし,健康診断コースを決定する。
④ 受診日を決定し,受診対象者の健康診断レコードを健康管理システムに登録する。
(2) 受診案内を受診対象者に通知する。
(3) 定期健康診断及び再検査の受診後に,受診者の判定結果などを健康管理システムに登録する。
(4) 受診者に,健康診断結果を通知する。
〔健康管理システムの機能の説明〕
健康管理システムの機能一覧を,表1に示す。表1において, “業務との対応” 列の項番は,〔健康管理システムを利用した健康診断管理業務の説明〕の項番に対応する。各機能では,健康管理システムの健康診断ファイルのアクセスと,人事システムの各マスタファイル(以下,マスタという)の情報の参照を行う。
〔健康管理システム及び人事システムの関係の説明〕
健康管理システムは,健康診断結果を健康診断ファイルで管理し,従業員の情報については,必要な項目の最新情報を人事システムの各マスタを参照して利用する。健康管理システム及び人事システムの関係は,図1のとおりである。
〔健康診断ファイルの説明〕
健康診断ファイルのレコード様式を,図2に示す。下線付きの項目は,主キーである。
(1) 対象年には,定期健康診断の受診対象となった年を設定する。再検査の場合は,前月に受診した定期健康診断の対象年と同じとする。
(2) 実施年月には,健康診断を受診する年月を設定する。
(3) 区分には,定期健康診断の場合は"定期"を,再検査の場合は"再検"を設定する。
(4) 判定結果,再検査要否及び判定年月日は,対象者登録機能で空白を設定し,判定結果登録機能で更新する。
〔人事システムの各マスタの説明〕
健康管理システムが参照する人事システムの各マスタのレコード様式を,図3に示す。下線付きの項目は,主キーである。
従業員マスタは,従業員の氏名,性別,生年月日などを保持する。従業員コードは,従業員に一意に付けられた番号であり,在勤地コードには,現在の在勤地の在勤地コードが入っている。職位マスタは,職位名と管理職フラグを保持し,管理職フラグで管理職かどうかが判別できる。在勤地マスタは,在勤地名とその在勤地の健康診断実施場所を保持する。
設問1 次の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。
健康診断内容決定機能において,定期健康診断対象者抽出機能で従業員マスタから抽出された情報に加えて,定期健康診断の健康診断コース及び健康診断実施場所を決定するために最低限必要となるのは,[ a ] の情報である。再検査対象者抽出機能で健康診断ファイルから抽出された情報に加えて,再検査の健康診断実施場所を決定するために最低限必要となるのは,[ b ] の情報である。
a,bに関する解答群
| ア | 従業員マスタ |
|---|---|
| イ | 従業員マスタ及び職位マスタ |
| ウ | 従業員マスタ及び在勤地マスタ |
| エ | 従業員マスタ,職位マスタ及び在勤地マスタ |
| オ | 職位マスタ |
| カ | 職位マスタ及び所属マスタ |
| キ | 職位マスタ及び在勤地マスタ |
| ク | 所属マスタ |
| ケ | 所属マスタ及び在勤地マスタ |
| コ | 在勤地マスタ |
設問2 次の記述中の [ ] に入れる適切な答えを,解答群の中から選べ。
今回,健康管理業務として,12月の受診者の健康診断の判定結果を登録した後に,当年の健康診断の未受診者を抽出することになった。そのために,未受診者抽出機能を追加することにした。ここで,当年の健康診断の未受診者は,従業員マスタから情報が抽出できる従業員のうち,次のいずれかに該当する者とする。
(1) 当年の定期健康診断の健康診断レコードが存在しない。
(2) 当年の定期健康診断の判定結果が登録されていない。
(3) 当年の定期健康診断の結果,再検査が必要と判定されたが,再検査の健康診断レコードが存在しない,又はその判定結果が登録されていない。
未受診者抽出機能の処理の流れを図4に示す。ここで,図4の従業員マスタは従業員コードの昇順で整列されているものとする。
〔未受診者抽出機能の処理の説明〕
(1) 図4の突合せ処理において,各ファイルを先頭から順次読み込んで処理できるように,前処理として次の①~③を実行する。
① 抽出1処理で,対象年が当年のレコードを健康診断ファイルから抽出し,当年の健康診断ファイルを作成する。
② 整列処理で,当年の健康診断ファイルを [ c ] で整列し,ファイルXを作成する。
③ 抽出2処理で,ファイルXのレコードを先頭から順にファイルYに出力する。ここで,[ d ] が連続した場合には,最初に出現したレコードだけを出力する。
(2) 突合せ処理で,従業員マスタに存在する従業員コードに対して,次に示す①又は②のいずれかに該当する場合に,従業員コードを未受診者ファイルに出力する。
① 従業員コードが一致するレコードがファイルYに存在しない。
② [ e ] のレコードがファイルYに存在する。
cに関する解答群
| ア | 従業員コードの昇順 |
|---|---|
| イ | 従業員コードの昇順,実施年月の昇順 |
| ウ | 従業員コードの昇順,実施年月の降順 |
| エ | 従業員コードの降順 |
| オ | 従業員コードの降順,実施年月の昇順 |
| カ | 従業員コードの降順,実施年月の降順 |
dに関する解答群
| ア | 同じ従業員コード |
|---|---|
| イ | 同じ従業員コード及び区分 |
| ウ | 同じ健康診断コース |
| エ | 同じ健康診断コース及び区分 |
eに関する解答群
| ア | 判定結果が空白 |
|---|---|
| イ | 再検査要否が “要” |
| ウ | 再検査要否が “否” |
| エ | 判定結果が空白,又は再検査要否が “要” |
| オ | 判定結果が空白,又は再検査要否が “否” |
答え : 設問1 (a)キ (b)ウ 設問2 (c)ウ (d)ア (e)エ
分野 : テクノロジ系 › 開発技術 › システム開発技術 › 設計
分野 : テクノロジ系 › 開発技術 › システム開発技術 › 設計
問6
EVM(Earned Value Management)手法を用いたプロジェクト管理に関する次の記述を読んで,設問1~3に答えよ。
S社では,クライアントサーバシステムとして構築されている既存の営業システムを,Webシステムに刷新するプロジェクト(以下,刷新プロジェクトという)を立ち上げた。Webシステムとして構築する営業システムを,新営業システムと呼ぶ。
N社は,この刷新プロジェクトにおける外部設計から結合テストまでを受注した。
〔刷新プロジェクトへのN社の対応〕
(1) S社から提示された刷新プロジェクトの結合テストまでのスケジュールは,図1のとおりである。
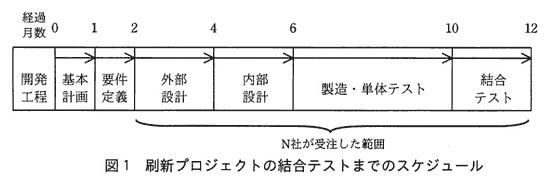
(2) 新営業システムは,サブシステムS1(以下,S1という),サブシステムS2(以下,S2という)及び共通機能の三つのサブシステムで構成される。N社はこの構成に合わせて外部設計から結合テストまでを実施するプロジェクト(以下,プロジェクトという)体制を構築し,プロジェクトマネージャは,システム企画部に所属するY君が担当する。
(3) N社では,新営業システムと類似するWebシステムの開発をこれまで複数案件行っており,組織のプロセス資産として各開発工程の生産性のデータを保有している。N社が保有する各開発工程の生産性を,表1に示す。Y君は,要件定義の成果物である要件定義書とN社の過去の開発実績を参考にして,表2に示すとおりに新営業システムの開発規模を見積もった。ここで,KLOC(Kilo Lines Of Code)は,ソースコード1,000行を単位とする指標である。
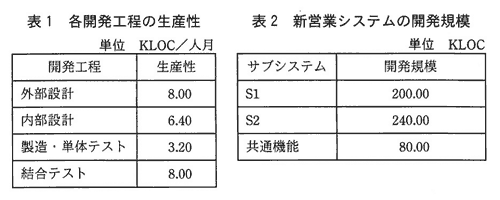
Y君は,(1)~(3)を前提に,各開発工程を完了させるために必要となる計画時点の工数(以下,計画工数という)を算出してプロジェクト計画を作成した。ここで,1か月の作業日数は20日とする。各開発工程における計画工数は,作業する各月に対して均等に割り当てる。例えば,外部設計を10.00人月と見積もった場合,外部設計の期間は2か月なので,各月に5.00人月を割り当てる。
設問1 外部設計と内部設計のサブシステムごとの計画工数を,表3に示す。表3中の に入れる正しい答えを,解答群の中から選べ。
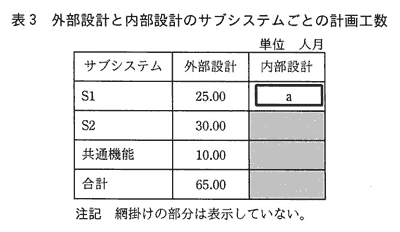
aに関する解答群
設問2 次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
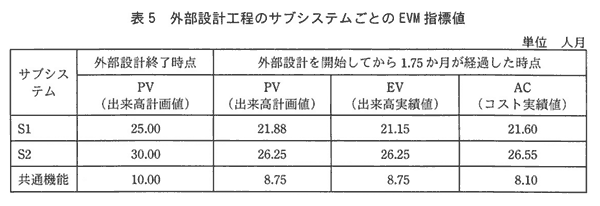
N社では,進捗遅延やコスト超過を早期に検出することを目的として,EVM手法を用いたプロジェクト管理を行っている。EVM手法では,プロジェクトの計画と実績について,定量的な情報を用いて進捗状況やコスト状況を分析し,評価する。EVM手法で使う各指標(以下,EVM指標という)のN社での意味を,表4に示す。
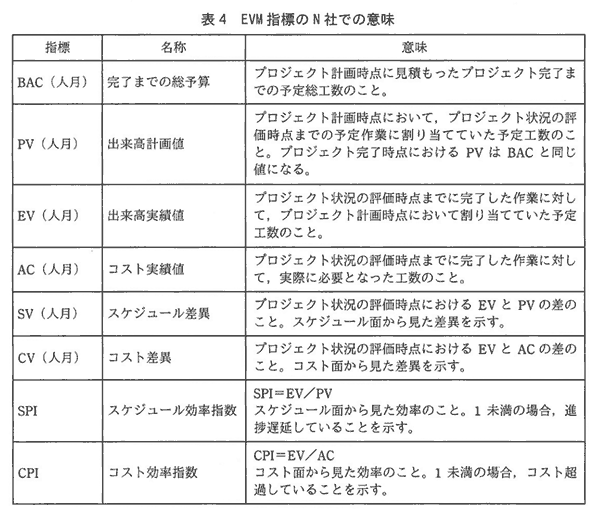
外部設計を開始してから35作業日(1.75か月)が経過した時点での,外部設計工程のサブシステムごとのEVM指標値を,表5に示す。ここで,表5のEVM指標値は,小数点第3位を四捨五入した値である。
次の(1)~(6)の記述のうち,表5のEVM指標値から予測した,外部設計が終了する時点での見通しとして適切な組合せは,[ ] である。ここで,予測に当たってSPI及びCPIは,表5の実績と同等であるものとする。
(1) S1については,ACが外部設計終了時点のPVを超過しない。また,外部設計はスケジュール遅延せずに完了する。
(2) S1については,ACが外部設計終了時点のPVを超過する。また,外部設計はスケジュール遅延せずに完了する。
(3) S2については,外部設計はスケジュール遅延する。
(4) S2については,ACが外部設計終了時点のPVを超過する。また,外部設計はスケジュール遅延せずに完了する。
(5) 共通機能については,外部設計はスケジュール遅延する。
(6) 共通機能については,ACが外部設計終了時点のPVを超過しない。また,外部設計はスケジュール遅延せずに完了する。
解答群
設問3 次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。ここで,e1~e3に入れる答えは,eに関する解答群の中から組合せとして正しいものを選ぶものとする。
図2は,外部設計を開始した時点から,結合テストを開始して1か月が経過した時点までの,各経過月末時点のEVM指標値をグラフにしたものである。Y君は,このグラフを用いてプロジェクトの現状分析を行うことにした。
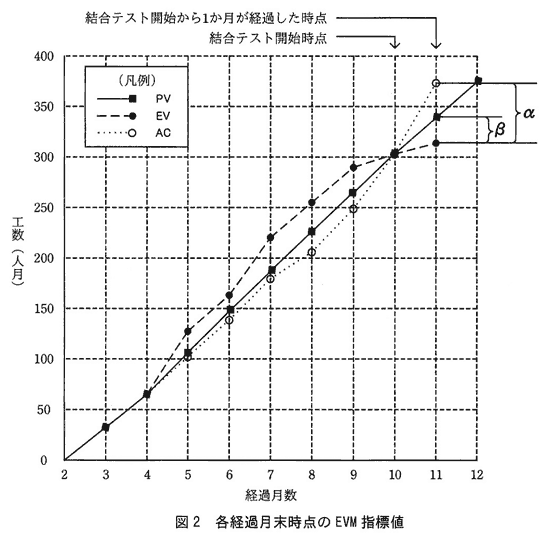
結合テスト開始後,[ b ] であることがグラフから読み取れる。また,αは [ c ] を表し,βは [ d ] を表している。
次に,未完了である残作業の作業工数(以下,残作業工数という)を式 “ [ e1 ] - [ e2 ] ” で求めた。この残作業工数は,プロジェクト計画時点の見積りに基づいているが,今後の作業は計画どおり進捗するものとして,この残作業工数に [ e3 ] を加算し,プロジェクトの全ての作業が完了したときの総工数の予測値を見直した。
bに関する解答群
c,dに関する解答群
eに関する解答群
S社では,クライアントサーバシステムとして構築されている既存の営業システムを,Webシステムに刷新するプロジェクト(以下,刷新プロジェクトという)を立ち上げた。Webシステムとして構築する営業システムを,新営業システムと呼ぶ。
N社は,この刷新プロジェクトにおける外部設計から結合テストまでを受注した。
〔刷新プロジェクトへのN社の対応〕
(1) S社から提示された刷新プロジェクトの結合テストまでのスケジュールは,図1のとおりである。
(2) 新営業システムは,サブシステムS1(以下,S1という),サブシステムS2(以下,S2という)及び共通機能の三つのサブシステムで構成される。N社はこの構成に合わせて外部設計から結合テストまでを実施するプロジェクト(以下,プロジェクトという)体制を構築し,プロジェクトマネージャは,システム企画部に所属するY君が担当する。
(3) N社では,新営業システムと類似するWebシステムの開発をこれまで複数案件行っており,組織のプロセス資産として各開発工程の生産性のデータを保有している。N社が保有する各開発工程の生産性を,表1に示す。Y君は,要件定義の成果物である要件定義書とN社の過去の開発実績を参考にして,表2に示すとおりに新営業システムの開発規模を見積もった。ここで,KLOC(Kilo Lines Of Code)は,ソースコード1,000行を単位とする指標である。
Y君は,(1)~(3)を前提に,各開発工程を完了させるために必要となる計画時点の工数(以下,計画工数という)を算出してプロジェクト計画を作成した。ここで,1か月の作業日数は20日とする。各開発工程における計画工数は,作業する各月に対して均等に割り当てる。例えば,外部設計を10.00人月と見積もった場合,外部設計の期間は2か月なので,各月に5.00人月を割り当てる。
設問1 外部設計と内部設計のサブシステムごとの計画工数を,表3に示す。表3中の に入れる正しい答えを,解答群の中から選べ。
aに関する解答群
| ア | 25.75 |
|---|---|
| イ | 30.00 |
| ウ | 31.25 |
| エ | 37.50 |
設問2 次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
N社では,進捗遅延やコスト超過を早期に検出することを目的として,EVM手法を用いたプロジェクト管理を行っている。EVM手法では,プロジェクトの計画と実績について,定量的な情報を用いて進捗状況やコスト状況を分析し,評価する。EVM手法で使う各指標(以下,EVM指標という)のN社での意味を,表4に示す。
外部設計を開始してから35作業日(1.75か月)が経過した時点での,外部設計工程のサブシステムごとのEVM指標値を,表5に示す。ここで,表5のEVM指標値は,小数点第3位を四捨五入した値である。
次の(1)~(6)の記述のうち,表5のEVM指標値から予測した,外部設計が終了する時点での見通しとして適切な組合せは,[ ] である。ここで,予測に当たってSPI及びCPIは,表5の実績と同等であるものとする。
(1) S1については,ACが外部設計終了時点のPVを超過しない。また,外部設計はスケジュール遅延せずに完了する。
(2) S1については,ACが外部設計終了時点のPVを超過する。また,外部設計はスケジュール遅延せずに完了する。
(3) S2については,外部設計はスケジュール遅延する。
(4) S2については,ACが外部設計終了時点のPVを超過する。また,外部設計はスケジュール遅延せずに完了する。
(5) 共通機能については,外部設計はスケジュール遅延する。
(6) 共通機能については,ACが外部設計終了時点のPVを超過しない。また,外部設計はスケジュール遅延せずに完了する。
解答群
| ア | (1)と(4) |
|---|---|
| イ | (1)と(5) |
| ウ | (2)と(3) |
| エ | (2)と(4) |
| オ | (3)と(5) |
| カ | (3)と(6) |
| キ | (4)と(5) |
| ク | (4)と(6) |
設問3 次の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。ここで,e1~e3に入れる答えは,eに関する解答群の中から組合せとして正しいものを選ぶものとする。
図2は,外部設計を開始した時点から,結合テストを開始して1か月が経過した時点までの,各経過月末時点のEVM指標値をグラフにしたものである。Y君は,このグラフを用いてプロジェクトの現状分析を行うことにした。
結合テスト開始後,[ b ] であることがグラフから読み取れる。また,αは [ c ] を表し,βは [ d ] を表している。
次に,未完了である残作業の作業工数(以下,残作業工数という)を式 “ [ e1 ] - [ e2 ] ” で求めた。この残作業工数は,プロジェクト計画時点の見積りに基づいているが,今後の作業は計画どおり進捗するものとして,この残作業工数に [ e3 ] を加算し,プロジェクトの全ての作業が完了したときの総工数の予測値を見直した。
bに関する解答群
| ア | 進捗状況とコスト状況のどちらも悪化傾向 |
|---|---|
| イ | 進捗状況とコスト状況のどちらも改善傾向 |
| ウ | 進捗状況は改善傾向,コスト状況は悪化傾向 |
| エ | 進捗状況は悪化傾向,コスト状況は改善傾向 |
c,dに関する解答群
| ア | BAC(完了までの総予算) |
|---|---|
| イ | PV(出来高計画値) |
| ウ | EV(出来高実績値) |
| エ | AC(コスト実績値) |
| オ | SV(スケジュール差異) |
| カ | CV(コスト差異) |
eに関する解答群
| e1 | e2 | e3 | |
| ア | BAC | AC | EV |
| イ | BAC | EV | AC |
| ウ | BAC | PV | EV |
| エ | PV | AC | EV |
| オ | PV | BAC | EV |
| カ | PV | EV | AC |
答え : 設問1 (a)ウ 設問2 ク 設問3 (b)ア (c)カ (d)オ (e)イ
分野 : マネジメント系 › プロジェクトマネジメント › プロジェクトマネジメント › プロジェクトマネジメント
分野 : マネジメント系 › プロジェクトマネジメント › プロジェクトマネジメント › プロジェクトマネジメント
問7
収益の検討に関する次の記述を読んで,設問1~3に答えよ。
小規模な部品メーカであるR社は,部品Tだけを生産して大手機械メーカに販売している。
設問1 次の記述中の に入れる適切な答えを,解答群の中から選べ。
利益計画を策定するために,部品Tの販売数について2通りの検討を行った。表1は,部品Tの販売数を1,000千個見込むケースXと,1,200千個見込むケースYについての収益検討表である。両ケースの,売上高に対する変動費の比率(以下,変動費率という)は等しく,固定費は同額である。
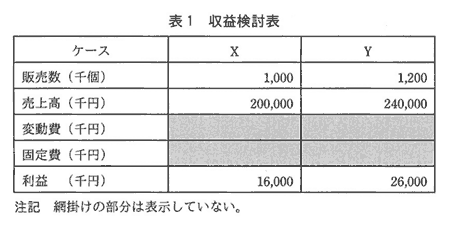
表1から,変動費率は [ a ] %,固定費は [ b ] 千円である。よって,利益が0になる売上高(以下,損益分岐点売上高という)は,[ c ] 千円となる。
R社では,販売先から値下げ要求があることを想定して,販売数及び変動費を変えずに販売単価を下げた場合の値下げ率(値下げ額÷値下げ前の販売単価)と利益の計算を行った。利益がマイナスにならない最大の値下げ率は,ケースXでは [ d ] %であり,ケースYではケースX [ e ]。
aに関する解答群
bに関する解答群
cに関する解答群
dに関する解答群
eに関する解答群
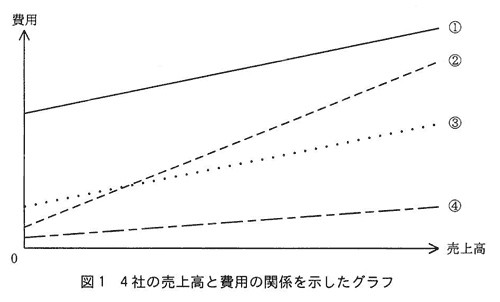
設問2 R社は,変動費と固定費の合計(以下,費用という)と売上高の関係を他の3社と比較して,分析した。その結果,変動費率はR社が他社と比べて最も高いことが分かった。売上高と費用の関係を示したグラフを,図1に示す。図1のグラフ①~④のうち,R社に該当するものを,解答群の中から選べ。
解答群
設問3 R社は,変動費率を下げる取組みを開始した。次の記述中の に入れる適切な答えを,解答群の中から選べ。
R社は,固定費を変えずに変動費率だけを下げることによって,損益分岐点売上高を [ f ] こととした。そのために,[ g ] 取組みを開始した。
fに関する解答群
gに関する解答群
小規模な部品メーカであるR社は,部品Tだけを生産して大手機械メーカに販売している。
設問1 次の記述中の に入れる適切な答えを,解答群の中から選べ。
利益計画を策定するために,部品Tの販売数について2通りの検討を行った。表1は,部品Tの販売数を1,000千個見込むケースXと,1,200千個見込むケースYについての収益検討表である。両ケースの,売上高に対する変動費の比率(以下,変動費率という)は等しく,固定費は同額である。
表1から,変動費率は [ a ] %,固定費は [ b ] 千円である。よって,利益が0になる売上高(以下,損益分岐点売上高という)は,[ c ] 千円となる。
R社では,販売先から値下げ要求があることを想定して,販売数及び変動費を変えずに販売単価を下げた場合の値下げ率(値下げ額÷値下げ前の販売単価)と利益の計算を行った。利益がマイナスにならない最大の値下げ率は,ケースXでは [ d ] %であり,ケースYではケースX [ e ]。
aに関する解答群
| ア | 25 |
|---|---|
| イ | 40 |
| ウ | 60 |
| エ | 75 |
| オ | 80 |
bに関する解答群
| ア | 16,000 |
|---|---|
| イ | 34,000 |
| ウ | 64,000 |
| エ | 104,000 |
| オ | 134,000 |
cに関する解答群
| ア | 45,333 |
|---|---|
| イ | 64,000 |
| ウ | 85,333 |
| エ | 136,000 |
| オ | 256,000 |
dに関する解答群
| ア | 4 |
|---|---|
| イ | 8 |
| ウ | 10 |
| エ | 12 |
| オ | 16 |
eに関する解答群
| ア | と変わらない |
|---|---|
| イ | よりも大きい |
| ウ | よりも小さい |
設問2 R社は,変動費と固定費の合計(以下,費用という)と売上高の関係を他の3社と比較して,分析した。その結果,変動費率はR社が他社と比べて最も高いことが分かった。売上高と費用の関係を示したグラフを,図1に示す。図1のグラフ①~④のうち,R社に該当するものを,解答群の中から選べ。
解答群
| ア | ① |
|---|---|
| イ | ② |
| ウ | ③ |
| エ | ④ |
設問3 R社は,変動費率を下げる取組みを開始した。次の記述中の に入れる適切な答えを,解答群の中から選べ。
R社は,固定費を変えずに変動費率だけを下げることによって,損益分岐点売上高を [ f ] こととした。そのために,[ g ] 取組みを開始した。
fに関する解答群
| ア | 上げる |
|---|---|
| イ | 下げる |
| ウ | 0にする |
gに関する解答群
| ア | 原材料の単価を下げる |
|---|---|
| イ | 社員の給与を上げる |
| ウ | 販売数を増やす |
| エ | 販売単価を下げる |
答え : 設問1 (a)エ (b)イ (c)エ (d)イ (e)イ 設問2 イ 設問3 (f)イ (g)ア
分野 : ストラテジ系 › 企業と法務 › 企業活動 › 業務分析・データ利活用
分野 : ストラテジ系 › 企業と法務 › 企業活動 › 業務分析・データ利活用
問8
次のプログラムの説明及びプログラムを読んで,設問1,2に答えよ。
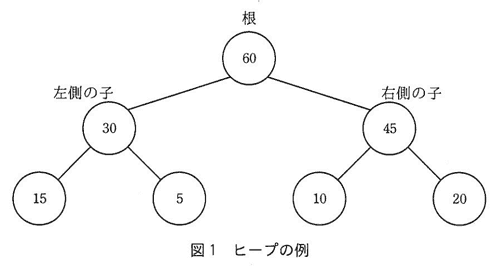
ヒープの性質を利用して,データを昇順に整列するアルゴリズムを考える。ヒープは二分木であり,本問では,親は一つ又は二つの子をもち,親の値は子の値よりも常に大きいか等しいという性質をもつものとする。ヒープの例を図1に示す。図1において,丸は節を,丸の中の数値は各節が保持する値を表す。子をもつ節を,その子に対する親と呼ぶ。親をもたない節を根と呼び,根は最大の値をもつ。
〔プログラム1の説明〕
(1) 配列の要素番号は,0から始まる。
(2) 副プログラム makeHeap は,整数型の1次元配列 data に格納されている hnum 個(hnum>0)のデータを,次の①~③の規則で整数型の1次元配列 heap に格納して,ヒープを配列で実現する。この状態を, “配列 heap は,ヒープの性質を満たしている” という。
① 配列要素 heap[i](i=0,1,2,…)は,節に対応する。配列要素 heap[i] には,節が保持する値を格納する。
② 配列要素 heap[0] は,根に対応する。
③ 配列要素 heap[i](i=0,1,2,…)に対応する節の左側の子は配列要素 heap[2×i+1] に対応し,右側の子は配列要素 heap[2×i+2] に対応する。子が一つの場合,左側の子として扱う。
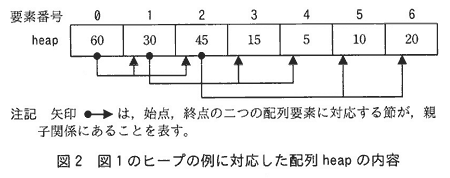
(3) 図1のヒープの例に対応した配列heapの内容を,図2に示す。
(4) 親の要素番号と子の要素番号を関係付ける三つの関数がある。
①整数型:lchild(整数型:i)
要素番号iの配列要素に対応する節の左側の子の配列要素の要素番号 2×i+1 を計算して返却する。
②整数型:rchild(整数型:i)
要素番号iの配列要素に対応する節の右側の子の配列要素の要素番号 2×i+2 を計算して返却する。
③整数型:parent(整数型:i)
要素番号iの配列要素に対応する節の親の配列要素の要素番号(i-1)÷2(小数点以下切捨て)を計算して返却する。
(5) 副プログラム swap は,二つの配列要素に格納されている値を交換する。
(6) 副プログラム makeHeap の引数の仕様を表1に,副プログラム swap の引数の仕様を表2に示す。
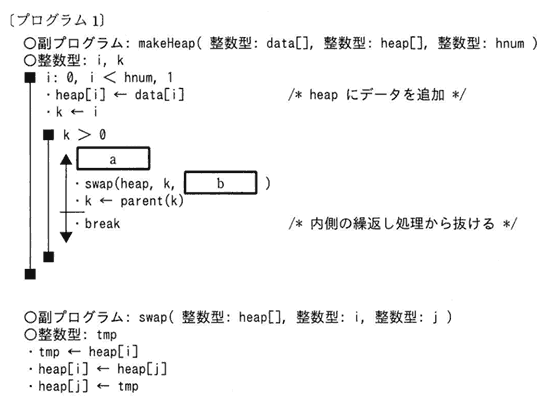
設問1 プログラム1中の [ ] に入れる正しい答えを,解答群の中から選べ。
aに関する解答群
bに関する解答群
設問2 〔プログラム2の動作〕の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
〔プログラム2の説明〕
(1) 副プログラム heapSort は,最初に副プログラム makeHeap を使って,配列 heap にデータを格納する。配列 heap は,整列対象領域と整列済みデータ領域に分かれている(図3参照)。last は,整列対象領域の最後の配列要素の要素番号を示している。最初は,配列 heap 全体が整列対象領域であり,このとき last の値は hnum-1 である。
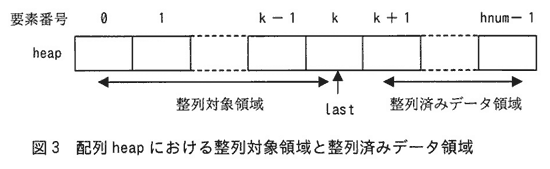
(2) 整列対象領域がヒープの性質を満たすとき,配列要素 heap[0] の値は,この領域での最大の値となっている。そこで,配列要素 heap[0] の値と配列要素 heap[last] の値を交換し,last の値を1減らして,整列対象領域の範囲を狭め,整列済みデータ領域を広げる。値の交換によって,整列対象領域はヒープの性質を満たさなくなるので,副プログラム downHeap を使って,整列対象領域のデータがヒープの性質を満たすように再構成する。これを繰り返すことによって,整列済みデータ領域には昇順に整列されたデータが格納されることになる。
(3) 副プログラム heapSort の引数の仕様を表3に,副プログラム heapSort で使用する副プログラム downHeap の引数の仕様を表4に示す。
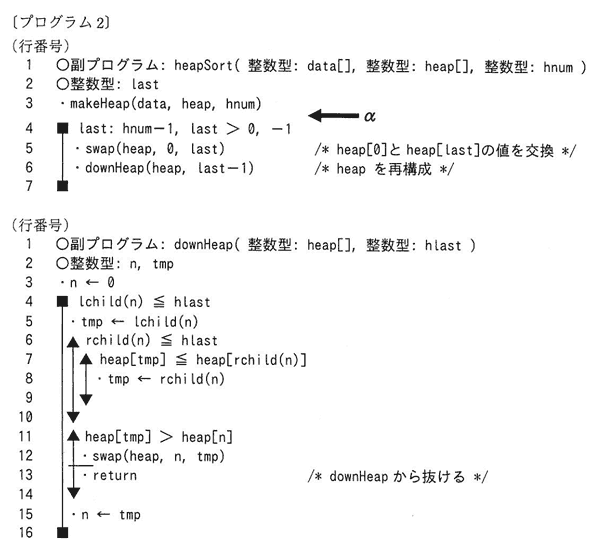
〔プログラム2の動作〕
副プログラム heapSort の行番号3の実行が終了した直後のαにおける配列 heap の内容は,図2のとおりであった。このとき,副プログラム heapSort の行番号4から行番号7までの1回目の繰返し処理について考える。
副プログラム heapSort の行番号5の副プログラム swap の実行が終了した直後の配列要素 heap[0] の値は,[ c ] となる。このため,配列 heap の要素番号0から hnum-2 までのデータは,根に対応する配列要素 heap[0] が最大の値をもつというヒープの性質を満たさなくなる。
副プログラム heapSort の行番号6で呼び出している副プログラム downHeap は,配列 heap の整列対象領域の要素番号0から hlast までのデータがヒープの性質を満たすように,その領域のデータを次の手順で再構成する。
(1) 配列要素の値の大きさを比較する際に使用する要素番号をnとし,nの初期値を0とする。
(2) 要素番号nの配列要素に対応する節の左側の子の要素番号を tmp に代入する。要素番号nの子が二つあり(rchild(n) ≦ hlast),右側の子の値が左側の子の値 [ d ],右側の子の要素番号を tmp に代入する。
(3) 子に対応する配列要素 heap[tmp] の値と,その親に対応する配列要素 heap[n] の値とを比較し,配列要素 heap[tmp] の値が大きければ,配列要素 heap[n] の値と配列要素 heap[tmp] の値を交換し,tmp を次のnとして(2)に戻る。ここで,副プログラム downHeap の行番号15において最初にnに代入する tmp の値は,[ e ] である。
cに関する解答群
dに関する解答群
eに関する解答群
ヒープの性質を利用して,データを昇順に整列するアルゴリズムを考える。ヒープは二分木であり,本問では,親は一つ又は二つの子をもち,親の値は子の値よりも常に大きいか等しいという性質をもつものとする。ヒープの例を図1に示す。図1において,丸は節を,丸の中の数値は各節が保持する値を表す。子をもつ節を,その子に対する親と呼ぶ。親をもたない節を根と呼び,根は最大の値をもつ。
〔プログラム1の説明〕
(1) 配列の要素番号は,0から始まる。
(2) 副プログラム makeHeap は,整数型の1次元配列 data に格納されている hnum 個(hnum>0)のデータを,次の①~③の規則で整数型の1次元配列 heap に格納して,ヒープを配列で実現する。この状態を, “配列 heap は,ヒープの性質を満たしている” という。
① 配列要素 heap[i](i=0,1,2,…)は,節に対応する。配列要素 heap[i] には,節が保持する値を格納する。
② 配列要素 heap[0] は,根に対応する。
③ 配列要素 heap[i](i=0,1,2,…)に対応する節の左側の子は配列要素 heap[2×i+1] に対応し,右側の子は配列要素 heap[2×i+2] に対応する。子が一つの場合,左側の子として扱う。
(3) 図1のヒープの例に対応した配列heapの内容を,図2に示す。
(4) 親の要素番号と子の要素番号を関係付ける三つの関数がある。
①整数型:lchild(整数型:i)
要素番号iの配列要素に対応する節の左側の子の配列要素の要素番号 2×i+1 を計算して返却する。
②整数型:rchild(整数型:i)
要素番号iの配列要素に対応する節の右側の子の配列要素の要素番号 2×i+2 を計算して返却する。
③整数型:parent(整数型:i)
要素番号iの配列要素に対応する節の親の配列要素の要素番号(i-1)÷2(小数点以下切捨て)を計算して返却する。
(5) 副プログラム swap は,二つの配列要素に格納されている値を交換する。
(6) 副プログラム makeHeap の引数の仕様を表1に,副プログラム swap の引数の仕様を表2に示す。
| 引数 | データ型 | 入出力 | 説明 |
| data[] | 整数型 | 入力 | データが格納されている1次元配列 |
| heap[] | 整数型 | 出力 | ヒープの性質を満たすようにデータを格納する1次元配列 |
| hnum | 整数型 | 入力 | データの個数 |
設問1 プログラム1中の [ ] に入れる正しい答えを,解答群の中から選べ。
aに関する解答群
| ア | heap[k] > heap[lchild(k)] |
|---|---|
| イ | heap[k] > heap[parent(k)] |
| ウ | heap[k] > heap[rchild(k)] |
| エ | heap[k] < heap[lchild(k)] |
| オ | heap[k] < heap[parent(k)] |
| カ | heap[k] < heap[rchild(k)] |
bに関する解答群
| ア | heap[hnum-1] |
|---|---|
| イ | heap[k] |
| ウ | parent(hnum-1) |
| エ | parent(k) |
設問2 〔プログラム2の動作〕の記述中の [ ] に入れる正しい答えを,解答群の中から選べ。
〔プログラム2の説明〕
(1) 副プログラム heapSort は,最初に副プログラム makeHeap を使って,配列 heap にデータを格納する。配列 heap は,整列対象領域と整列済みデータ領域に分かれている(図3参照)。last は,整列対象領域の最後の配列要素の要素番号を示している。最初は,配列 heap 全体が整列対象領域であり,このとき last の値は hnum-1 である。
(2) 整列対象領域がヒープの性質を満たすとき,配列要素 heap[0] の値は,この領域での最大の値となっている。そこで,配列要素 heap[0] の値と配列要素 heap[last] の値を交換し,last の値を1減らして,整列対象領域の範囲を狭め,整列済みデータ領域を広げる。値の交換によって,整列対象領域はヒープの性質を満たさなくなるので,副プログラム downHeap を使って,整列対象領域のデータがヒープの性質を満たすように再構成する。これを繰り返すことによって,整列済みデータ領域には昇順に整列されたデータが格納されることになる。
(3) 副プログラム heapSort の引数の仕様を表3に,副プログラム heapSort で使用する副プログラム downHeap の引数の仕様を表4に示す。
| 引数 | データ型 | 入出力 | 説明 |
| data[] | 整数型 | 入力 | 整列対象のデータが格納されている1次元配列 |
| heap[] | 整数型 | 出力 | 整列済みのデータを格納する1次元配列 |
| hnum | 整数型 | 入力 | データの個数 |
| 引数 | データ型 | 入出力 | 説明 |
| heap[] | 整数型 | 入力/出力 | 整列対象のデータを格納する1次元配列 |
| hlast | 整数型 | 入力 | 整列対象領域の最後の要素番号 |
〔プログラム2の動作〕
副プログラム heapSort の行番号3の実行が終了した直後のαにおける配列 heap の内容は,図2のとおりであった。このとき,副プログラム heapSort の行番号4から行番号7までの1回目の繰返し処理について考える。
副プログラム heapSort の行番号5の副プログラム swap の実行が終了した直後の配列要素 heap[0] の値は,[ c ] となる。このため,配列 heap の要素番号0から hnum-2 までのデータは,根に対応する配列要素 heap[0] が最大の値をもつというヒープの性質を満たさなくなる。
副プログラム heapSort の行番号6で呼び出している副プログラム downHeap は,配列 heap の整列対象領域の要素番号0から hlast までのデータがヒープの性質を満たすように,その領域のデータを次の手順で再構成する。
(1) 配列要素の値の大きさを比較する際に使用する要素番号をnとし,nの初期値を0とする。
(2) 要素番号nの配列要素に対応する節の左側の子の要素番号を tmp に代入する。要素番号nの子が二つあり(rchild(n) ≦ hlast),右側の子の値が左側の子の値 [ d ],右側の子の要素番号を tmp に代入する。
(3) 子に対応する配列要素 heap[tmp] の値と,その親に対応する配列要素 heap[n] の値とを比較し,配列要素 heap[tmp] の値が大きければ,配列要素 heap[n] の値と配列要素 heap[tmp] の値を交換し,tmp を次のnとして(2)に戻る。ここで,副プログラム downHeap の行番号15において最初にnに代入する tmp の値は,[ e ] である。
cに関する解答群
| ア | 5 |
|---|---|
| イ | 10 |
| ウ | 15 |
| エ | 20 |
dに関する解答群
| ア | 以下のときには |
|---|---|
| イ | 以上のときには |
| ウ | よりも大きいときには |
| エ | よりも小さいときには |
eに関する解答群
| ア | 1 |
|---|---|
| イ | 2 |
| ウ | 3 |
| エ | 4 |
| オ | 5 |
| カ | 6 |
答え : 設問1 (a)イ (b)エ 設問2 (c)エ (d)イ (e)イ
分野 : テクノロジ系 › 基礎理論 › アルゴリズムとプログラミング › アルゴリズム
分野 : テクノロジ系 › 基礎理論 › アルゴリズムとプログラミング › アルゴリズム
 共有ボタンをタップ